Bài viết
Bài viết cá nhân
Benchmark bí mật phơi bày khoảng cách thật giữa AI mở và AI đóng
👤 cuongnguyen📅 04/11/2026⏱ 6 phút đọc
Tin chính là gì?
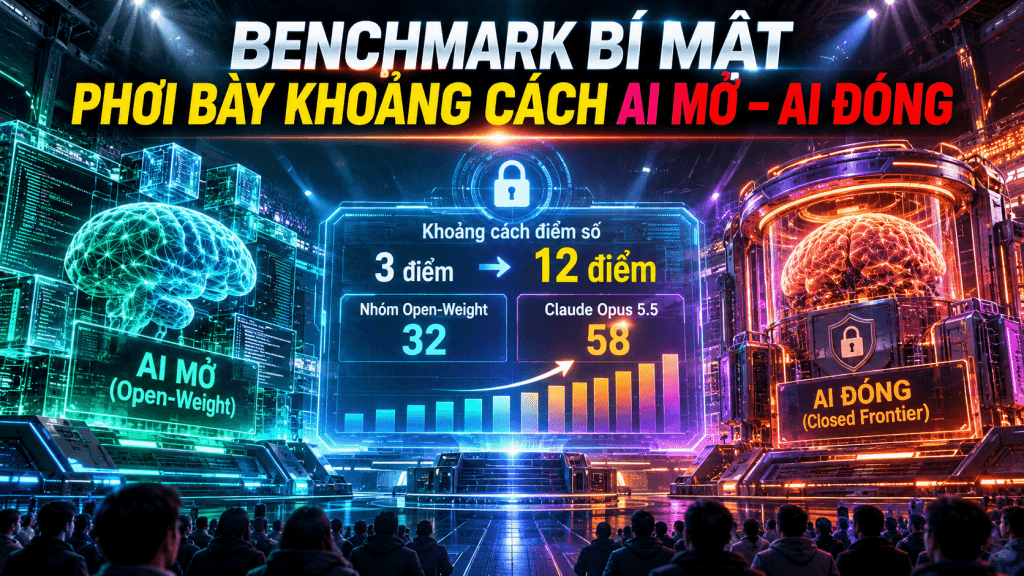
Artificial Analysis, đơn vị đánh giá AI độc lập, vừa đại tu Intelligence Index v5 bằng một thay đổi gây chấn động: nhiều bài kiểm tra được giữ bí mật. Theo phân tích của Business Insider, mục tiêu là ngăn các hãng AI huấn luyện mô hình để tối ưu trực tiếp cho bộ đề công khai — hành vi thường bị gọi là benchmark hacking.
Kết quả đảo chiều đáng kể. Với hệ thống cũ, các mô hình open-weight mạnh nhất chỉ kém nhà dẫn đầu 3 điểm. Sang Index v5, chênh lệch nới lên 12 điểm. Nhóm dẫn đầu trong thế giới trọng số công khai đạt 32 điểm, trong khi Claude Opus 5.5 của Anthropic dẫn đầu toàn bảng với 58 điểm. Ngay cả Claude Haiku 5.5, một model nhỏ hơn, cũng vượt toàn bộ nhóm open-weight.
Moonshot Kimi K3.1 Pro nằm trong nhóm open-weight bị kéo giãn khoảng cách này. Điều đó làm suy yếu câu chuyện quen thuộc rằng AI mở, đặc biệt từ Trung Quốc, đã gần bắt kịp tuyệt đối các model đóng của OpenAI và Anthropic.
Vì sao đáng chú ý?
Benchmark công khai là con dao hai lưỡi. Nó giúp cộng đồng tái lập kết quả, so sánh model nhanh và thúc đẩy nghiên cứu. Nhưng khi bộ câu hỏi, dạng bài hoặc tiêu chí chấm quá dễ dự đoán, đội huấn luyện có thể vô tình hoặc chủ động “dạy đúng đề”. Model đạt điểm cao hơn mà chưa chắc xử lý tốt yêu cầu lạ của khách hàng.
Sridhar Ramaswamy, CEO Snowflake, chốt rất gọn trên X: ngày benchmark chuyển sang private, khoảng cách open model đi từ 3 lên 12 điểm. Câu hỏi ông đặt ra đáng giá hơn chính con số: mô hình mở thực sự bắt kịp, hay dữ liệu kiểm tra đã bị rò rỉ vào quá trình tối ưu?
Nathan Lambert từ Trillium Labs nhận định chỉ số cũ đã ưu ái open-weight quá mức. Đây chưa phải phán quyết cuối cùng về năng lực thực tế; chính Business Insider cũng lưu ý đây trước hết là câu chuyện về phương pháp đo. Dù vậy, nó buộc thị trường thôi đồng nhất “điểm benchmark cao” với “độ tin cậy cao khi triển khai”.

Tác động thực chiến
Đội kỹ thuật cần đổi cách mua và đánh giá LLM. Đừng chọn model vì một bảng xếp hạng hoặc một demo code chạy đẹp. Hãy dùng benchmark bên thứ ba như tín hiệu sàng lọc, sau đó kiểm tra bằng tập dữ liệu nội bộ chưa từng xuất hiện trên Internet hay tài liệu fine-tuning.
- Với AI Agent: đo tỷ lệ hoàn thành tác vụ đa bước, khả năng dùng tool, mức phục hồi khi API lỗi và tỷ lệ cần con người can thiệp.
- Với lập trình: chấm trên issue, codebase, test suite và quy ước review thật của doanh nghiệp; không chỉ đo bài toán thuật toán độc lập.
- Với dữ liệu nhạy cảm: open-weight vẫn có lợi thế kiểm soát, tự host và khả năng tối ưu chi phí, đặc biệt khi yêu cầu data residency rõ ràng.
Đừng cực đoan hóa kết luận. Lambert vẫn cho rằng open-weight cạnh tranh mạnh ở phát triển phần mềm. Dữ liệu OpenRouter cũng không đại diện toàn bộ thị trường, dù Dax Raad ước tính lưu lượng DeepSeek qua nền tảng này trong một ngày có thể phục vụ bằng một rack Nvidia trị giá khoảng 6–7 triệu USD. Ngược lại, hơn 1 tỷ người dùng ChatGPT hàng tháng cho thấy nhu cầu đại chúng vẫn tập trung mạnh ở các nhà cung cấp đóng.
Cường Nguyễn nhận định
Index v5 là cú sửa sai cần thiết cho ngành benchmark. Tôi đánh giá cao việc Artificial Analysis chấp nhận hy sinh một phần tính minh bạch của đề thi để bảo vệ tính đại diện của phép đo. Một benchmark công khai hoàn toàn nhưng bị tối ưu đến mức mất năng lực phân biệt thì minh bạch chỉ còn là hình thức.
Tuy nhiên, khoảng cách 12 điểm không phải giấy phép để doanh nghiệp quay lưng với open-weight. Sai lầm lớn nhất là thay câu thần chú “AI mở đã bắt kịp” bằng “AI đóng luôn thắng”. Hai nhóm model phục vụ hai bài toán khác nhau: frontier performance, tốc độ phát hành và trải nghiệm API ở một phía; quyền kiểm soát, khả năng triển khai riêng và economics ở phía còn lại.
Khuyến nghị cụ thể cho kỹ sư và founder: hãy lập một eval set riêng gồm 100 tác vụ đã ẩn đáp án, lấy từ log công việc đã được làm sạch dữ liệu nhạy cảm. Chạy cùng prompt, cùng tool policy và cùng tiêu chí chi phí trên ít nhất một model đóng lẫn một model open-weight. Chỉ ký hợp đồng hoặc khóa kiến trúc sau khi đo tỷ lệ hoàn thành, lỗi nghiêm trọng, latency và chi phí mỗi tác vụ thành công.
Câu hỏi thường gặp
Benchmark private có đáng tin hơn benchmark công khai không?
Private benchmark khó bị “học thuộc” hơn nên hữu ích để đo khả năng tổng quát hóa. Nhưng nó không mặc nhiên hoàn hảo: cộng đồng khó tái lập đầy đủ kết quả. Cách đáng tin nhất là kết hợp benchmark độc lập với eval nội bộ theo workflow thật.
Open-weight có còn là lựa chọn tốt cho doanh nghiệp?
Có, nếu doanh nghiệp cần tự host, kiểm soát dữ liệu, tùy chỉnh sâu hoặc tối ưu chi phí ở tải lớn. Nhưng cần chứng minh chất lượng bằng bài kiểm tra riêng, thay vì suy luận từ vị trí trên leaderboard.
Claude Haiku 5.5 vượt open-weight nói lên điều gì?
Nó cho thấy kích thước model hay trạng thái đóng/mở không tự quyết định chất lượng. Với Index v5, một model nhỏ hơn của Anthropic vẫn xử lý tốt hơn toàn bộ nhóm trọng số công khai trên phép đo này.
Nguồn tham khảo: Business Insider
Tác giả: Cường Nguyễn — Founder AI Ops Solutions | Verified n8n Creator. Kết nối: Facebook · LinkedIn · YouTube · TikTok
Bài viết là góc nhìn cá nhân của tác giả, mang tính tham khảo — không phải tin tức báo chí.
📬 Nhận bài viết mới — miễn phí
Đừng bỏ lỡ bài viết tiếp theo. Đăng ký để nhận trong inbox.
Tác giả
Cường Nguyễn — AI Thực Chiến
Tôi là Cường Nguyễn - Founder của AI Ops Solutions.
Tôi từng là Logistics Operations Manager và đồng sáng lập thương hiệu CATCA - #1 Shopee ngành Pet Care.
10 năm kinh nghiệm Logistics/E-commerce OperationsCo-founder CATCA - #1 Shopee ngành Pet CareMột trong 300+ n8n Verified Creator toàn cầuTư vấn Giải pháp chuyển đổi số bằng AI cho 3 SMEs/quý


