Bài viết
Bài viết cá nhân
Muse Glimmer 30B: nhỏ nhưng chưa đủ tin cậy cho agent
👤 cuongnguyen📅 12/08/2026⏱ 5 phút đọc
Tin chính là gì?
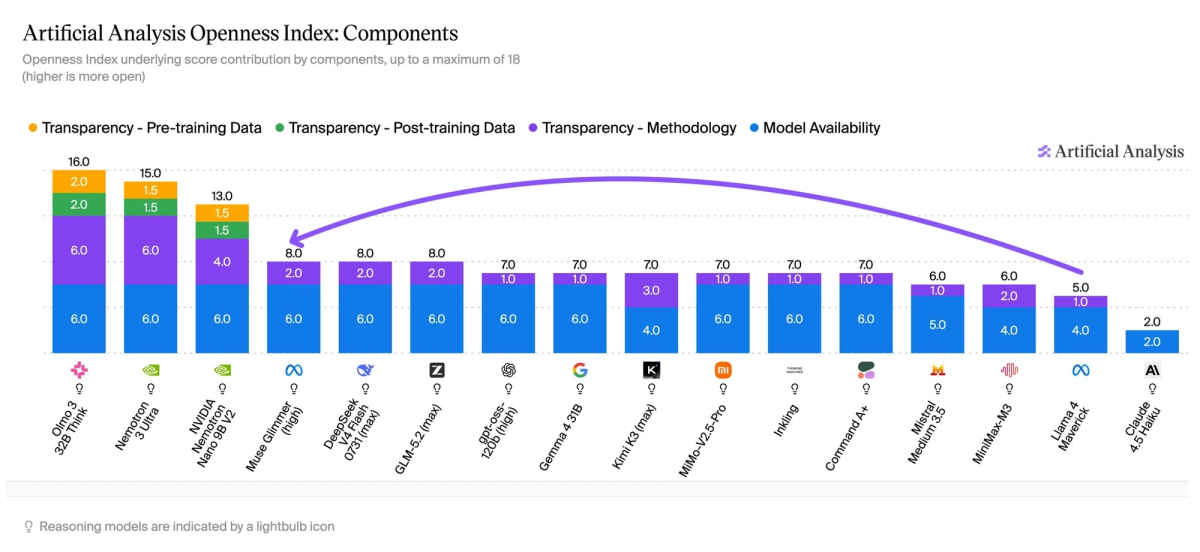
Meta Muse Glimmer 30B đang gây chú ý không phải vì dẫn đầu mọi bảng xếp hạng, mà vì tỷ lệ hiệu năng trên số tham số. Theo đánh giá ngày 10/08/2026 của Artificial Analysis, model này đạt 35 điểm trên Artificial Analysis Intelligence Index. Con số đó thấp hơn Qwen3.6 27B và Ling 3.0 Flash, cùng ở mức 38 điểm, nhưng vượt Gemma 4 31B Reasoning với 30 điểm và đứng gần nhóm Kimi K2.5 Reasoning ở mốc 36 điểm.
Điểm cần đọc đúng là Intelligence Index là benchmark tổng hợp, không phải giấy chứng nhận rằng một model sẽ làm tốt mọi công việc. Với chỉ khoảng 30 tỷ tham số, Muse Glimmer tiệm cận một số năng lực của Kimi K2.5, vốn có tổng quy mô được công bố tới 1 nghìn tỷ tham số. Tuy nhiên, khi chuyển sang các bài test agentic — nơi AI phải lập kế hoạch, dùng terminal và hoàn thành chuỗi tác vụ — khoảng cách của Muse Glimmer lộ rõ.
Vì sao đáng chú ý?
Đây là ví dụ điển hình cho xu hướng AI “đủ nhỏ để sở hữu, đủ mạnh để triển khai”. Ở định dạng lượng tử hóa 4-bit, Muse Glimmer cần khoảng 18GB bộ nhớ, mở ra khả năng chạy cục bộ trên máy trạm GPU thay vì phải đưa toàn bộ dữ liệu lên API đám mây. Với doanh nghiệp xử lý tài liệu nội bộ, mã nguồn nhạy cảm hoặc dữ liệu khách hàng, quyền kiểm soát này có giá trị thực tế.
Muse Glimmer cũng cho thấy một benchmark cao không đồng nghĩa model sẽ là agent đáng tin cậy. Ở Tau3-Banking, bài kiểm tra sử dụng công cụ trong bối cảnh ngân hàng, model đạt 24%, vượt Gemini 3.5 Flash-Lite với 18% và Qwen3.6 27B với 17%. Nhưng ở các thước đo agent phức tạp hơn, kết quả lại kém thuyết phục: GDPval-AA v2 đạt 953 Elo, thấp hơn mức 1.141 Elo của Qwen3.6 27B và Gemini 3.5 Flash-Lite.
Tác động thực chiến
Muse Glimmer phù hợp nhất cho chatbot tri thức nội bộ, trợ lý đọc hiểu tài liệu, tác vụ đa phương thức có kiểm soát và hỗ trợ coding theo từng phiên ngắn. Với workload này, lợi thế local giúp giảm độ trễ dữ liệu, kiểm soát chi phí theo thời gian và tránh phụ thuộc hoàn toàn vào một nhà cung cấp API. Bản 4-bit khoảng 18GB là ngưỡng hấp dẫn cho máy có GPU mạnh; còn vận hành BF16 với context 128K có thể cần khoảng 60GB bộ nhớ, đòi hỏi hạ tầng cao hơn đáng kể.
Ngược lại, không nên giao cho model quyền tự vận hành các quy trình doanh nghiệp quan trọng chỉ vì nó có điểm tổng hợp tốt. Muse Glimmer đạt 52% ở Terminal-Bench v2.1, dưới 61% của Qwen3.6 27B. Đáng ngại hơn, tỷ lệ hallucination được Artificial Analysis ghi nhận là 82%, so với 49% của Qwen3.6 27B. Điều này có nghĩa agent có thể tự tin đưa ra bước xử lý, câu lệnh hoặc kết luận sai trong những tình huống thiếu dữ kiện.
Nếu cần một agent coding hay tự động hóa nhiều bước, đội kỹ thuật nên benchmark trực tiếp Muse Glimmer với dữ liệu và công cụ của mình. Cần đặt giới hạn quyền truy cập, bắt buộc xác thực đầu ra, dùng RAG cho dữ liệu nguồn và giữ con người trong vòng kiểm duyệt đối với các thao tác có tác động thật.
Cường Nguyễn nhận định
Muse Glimmer 30B đáng chú ý nhất ở hiệu quả tham số, không phải ở vị thế model toàn năng. Một model khoảng 30B có thể tiếp cận mặt bằng benchmark của các hệ lớn hơn rất nhiều là tín hiệu tích cực cho làn sóng AI private, self-hosted và tối ưu chi phí. Nhưng các con số agentic nhắc chúng ta rằng “thông minh” và “đáng tin để tự làm việc” là hai tiêu chuẩn khác nhau.
Với doanh nghiệp, lựa chọn hợp lý không phải là hỏi model nào đứng hạng cao hơn, mà là workload nào cần tối ưu. Muse Glimmer có thể là lựa chọn hấp dẫn cho tác vụ nội bộ cần dữ liệu tại chỗ. Còn các luồng nghiệp vụ cần độ chính xác, xử lý terminal hoặc ra quyết định tự động, Qwen3.6 27B đang cho thấy lợi thế rõ hơn trên các benchmark được nêu. Hãy mua năng lực phù hợp với rủi ro, thay vì mua một con số tổng hợp đẹp.
Câu hỏi thường gặp
Muse Glimmer 30B có mạnh hơn Gemma 4 31B Reasoning không?
Trên Artificial Analysis Intelligence Index, Muse Glimmer đạt 35 điểm, cao hơn 30 điểm của Gemma 4 31B Reasoning. Tuy vậy, kết quả này không thay thế benchmark riêng cho coding, agent hoặc dữ liệu tiếng Việt.
Vì sao Muse Glimmer có Intelligence Index tốt nhưng agentic vẫn yếu?
Benchmark tổng hợp đo nhiều năng lực khác nhau, trong khi agentic đòi hỏi lập kế hoạch nhiều bước, gọi công cụ, tự kiểm tra lỗi và giữ ngữ cảnh ổn định. Điều này phản ánh qua GDPval-AA v2 953 Elo, Terminal-Bench 52% và hallucination 82%.
Muse Glimmer 30B có chạy được trên máy cá nhân không?
Có thể, nếu dùng bản lượng tử hóa 4-bit cần khoảng 18GB bộ nhớ. Nhưng chạy BF16 cùng context 128K có thể cần khoảng 60GB, phù hợp hơn với workstation hoặc hạ tầng chuyên dụng.
Nguồn tham khảo: Muse Glimmer 30B mạnh đến đâu khi so với AI hàng đầu?
Bài viết là góc nhìn cá nhân của tác giả, mang tính tham khảo — không phải tin tức báo chí.
📬 Nhận bài viết mới — miễn phí
Đừng bỏ lỡ bài viết tiếp theo. Đăng ký để nhận trong inbox.

Tác giả
Cường Nguyễn — AI Thực Chiến
Tôi là Cường Nguyễn - Founder của AI Ops Solutions.
Tôi từng là Logistics Operations Manager và đồng sáng lập thương hiệu CATCA - #1 Shopee ngành Pet Care.
10 năm kinh nghiệm Logistics/E-commerce OperationsCo-founder CATCA - #1 Shopee ngành Pet CareMột trong 300+ n8n Verified Creator toàn cầuTư vấn Giải pháp chuyển đổi số bằng AI cho 3 SMEs/quý