Bài viết
Bài viết cá nhân
Ornith-1.5: AI mã mở tự tạo bài toán
👤 cuongnguyen📅 20/08/2026⏱ 5 phút đọc
Tin chính là gì?
Theo TestingCatalog, nhóm DeepReinforce đã phát hành gia đình mô hình mã nguồn mở Ornith-1.5 trong ngày 19-20/08/2026. Dòng này có ba bản chính: flagship 397B MoE, bản 35B MoE và 9B Dense. Bản 35B chỉ kích hoạt khoảng 3B tham số mỗi token, hỗ trợ context 256K. Bản 9B có thêm phiên bản quantized Ornith-1.5-9B-Mobile cho Android và iOS.
Điểm đáng bàn không nằm ở việc thêm một LLM mã mở vào danh sách vốn đã dài. DeepReinforce nói Ornith-1.5 dùng một vòng lặp tự cải tiến khép kín: model tự đề xuất bài toán, tự tạo task-specific scaffold gồm công cụ và chiến lược xử lý, rồi chạy rollouts để học bằng GRPO. Cách làm này giảm sự lệ thuộc vào tập task do con người tuyển chọn sẵn. Các model đã có trên Hugging Face và Ollama.
Vì sao đáng chú ý?
Huấn luyện AI bằng dữ liệu tổng hợp thường vấp một căn bệnh quen thuộc: model tự tạo bài quá dễ, tự chấm điểm lỏng, rồi học cách lấy điểm thay vì học cách giải quyết vấn đề. Ornith-1.5 cố xử lý trực diện điểm yếu ấy bằng reward gồm ba lớp. Validity gate kiểm tra môi trường và chặn reward hacking; frontier difficulty nhắm task có tỷ lệ pass 20%; novelty buộc hệ thống tìm bài toán mới.
Đây là thiết kế có lý hơn kiểu quảng cáo “AI tự học” mơ hồ. Mốc 20% tạo áp lực vừa đủ: task không dễ đến mức vô nghĩa, cũng chưa bất khả thi đến mức rollouts chỉ là đống thất bại. Dĩ nhiên, validity gate mạnh đến đâu vẫn là câu hỏi phải kiểm chứng qua việc triển khai độc lập, không thể chỉ tin vào mô tả kỹ thuật.
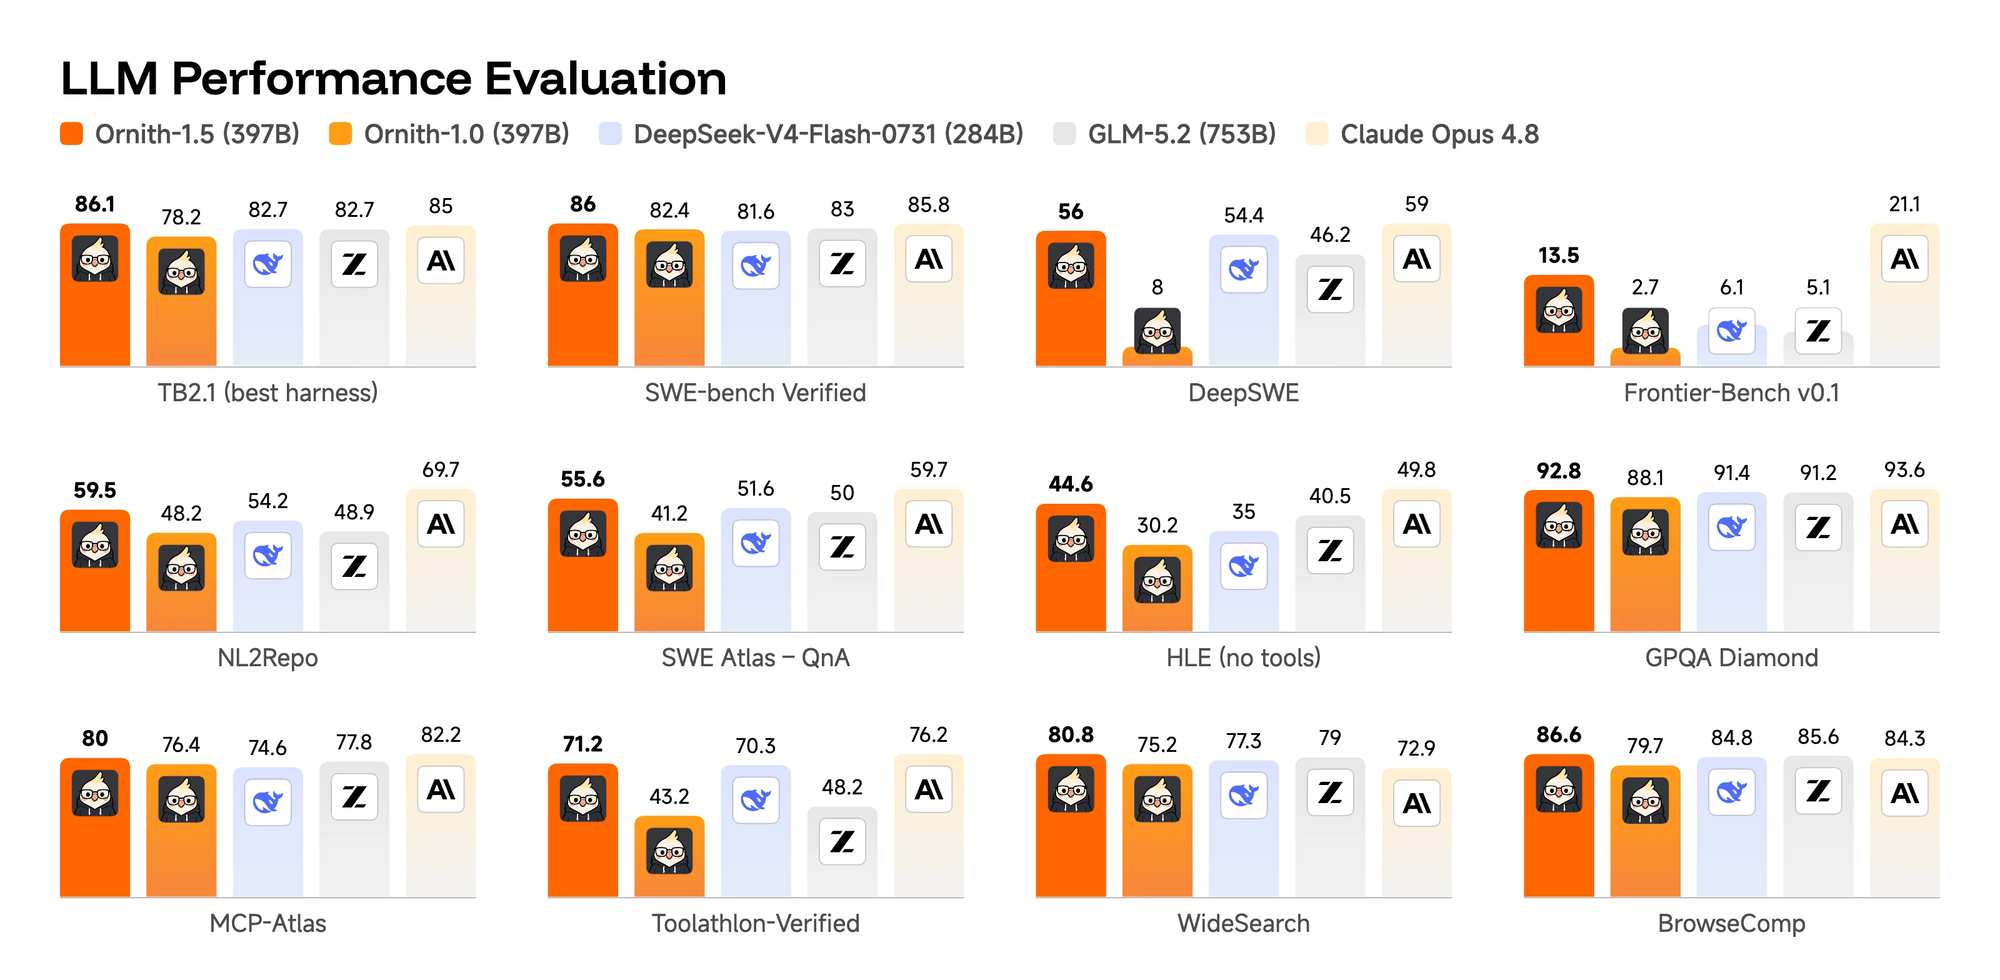
Benchmark hiện khá ấn tượng. Ornith-1.5-397B đạt 85,1 ở Terminal-Bench 2.1, 56,0 ở DeepSWE, 92,8 ở GPQA Diamond và 86,6 ở BrowseComp. Điểm Terminal-Bench gần với Claude Opus 4.8 ở mức 85,0, dù DeepSWE của Opus là 59,0. Bản 35B đạt 68,5 Terminal-Bench và 79,0 SWE-Bench Verified; bản 9B lần lượt đạt 47,0 và 70,6, vượt các đối thủ được nêu là Gemma 4-31B và Qwen 3.6-35B.
Tác động thực chiến
Với đội ngũ làm Coding Agent, bản 35B-A3B đáng thử hơn flagship 397B. Kiến trúc MoE có 3B active params mỗi token hứa hẹn hiệu quả suy luận tốt hơn việc mang một dense model lớn vào mọi request. Context 256K cũng phù hợp cho các tác vụ đọc codebase, tổng hợp log, rà soát thay đổi nhiều file và xử lý tài liệu kỹ thuật dài.
Tuy vậy, đừng biến benchmark thành quyết định mua hạ tầng. Terminal-Bench và SWE-Bench Verified là tín hiệu tốt cho năng lực agent, nhưng sản phẩm thật còn phụ thuộc tool calling, quyền truy cập repo, sandbox, retry policy và chất lượng test nội bộ. Một agent giỏi benchmark vẫn có thể gây rối nếu scaffold của doanh nghiệp yếu hoặc cho phép nó đụng production quá sớm.
Bản 9B Mobile mở ra hướng thực dụng hơn: trợ lý chạy cục bộ cho các tác vụ có dữ liệu nhạy cảm. Đây chưa phải giấy phép để nhét mọi quy trình vào điện thoại. Giá trị hợp lý nằm ở phân loại, truy xuất, tóm tắt tài liệu đã cho phép và hỗ trợ thao tác ngắn khi cần giảm phụ thuộc API bên ngoài.
Cường Nguyễn nhận định
Tôi đánh giá cao Ornith-1.5 vì họ nhắm đúng nút thắt của AI mã mở: thiếu task huấn luyện chất lượng và thiếu cơ chế chống model tự đánh lừa chính mình. Việc khóa reward bằng validity gate rồi kéo độ khó về vùng pass 20% nghe nghiêm túc hơn nhiều lời hứa về “tự tiến hóa”. DeepReinforce đang đưa trọng tâm từ kích thước model sang chất lượng vòng lặp học, và đó là hướng đáng khen.
Nhưng tôi chưa vội gọi đây là cuộc lật đổ Claude hay các model đóng. Khoảng cách benchmark với vận hành production rất rộng, nhất là ở DeepSWE khi Ornith-1.5-397B vẫn thấp hơn Claude Opus 4.8. Khuyến nghị cụ thể: đội kỹ thuật hãy dựng một pilot 2 tuần với Ornith-1.5-35B, chấm trên 30-50 issue và pull request đã đóng của chính repo mình, đo tỷ lệ pass test, số lần can thiệp của người và chi phí mỗi tác vụ trước khi thay API hiện tại.
Câu hỏi thường gặp
Ornith-1.5 có thể tải ở đâu?
DeepReinforce đã đưa các model lên Hugging Face và Ollama. Người dùng nên chọn đúng biến thể 397B, 35B-A3B hoặc 9B theo hạ tầng và mục tiêu triển khai.
Bản nào phù hợp để thử nghiệm Coding Agent?
Bản 35B MoE là lựa chọn cân bằng đáng chú ý nhờ chỉ kích hoạt khoảng 3B tham số mỗi token, context 256K và kết quả 79,0 trên SWE-Bench Verified. Bản 9B phù hợp hơn cho thử nghiệm cục bộ, nhẹ và ưu tiên mobile.
Cơ chế tự tạo task có loại bỏ hoàn toàn reward hacking không?
Không có cơ sở để khẳng định loại bỏ hoàn toàn. Ornith-1.5 dùng validity gate để chặn reward hacking theo mô tả công bố. Hiệu quả thực tế cần được kiểm tra bằng benchmark độc lập và workload riêng của từng tổ chức.
Nguồn tham khảo: TestingCatalog
Bài viết là góc nhìn cá nhân của tác giả, mang tính tham khảo — không phải tin tức báo chí.
📬 Nhận bài viết mới — miễn phí
Đừng bỏ lỡ bài viết tiếp theo. Đăng ký để nhận trong inbox.

Tác giả
Cường Nguyễn — AI Thực Chiến
Tôi là Cường Nguyễn - Founder của AI Ops Solutions.
Tôi từng là Logistics Operations Manager và đồng sáng lập thương hiệu CATCA - #1 Shopee ngành Pet Care.
10 năm kinh nghiệm Logistics/E-commerce OperationsCo-founder CATCA - #1 Shopee ngành Pet CareMột trong 300+ n8n Verified Creator toàn cầuTư vấn Giải pháp chuyển đổi số bằng AI cho 3 SMEs/quý