Bài viết
Bài viết cá nhân
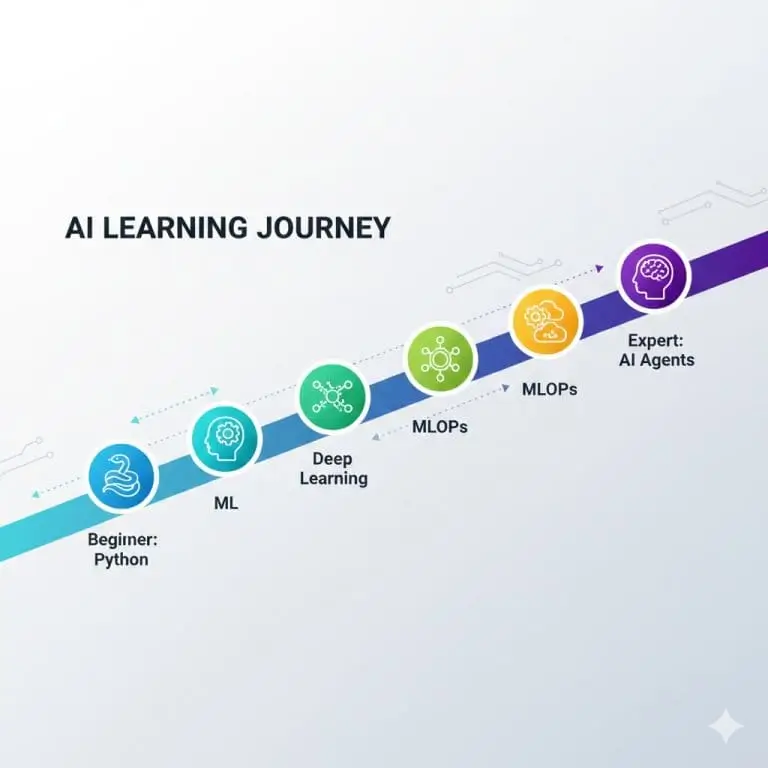
Roadmap Trở Thành AI Engineer 2026: Từ Zero đến Hero
👤 cuongnguyen📅 19/02/2026⏱ 24 phút đọc
Trong bài viết này(43 mục)⌄
- 1. AI Engineer 2026 thực sự làm gì? — roadmap AI engineer 2026 nhìn từ Production
- 2. 3 con đường vào nghề — chọn đúng con đường của bạn
- Path A: Career changer — khoảng 12 tháng
- Path B: Developer hoặc Data Professional — khoảng 6 tháng
- Path C: Sinh viên Computer Science
- 3. Giai đoạn 1 — Nền tảng roadmap AI engineer 2026, tuần 1-6
- Tuần 1-2: Python đủ để làm việc
- Tuần 3: Gọi LLM API
- Tuần 4: Prompt engineering và system prompt
- Tuần 5-6: Mini project
- 4. Giai đoạn 2 — RAG + Vector DB, tuần 7-12
- Pipeline RAG cần hiểu
- Chọn Vector DB nào?
- Project giai đoạn 2: Vietnamese Business Document Q&A
- 5. Giai đoạn 3 — AI Agents + MCP, tuần 13-18
- Agent thực chất là gì?
- MCP — Model Context Protocol
- Khi nào cần multi-agent?
- Project: Automated Reporting Agent
- 6. Giai đoạn 4 — Production + LLMOps + Eval, tuần 19-24
- Đưa ứng dụng lên Production
- Evaluation: kỹ năng bị người mới bỏ qua nhiều nhất
- Monitoring và chi phí ẩn
- Project cuối roadmap
- 7. Bảng kỹ năng 2026 — hiring thật sự cần gì trong roadmap AI engineer 2026
- 8. 5 project portfolio để xin việc — tăng dần độ khó
- 1. RAG Document Q&A Chatbot
- 2. Workflow Automation Agent bằng n8n
- 3. Eval + Monitoring System cho AI App
- 4. Multi-Agent Orchestration
- 5. Fine-tune một Small Model
- 9. Sai lầm người mới hay mắc — mất 3-6 tháng
- Học quá nhiều ML theory trước khi chạm API
- Nhảy model liên tục nhưng không hoàn thành project
- Bỏ qua evaluation
- Học theo skill list thay vì ordered path
- 10. Câu hỏi thường gặp về roadmap AI Engineer 2026
- Không biết Python có làm AI Engineer được không?
- Mất bao lâu từ Zero đến xin được việc?
- Học online miễn phí có đủ không?
- AI Engineer khác Prompt Engineer thế nào?
- 2026 có quá muộn để vào ngành AI không?
- Kết luận — bắt đầu roadmap AI Engineer 2026 từ hôm nay
Roadmap Trở Thành AI Engineer 2026: Từ Zero đến Hero
“Tôi muốn làm AI Engineer, nhưng không biết bắt đầu từ đâu.” Đây có lẽ là câu tôi nhận được nhiều nhất khi nói chuyện với developer, sinh viên, data analyst và cả những người đang muốn chuyển nghề sang AI.
Vấn đề không phải Internet thiếu tài liệu. Vấn đề là có quá nhiều roadmap: Python, toán, machine learning, deep learning, NLP, PyTorch, Transformer, RAG, agent, MLOps… Người mới nhìn danh sách đó rất dễ dành sáu tháng để “chuẩn bị học AI” nhưng chưa xây được một ứng dụng AI nào.
Roadmap AI engineer 2026 trong bài này đi theo hướng ngược lại. Đây không phải danh sách mọi thứ bạn có thể học, mà là thứ tự những gì tôi khuyên một người có khoảng sáu tháng nên học để đi từ Zero đến một hệ thống AI có thể đưa lên Production.
Điểm quan trọng nhất của phiên bản 2026: trọng tâm đã dịch chuyển từ “tự train model” sang xây dựng, tích hợp, đánh giá và vận hành hệ thống dùng LLM. RAG, agents, MCP, eval và LLMOps vì thế xuất hiện rất sớm trong roadmap.
1. AI Engineer 2026 thực sự làm gì? — roadmap AI engineer 2026 nhìn từ Production
Nếu bạn đọc mô tả nghề AI Engineer cách đây vài năm, hình ảnh thường là một kỹ sư huấn luyện model, tối ưu accuracy, làm feature engineering, chạy GPU và deploy model machine learning.
Công việc đó vẫn tồn tại. Nhưng đến 2026, một lớp công việc mới đã trở nên phổ biến hơn rất nhiều: Applied AI Engineering.
Thay vì hỏi “làm thế nào để train một language model?”, doanh nghiệp thường hỏi: “Làm thế nào để đưa GPT, Claude, Gemini hoặc open-source model vào quy trình thật của công ty mà vẫn chính xác, có kiểm soát và không đốt ngân sách?”
Một AI Engineer hiện đại vì vậy thường phải làm những việc như kết nối LLM API, xây RAG trên dữ liệu nội bộ, thiết kế tool calling, tạo agent workflow, quản lý context, triển khai backend API, theo dõi token cost, xây evaluation dataset và debug những trường hợp model trả lời sai.
| Vai trò | Trọng tâm chính | Công việc điển hình |
| AI Engineer | Xây sản phẩm và hệ thống dùng AI | LLM API, RAG, agent, MCP, eval, backend, production |
| Data Scientist | Phân tích dữ liệu và mô hình hóa | Thống kê, experiment, prediction, insight, ML models |
| ML Engineer | Đưa machine learning model vào Production | Training pipeline, serving, feature store, GPU, MLOps |
| Prompt Engineer | Tối ưu cách giao tiếp với model | Prompt design, templates, testing, structured instructions |
Ranh giới giữa các vị trí không tuyệt đối. Một công ty có thể gọi vị trí là AI Engineer nhưng yêu cầu nhiều ML. Công ty khác lại dùng tên Applied AI Engineer, GenAI Engineer hoặc Agent Engineer.
Điểm cần nhìn là JD yêu cầu bạn xây cái gì, không phải job title ghi thế nào.
Thị trường tuyển dụng Việt Nam năm 2026 cho thấy các JD AI ngày càng kết hợp LLM, RAG, API và AI Agent thay vì chỉ ML truyền thống. Các trang tuyển dụng hiện liệt kê từ hàng chục đến hàng trăm vị trí liên quan AI/ML tùy thời điểm, trong đó RAG và agent xuất hiện trực tiếp trong nhiều JD.
Về thu nhập, đừng coi bất kỳ con số nào là “lương chuẩn AI Engineer”. Theo báo cáo ITviec 2025-2026, các nhóm nghề data tại Việt Nam đã nằm trong nhóm kỹ thuật có mức thu nhập tương đối cao; Data Analyst/Data Scientist có median khoảng 40,65 triệu đồng/tháng, còn Data Engineer 3-4 năm kinh nghiệm khoảng 56,9 triệu đồng/tháng. Đây nên được xem là benchmark tham khảo cho thị trường kỹ thuật dữ liệu, không phải mức lương đảm bảo của AI Engineer.
Ở thị trường quốc tế, chênh lệch còn lớn hơn. Các benchmark total compensation cho AI Engineer tại Mỹ có thể lên tới sáu chữ số USD mỗi năm, nhưng không nên quy đổi trực tiếp sang mặt bằng Việt Nam.
Kết luận: đừng vào ngành AI chỉ vì nhìn một bảng lương. Hãy vào vì năng lực xây hệ thống AI đang trở thành một phần ngày càng quan trọng của software engineering.

2. 3 con đường vào nghề — chọn đúng con đường của bạn
Không tồn tại một roadmap phù hợp với tất cả mọi người. Người đã code backend ba năm không nên học giống một marketer chưa từng viết Python. Ngược lại, người mới hoàn toàn cũng không nên copy roadmap sáu tháng của senior developer rồi tự kết luận mình “không có tố chất”.
| Con đường | Thời gian tham khảo | Lợi thế | Cạm bẫy |
| Path A — Career changer | Khoảng 9-12 tháng | Hiểu domain kinh doanh cũ | Học framework AI trước nền tảng lập trình |
| Path B — Developer/Data | Khoảng 6 tháng | Có tư duy hệ thống, API hoặc dữ liệu | Học quá nhiều theory vì nghĩ AI phải bắt đầu từ toán |
| Path C — Sinh viên CS | Song song 1-2 năm học | Có thời gian xây nền tảng sâu | Chỉ học ở trường mà không ship project thực tế |
Path A: Career changer — khoảng 12 tháng
Nếu bạn chưa từng lập trình, sáu tháng thường quá gấp. Hãy cho mình khoảng 9-12 tháng. Ba tháng đầu nên tập trung vào Python, Git, HTTP, API, JSON, SQL và tư duy lập trình cơ bản.
Lợi thế bất ngờ của career changer là domain knowledge. Một người từng làm logistics có thể xây agent xử lý vận hành tốt hơn developer không hiểu logistics. Một người làm kế toán có thể thiết kế workflow kiểm tra hóa đơn tốt hơn người chỉ biết LangChain.
Path B: Developer hoặc Data Professional — khoảng 6 tháng
Đây là nhóm phù hợp nhất với roadmap sáu tháng trong bài. Nếu bạn đã biết JavaScript, Java, PHP, Python, SQL hoặc từng xây API, đừng quay lại học computer science từ đầu.
Học Python đủ dùng, sau đó đi thẳng vào LLM API, RAG, agents và Production.
Path C: Sinh viên Computer Science
Sinh viên có một lợi thế rất lớn: bạn có thể học hai đường song song. Ở trường, tiếp tục algorithms, database, operating systems, probability, linear algebra và machine learning. Ngoài trường, xây sản phẩm với LLM.
Sau hai năm, sự kết hợp giữa nền tảng CS và portfolio thực chiến có giá trị hơn việc chỉ chạy theo framework AI mới nhất.
3. Giai đoạn 1 — Nền tảng roadmap AI engineer 2026, tuần 1-6
Mục tiêu sáu tuần đầu không phải “thành thạo Python”. Mục tiêu là có đủ khả năng viết một chương trình gọi LLM và xử lý kết quả một cách có cấu trúc.
Tuần 1-2: Python đủ để làm việc
Hãy học variables, list, dict, functions, loops, exceptions, modules, virtual environment, đọc ghi file, JSON và HTTP requests.
Bạn cũng cần hiểu async ở mức cơ bản vì ứng dụng AI thường phải chờ network request. Nhưng chưa cần lao vào metaclass, decorator phức tạp hay thuật toán nâng cao.
Quy tắc của tôi: nếu bạn có thể đọc một folder tài liệu, gọi API cho từng file, xử lý lỗi và ghi kết quả thành JSON thì Python của bạn đã đủ để bước tiếp.
Tuần 3: Gọi LLM API
Chọn ít nhất một provider và dùng trực tiếp API trước khi học framework. Có thể bắt đầu với OpenAI, Anthropic hoặc Gemini.
Bạn phải hiểu request, response, authentication, context window, input token, output token, latency và cost.
Temperature nên được hiểu như một tham số ảnh hưởng đến tính biến thiên của output, không phải nút “tăng độ thông minh”. Những tác vụ cần consistency thường cần cấu hình khác creative writing.
Tiếp theo là structured output. Trong ứng dụng thật, bạn thường không muốn model trả về một đoạn văn tùy ý. Bạn cần JSON theo schema để backend tiếp tục xử lý. Tài liệu Structured Outputs của OpenAI là một tài liệu nên đọc ngay từ giai đoạn này.
Tuần 4: Prompt engineering và system prompt
Prompt engineering vẫn quan trọng, nhưng đừng biến nó thành nghề “học thần chú”.
Một prompt tốt thường cần xác định role, objective, context, constraints, expected output và failure behavior.
System prompt đặc biệt quan trọng khi xây ứng dụng nhiều lượt. Nó định nghĩa model được phép làm gì, không được làm gì, cách sử dụng context và cách phản ứng khi thiếu dữ liệu.
Tuy nhiên, hãy ghi nhớ một nguyên tắc sẽ đi theo bạn đến Production: prompt không thể thay thế architecture. Nếu hệ thống đưa sai dữ liệu cho model, viết prompt dài thêm ba trang thường không giải quyết được vấn đề.
Tuần 5-6: Mini project
Xây một CLI tool nhận file hoặc text rồi cho người dùng chọn “Tóm tắt”, “Dịch sang tiếng Anh” hoặc “Trích xuất thông tin”.
Ứng dụng phải có API key qua environment variable, error handling, structured output, token/cost logging cơ bản và README hướng dẫn chạy.
Đừng dùng LangChain cho project đầu tiên. Bạn cần nhìn thấy HTTP request và model response thực sự hoạt động thế nào trước khi framework che chúng đi.
Checklist kết thúc giai đoạn 1:
- Viết Python script không phải copy toàn bộ từ tutorial.
- Gọi được ít nhất một LLM API.
- Hiểu token, context, temperature và latency.
- Biết yêu cầu model trả structured output.
- Biết thiết kế system prompt cơ bản.
- Có một project chạy được trên GitHub.
4. Giai đoạn 2 — RAG + Vector DB, tuần 7-12
Nếu chỉ được chọn một kỹ năng applied AI để học sâu trong 2026, tôi sẽ chọn RAG — Retrieval-Augmented Generation.
Lý do rất thực tế: doanh nghiệp không chỉ muốn chatbot biết kiến thức Internet. Họ muốn AI trả lời từ hợp đồng, quy trình, chính sách, sản phẩm, CRM, ticket support và dữ liệu riêng.
Đó chính là bài toán RAG.
Pipeline RAG cần hiểu
Đừng học RAG bằng cách nhớ tên framework. Hãy hiểu pipeline:
document → chunking → embedding → vector DB → retrieval → rerank → context → generate
Chunking là chia tài liệu thành các đoạn có ý nghĩa. Chunk quá nhỏ làm mất context. Chunk quá lớn làm retrieval kém chính xác và tốn token.
Embedding biến nội dung thành vector số biểu diễn ý nghĩa tương đối của text.
Vector database giúp tìm các vector gần với câu hỏi của người dùng.
Retrieval lấy ra candidate documents. Reranking sắp xếp lại các candidate bằng một phương pháp chính xác hơn trước khi gửi context vào LLM.
Sau đó model mới thực hiện bước generate.
Điều quan trọng là: phần khó của RAG hiếm khi nằm ở câu lệnh gọi LLM. Nó nằm ở chất lượng dữ liệu, metadata, chunking, retrieval và evaluation.
Chọn Vector DB nào?
Qdrant phù hợp nếu bạn thích open source, có thể self-host và muốn kiểm soát infrastructure.
Pinecone phù hợp nếu ưu tiên managed service, muốn giảm thời gian vận hành database.
Weaviate cũng là lựa chọn mạnh cho semantic search và có ecosystem khá hoàn chỉnh.
Đừng dành hai tuần tranh luận database nào tốt nhất. Với người học, ba lựa chọn này đều đủ. Khả năng thiết kế retrieval tốt quan trọng hơn tên database trên CV.
Project giai đoạn 2: Vietnamese Business Document Q&A
Hãy lấy một bộ dữ liệu tiếng Việt thật: quy trình công ty giả lập, catalog sản phẩm, báo cáo thường niên, văn bản nội bộ public hoặc một bộ tài liệu ngành bạn hiểu.
Xây chatbot có upload document, indexing, semantic search, citations và trả lời “Tôi không tìm thấy thông tin trong dữ liệu” khi retrieval không đủ bằng chứng.
Sau đó tạo khoảng 30-50 câu hỏi kiểm thử. Đây chính là bước đầu tiên để bạn bước sang tư duy evaluation.
5. Giai đoạn 3 — AI Agents + MCP, tuần 13-18
RAG giúp model biết thêm thông tin. Agent giúp model làm được việc.
Ví dụ, chatbot thông thường có thể nói: “Doanh thu tháng này giảm 8%.” Một reporting agent có thể tự query database, đọc số liệu, so sánh kỳ trước, tạo biểu đồ, viết summary rồi gửi báo cáo.
Agent thực chất là gì?
Bỏ qua hype, một agent cơ bản chỉ cần hiểu ba khái niệm.
Tool calling: model có khả năng yêu cầu hệ thống gọi một công cụ.
Function calling: ứng dụng định nghĩa các function có schema rõ ràng như get_customer(), search_orders() hoặc send_email().
Agent loop: model quan sát tình trạng hiện tại, quyết định action, nhận kết quả rồi tiếp tục cho đến khi đạt mục tiêu hoặc dừng.
Khó khăn bắt đầu khi agent có quá nhiều tool, context ngày càng lớn hoặc loop không có giới hạn. Vì vậy Production agent luôn cần permission, timeout, retry, budget và guardrail.
MCP — Model Context Protocol
MCP là một trong những thay đổi đáng chú ý nhất của giai đoạn 2025-2026. Thay vì mỗi AI application tự xây một kiểu integration với filesystem, database hay SaaS tool, MCP định nghĩa một giao thức mở để ứng dụng AI kết nối với dữ liệu và công cụ bên ngoài.
Tài liệu chính thức mô tả MCP là một open standard để kết nối AI applications với external systems. Nếu học MCP, nên bắt đầu từ tài liệu chính thức của Model Context Protocol thay vì chỉ xem tutorial.
Bạn không cần trở thành chuyên gia protocol. Nhưng đến cuối tuần 18, nên hiểu MCP server, MCP client, tools, resources và authorization ở mức triển khai được một demo.
Khi nào cần multi-agent?
Multi-agent nghe hấp dẫn vì dễ demo: một Research Agent nói chuyện với Analyst Agent rồi Writer Agent.
Nhưng đừng mặc định mọi workflow đều cần nhiều agent.
Nếu task có thể giải quyết bằng một deterministic workflow với ba function, hãy dùng ba function. Nếu một agent với năm tool đủ giải quyết bài toán, đừng tạo năm agent.
Multi-agent hợp lý khi các bước có context, quyền hạn, nhiệm vụ hoặc strategy khác nhau rõ ràng và việc tách chúng giúp hệ thống dễ kiểm soát hơn.
Project: Automated Reporting Agent
Xây agent nhận yêu cầu “Tạo báo cáo tuần này”, lấy dữ liệu từ CSV hoặc database, tính KPI, so với tuần trước và tạo executive summary.
Bạn có thể code toàn bộ bằng Python. Hoặc dùng n8n làm orchestration layer để thấy một cách triển khai rất thực tế: trigger → data source → AI → validation → Google Sheet/Slack/email.
Mục tiêu không phải chứng minh AI có thể làm mọi thứ. Mục tiêu là thiết kế workflow biết rõ bước nào deterministic, bước nào nên giao cho LLM.
6. Giai đoạn 4 — Production + LLMOps + Eval, tuần 19-24
Đây là giai đoạn phân biệt một AI demo với một AI product.
Notebook chạy được không đồng nghĩa ứng dụng chạy được cho 1.000 người. Agent hoàn thành ba test case không có nghĩa nó đáng tin cậy trên dữ liệu thật.
Runs ≠ trustworthy.
Đưa ứng dụng lên Production
Hãy đóng gói RAG chatbot hoặc agent thành API bằng FastAPI hoặc backend stack bạn quen thuộc.
Bạn cần xử lý authentication, API gateway, request validation, timeout, retry, rate limiting, concurrency và streaming response.
Streaming tưởng chỉ là UI feature nhưng ảnh hưởng khá nhiều đến architecture vì client cần nhận token hoặc event theo thời gian thực.
Tiếp theo là caching. Không phải request nào cũng cần gọi model đắt nhất. Một số kết quả embedding có thể cache. Một số prompt có thể dùng model nhỏ hơn. Một số workflow thậm chí không cần LLM.
Evaluation: kỹ năng bị người mới bỏ qua nhiều nhất
Giả sử bạn đổi chunk size từ 500 thành 800 tokens và chatbot “có vẻ trả lời tốt hơn”. Làm sao chứng minh?
Bạn cần eval dataset.
Với RAG, có thể đo retrieval quality, context relevance, faithfulness, factual correctness hoặc answer quality. Framework như Ragas cung cấp nhiều metric cho RAG và agentic workflows.
LLM-as-a-judge cho phép dùng một model khác để chấm output theo rubric. Nhưng judge cũng là model, vì vậy không nên coi điểm số của nó là chân lý. Hãy kết hợp automatic evaluation với human review trên một tập mẫu quan trọng.
Quy trình tốt là: tạo dataset → chạy baseline → thay đổi prompt/model/retrieval → chạy lại → so sánh → chỉ deploy nếu chất lượng không regression.
Monitoring và chi phí ẩn
Production AI cần observability khác phần mềm thông thường. Bạn cần biết một request đã đi qua prompt nào, gọi model nào, retrieval được document nào, gọi tool gì, mất bao lâu và tốn bao nhiêu token.
Langfuse hoặc LangSmith có thể giúp trace những bước này. Langfuse hỗ trợ theo dõi traces, latency, token usage, cost và evaluation scores cho ứng dụng LLM.
Chi phí ẩn thường không chỉ nằm ở output token. Có embedding, reranker, retries, agent loop, vector database, logging và đôi khi một user request tạo ra 10-20 model calls bên dưới.
Project cuối roadmap
Lấy chatbot RAG hoặc agent của bạn và đưa lên Production.
Thêm authentication, rate limit, logs, tracing, token cost, fallback model và evaluation suite.
Tạo ít nhất 50 test cases. Mỗi khi đổi prompt, model hoặc retrieval config, chạy eval trước khi deploy.
Nếu bạn làm được project này và giải thích rõ architecture trong interview, portfolio của bạn đã vượt xa một repository chỉ có notebook gọi ChatGPT API.

7. Bảng kỹ năng 2026 — hiring thật sự cần gì trong roadmap AI engineer 2026
Nếu phải rút roadmap thành một bảng ưu tiên tuyển dụng, tôi sẽ chia thành ba lớp: core, useful và specialized.
| Kỹ năng | Mức ưu tiên | Bạn cần chứng minh thế nào? |
| Python / backend engineering | Core | Xây API, xử lý data, error handling, async |
| LLM API + structured output | Core | Tích hợp model thành application workflow |
| RAG | Core | Chunking, retrieval, citations, evaluation |
| Vector DB | Core | Qdrant, Pinecone, Weaviate hoặc tương đương |
| AI Agents + tool calling | Core | Workflow có tool, state, guardrail |
| Evaluation | Core | Dataset, metrics, regression testing |
| LLMOps / observability | Core | Tracing, latency, token và cost monitoring |
| MCP | Useful | Kết nối ít nhất một tool hoặc data source |
| Docker / cloud deployment | Useful | Deploy project chạy được thực tế |
| Fine-tuning | Nice-to-have | Biết khi nào cần và khi nào không |
| Traditional MLOps | Nice-to-have tùy vị trí | Quan trọng hơn với ML-heavy roles |
| RLHF / model training | Specialized | Cần nếu đi sâu research/model development |
Ngoài kỹ thuật, hai kỹ năng thường bị xem nhẹ là product sense và communication.
Một senior AI Engineer không chỉ hỏi “model nào benchmark cao nhất?” mà còn hỏi: lỗi nào chấp nhận được? Người dùng cần latency bao nhiêu? Nếu confidence thấp thì fallback thế nào? Một câu trả lời sai gây thiệt hại bao nhiêu? Có cần AI ở bước này không?
Đó là tư duy product engineering.
8. 5 project portfolio để xin việc — tăng dần độ khó
1. RAG Document Q&A Chatbot
Đây nên là project nền tảng. Đừng chỉ upload PDF rồi gọi framework. Hãy có ingestion pipeline, chunking strategy, metadata filtering, vector search, citations và eval dataset. README phải giải thích tại sao bạn chọn chunk size, embedding model và database.
2. Workflow Automation Agent bằng n8n
Tạo một workflow có giá trị kinh doanh thật: đọc email support, phân loại yêu cầu, truy vấn dữ liệu liên quan, draft câu trả lời rồi yêu cầu human approval trước khi gửi. Project này chứng minh bạn hiểu integration và automation, không chỉ chatbot.
3. Eval + Monitoring System cho AI App
Lấy project số một hoặc hai, bổ sung traces, latency, token cost, test dataset và dashboard evaluation. Đây là project rất đáng giá vì phần lớn tutorial dừng trước bước này.
4. Multi-Agent Orchestration
Xây một hệ thống trong đó việc tách agent có lý do kiến trúc rõ ràng. Ví dụ Research Agent có quyền truy cập search, Data Agent chỉ truy cập database nội bộ, Report Agent chỉ nhận evidence từ hai agent trước và viết báo cáo.
Quan trọng nhất: benchmark nó với phiên bản single-agent. Nếu multi-agent phức tạp hơn mà không tốt hơn, hãy ghi điều đó vào README. Đây là dấu hiệu của tư duy engineering trưởng thành.
5. Fine-tune một Small Model
Chọn một task hẹp như classification, extraction hoặc style transformation. Tạo dataset, baseline với prompt, fine-tune model nhỏ rồi so sánh quality, latency và cost.
Mục tiêu không phải nói “tôi biết fine-tuning”. Mục tiêu là chứng minh bạn biết khi nào fine-tuning tạo ra lợi ích so với prompting hoặc RAG.
Nếu cần một bản đồ rộng hơn về các nhánh kỹ thuật AI, bạn có thể tham khảo AI Engineer roadmap trên roadmap.sh. Nhưng hãy dùng nó như reference map, không phải checklist bắt buộc phải học hết trước khi làm project.
9. Sai lầm người mới hay mắc — mất 3-6 tháng
Học quá nhiều ML theory trước khi chạm API
Tôi không nói toán và machine learning không quan trọng. Nếu bạn muốn làm model research, chúng cực kỳ quan trọng.
Nhưng nếu mục tiêu sáu tháng là Applied AI Engineer, việc dành bốn tháng đầu chỉ học calculus, linear algebra và neural networks trước khi gọi API đầu tiên thường là chiến lược kém hiệu quả.
Hãy build trước. Khi gặp vấn đề cần hiểu sâu hơn, quay lại theory. Lúc đó kiến thức sẽ có context.
Nhảy model liên tục nhưng không hoàn thành project
Tuần này học GPT. Tuần sau Claude. Sau đó Gemini, Llama, Qwen, DeepSeek và thêm năm framework agent.
Sau ba tháng bạn biết rất nhiều tên nhưng chưa có sản phẩm hoàn chỉnh.
Model thay đổi nhanh. Engineering fundamentals thay đổi chậm hơn.
Chọn một model tốt, hoàn thành project rồi mới benchmark model khác.
Bỏ qua evaluation
Đây là lỗi nguy hiểm nhất.
Người mới test chatbot bằng năm câu hỏi, thấy câu trả lời hợp lý rồi tuyên bố “RAG hoạt động tốt”.
Production không vận hành như demo.
Bạn cần dataset, expected behavior và metric. Nếu không đo được hệ thống trước và sau khi thay đổi, bạn đang optimize bằng cảm giác.
Học theo skill list thay vì ordered path
Một roadmap ghi 40 công nghệ trông rất đầy đủ nhưng chưa chắc giúp bạn tiến bộ.
Learning path tốt phải có dependency rõ ràng.
Bạn học API trước RAG vì RAG sử dụng model API. Học RAG trước agent vì agent thường phải truy xuất context. Học agent trước observability vì muốn monitor agent bạn phải hiểu agent loop.
Đó là lý do bài này được tổ chức theo từng giai đoạn thay vì một danh sách công nghệ.
10. Câu hỏi thường gặp về roadmap AI Engineer 2026
Không biết Python có làm AI Engineer được không?
Có, nhưng bạn cần học Python hoặc một ngôn ngữ backend đủ tốt để xây hệ thống thật. Nếu đã biết JavaScript, Java, Go hoặc C# thì quá trình chuyển sang Python thường khá nhanh. Đừng chờ đến khi “thành thạo Python” mới bắt đầu AI. Học khoảng 2-3 tuần những phần cần thiết, sau đó dùng Python để làm project.
Mất bao lâu từ Zero đến xin được việc?
Nếu bạn đã là developer hoặc data professional, khoảng 6 tháng học đều và có 3-5 project tốt là mục tiêu khả thi để bắt đầu ứng tuyển junior hoặc applied AI roles. Nếu hoàn toàn chưa biết lập trình, hãy nghĩ theo khung 9-12 tháng. Đây chỉ là thời gian tham khảo, không phải cam kết.
Học online miễn phí có đủ không?
Đủ để đạt trình độ đi làm nếu bạn biết chọn tài liệu và thực sự xây project. Documentation chính thức, GitHub repository, technical blog và course miễn phí hiện đã quá nhiều. Thứ thiếu thường không phải nội dung mà là structure và feedback.
AI Engineer khác Prompt Engineer thế nào?
Prompt engineering là một kỹ năng bên trong AI engineering. AI Engineer phải xử lý cả data pipeline, API, RAG, vector database, tool calling, agent orchestration, backend, security, evaluation, monitoring và deployment.
2026 có quá muộn để vào ngành AI không?
Không. Ngược lại, 2026 có thể dễ tiếp cận hơn giai đoạn đầu vì model, API, framework và infrastructure đã trưởng thành hơn. Điều thay đổi là tiêu chuẩn cũng cao hơn: chỉ biết gọi ChatGPT API không còn tạo khác biệt lớn.
Kết luận — bắt đầu roadmap AI Engineer 2026 từ hôm nay
Nếu bạn đã có nền tảng lập trình, sáu tháng tới có thể chia rất đơn giản: 6 tuần nền tảng và LLM API, 6 tuần RAG, 6 tuần agents + MCP, 6 tuần Production + eval + LLMOps.
Đừng bắt đầu bằng việc bookmark thêm 30 khóa học.
Bài tập đầu tiên hôm nay chỉ cần thế này: cài Python, tạo một API key, viết chương trình khoảng vài chục dòng nhận một đoạn tiếng Việt và trả về bản tóm tắt có cấu trúc. Đưa nó lên GitHub. Ngày mai cải thiện thêm một chút.
Sáu tháng sau, điều tạo khác biệt không phải bạn đã xem bao nhiêu video về AI. Đó là việc bạn có thể mở portfolio và nói: “Đây là hệ thống tôi xây, đây là cách retrieval hoạt động, đây là agent loop, đây là eval dataset, đây là chi phí và đây là cách tôi đưa nó lên Production.”
Nếu bạn muốn tiếp tục theo dõi những bài thực chiến về AI Engineer, RAG, agents, MCP và LLMOps, hãy đăng ký newsletter của cuongnguyen.ai.vn. Tôi sẽ tiếp tục tập trung vào một câu hỏi duy nhất: làm thế nào biến AI từ demo thành sản phẩm thực sự dùng được?
Danh sách bài viết trước
- AI là gì? Giải thích đơn giản trong 15 phút (Series AI Cơ bản #1)
- Đừng Dùng ChatGPT Như Google (Series AI Cơ Bản #2)
- Tại Sao AI Hay “Nói Điêu”? (Series AI Cơ Bản #3)
- Bí Mật Của Token: Tại Sao AI Hay “Quên”? (Series AI Cơ Bản #4)
- Công thức RCIO: Cách Viết PROMPT Giao Việc Cho AI
- n8n là gì? Vũ khí tự động hóa “Fair-code” mạnh mẽ thay thế Zapier (2026)
- Hướng dẫn n8n cho người mới: Tự động hóa công việc chỉ với 3 bước (2026)
- Tự động hóa Marketing với n8n: 7 cách tôi tiết kiệm 20 giờ mỗi tuần (Bí kíp thực chiến)
- ClawdBot là gì? Biến Telegram thành Trợ lý AI Cá nhân miễn phí (2026)
- Hướng dẫn tích hợp Ollama vào ClawdBot: Sở hữu Trợ lý AI chạy Local “0 đồng” (2026)
- Dạy ClawdBot “Lướt web” (Browser Control): Tự động điền form và săn sale (2026)
- Biến Notion từ “Kho chứa” thành “Trợ lý sống” với ClawdBot (2026)
— Cường Nguyễn (Richard)
AI Automation Architect | Founder, AI Ops Solutions
Facebook | Linkedin
Muốn nhận thêm bài viết thực chiến về AI mỗi tuần?
Tôi gửi 1 email/tuần, chia sẻ cách ứng dụng AI vào công việc thực tế và cập nhật tin tức mới nhất về AI. Không spam, không bán khóa học, chỉ có kiến thứcc
Đăng ký theo dõi tại đây
Bài viết là góc nhìn cá nhân của tác giả, mang tính tham khảo — không phải tin tức báo chí.
📬 Nhận bài viết mới — miễn phí
Đừng bỏ lỡ bài viết tiếp theo. Đăng ký để nhận trong inbox.
Tác giả
Cường Nguyễn — AI Thực Chiến
Tôi là Cường Nguyễn - Founder của AI Ops Solutions.
Tôi từng là Logistics Operations Manager và đồng sáng lập thương hiệu CATCA - #1 Shopee ngành Pet Care.
10 năm kinh nghiệm Logistics/E-commerce OperationsCo-founder CATCA - #1 Shopee ngành Pet CareMột trong 300+ n8n Verified Creator toàn cầuTư vấn Giải pháp chuyển đổi số bằng AI cho 3 SMEs/quý


