Bài viết
Bài viết cá nhân
Benchmark AI là gì? Đọc hiểu chỉ số đánh giá mô hình như người trong nghề
👤 cuongnguyen📅 19/08/2026⏱ 21 phút đọc
Trong bài viết này(32 mục)⌄
- Benchmark AI là gì? Bản đồ định lượng, không phải bảng xếp hạng thần thánh
- Các benchmark đang đo những loại năng lực nào?
- Tri thức học thuật: MMLU và MMLU-Pro
- Lập luận chuyên sâu: GPQA Diamond, HLE và MATH-500
- Lập trình: HumanEval, HumanEval+, LiveCodeBench và SWE-bench Verified
- Tuân thủ chỉ thị và thị hiếu người dùng: IFEval, MT-Bench, Chatbot Arena Elo
- Agent và môi trường thực thi: OSWorld, GAIA, Terminal-Bench 2.0
- Giải mã MMLU, GSM8K, HumanEval và Arena Elo mà không bị leaderboard dắt mũi
- Ba lý do điểm benchmark cao không bảo đảm Agent đáng tin trong Production
- Benchmark Saturation: khi vùng trên 90% không còn nói nhiều
- Data Contamination: model có thể nhớ đề thay vì suy luận
- Scaffold Dependence: Agent mạnh hay yếu phụ thuộc vào dàn khung
- Production xóa nhòa nhiều khoảng cách lý thuyết
- Ma trận đọc benchmark theo từng bài toán
- Customer Support và RAG Pipeline
- Code Assistant và tự động hóa phần mềm
- Research Assistant, pháp lý và y tế
- Computer-use và Tool-using Agent
- Model Routing: đừng dùng một siêu model cho mọi prompt
- Cẩm nang xây bộ Custom Evaluation cho doanh nghiệp
- Bước 1: Tạo Golden Dataset từ công việc thật
- Bước 2: Viết rubric Pass/Fail rõ ràng với Domain Expert
- Bước 3: Dùng LLM-as-a-Judge có kiểm định
- Bước 4: Kiểm tra lỗi thực thi, Red Teaming và Prompt Injection
- Bước 5: Đánh giá liên tục, không chấm một lần rồi cất tủ
- Từ đo IQ sang đo Work Execution
- Câu hỏi thường gặp
- MMLU đạt trên 90% có nghĩa model có kiến thức ngang chuyên gia?
- Làm sao biết model điểm cao nhờ suy luận thật hay do học vẹt bộ test?
- Doanh nghiệp vừa và nhỏ có cần tự xây Custom Evaluation?
- SWE-bench Verified khác HumanEval thế nào khi chọn code assistant?
- Có nên chọn model đứng đầu Chatbot Arena Elo cho chatbot doanh nghiệp?
Benchmark AI là gì? Bản đồ định lượng, không phải bảng xếp hạng thần thánh
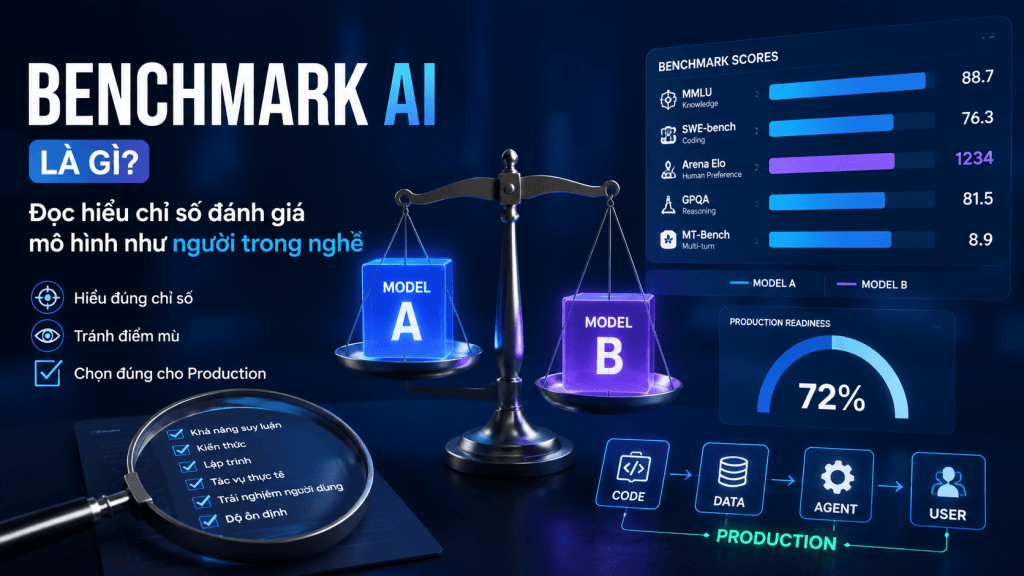
Benchmark AI là tập hợp các bộ dữ liệu chuẩn hoá cùng giao thức đánh giá dùng để đo một năng lực cụ thể của mô hình. Nói ngắn gọn: đưa cùng một đề bài cho nhiều mô hình, chấm theo một luật chung, rồi so sánh kết quả.
Nghe có vẻ hiển nhiên. Nhưng đây là chỗ nhiều đội ngũ mua nhầm công cụ, chọn nhầm model và đặt kỳ vọng sai vào AI Agent. Họ nhìn một bảng leaderboard, thấy model A hơn model B vài điểm, rồi suy ra model A sẽ xử lý tốt hơn mọi việc trong doanh nghiệp. Suy luận đó yếu như việc chọn nhân sự chỉ từ điểm thi đầu vào.
Benchmark cần thiết vì không thể đánh giá LLM bằng cảm giác. Một demo trả lời mượt mà có thể che giấu lỗi lập luận, lỗi tuân thủ chỉ thị, lỗi gọi tool hoặc lỗi tạo Structured Output. Benchmark buộc nhà cung cấp và người dùng phải đưa ra một thước đo có thể kiểm tra được. Vấn đề là benchmark chỉ đo được thứ nó được thiết kế để đo.
Tôi xem benchmark như bản đồ địa hình. Nó cho biết model nào có khả năng đi qua núi, băng qua sông hoặc chạy nhanh trên đường bằng. Nó không nói chắc model ấy sẽ đến đúng địa chỉ giao hàng của công ty bạn trong giờ cao điểm. Giữa bản đồ và chuyến đi thật còn có dữ liệu nội bộ, RAG, API, prompt, quyền truy cập, latency, cơ chế retry, guardrail, người dùng và cả những tình huống chẳng ai viết vào tài liệu yêu cầu.
Với LLM và Agentic AI đến năm 2026, một Benchmark AI tốt phải giúp ta trả lời hai câu khác nhau:
- Model có năng lực nền tảng gì? Ví dụ kiến thức, lập luận, viết code, tuân thủ yêu cầu.
- Hệ thống của tôi có hoàn thành công việc thật không? Ví dụ tra cứu đúng chính sách nội bộ, tạo báo cáo đúng schema, sửa issue trong repository, hay thao tác an toàn trên giao diện máy tính.
Câu đầu phù hợp với benchmark công khai. Câu sau buộc bạn làm Custom Evaluation. Nếu chỉ có câu đầu, bạn đang mua một lời hứa. Nếu chỉ có câu sau, bạn khó biết hệ thống của mình đang thua hay thắng ở đâu so với thị trường.
Các benchmark đang đo những loại năng lực nào?
Sai lầm phổ biến nhất là gọi mọi benchmark là “điểm IQ của AI”. Không có một chỉ số IQ chung nào ở đây. Mỗi benchmark cắt một lát rất hẹp của năng lực mô hình, với định dạng câu hỏi, luật chấm và môi trường thực thi riêng.
Tri thức học thuật: MMLU và MMLU-Pro
MMLU và MMLU-Pro được dùng để kiểm tra hiểu biết học thuật trên nhiều lĩnh vực. Đây là nhóm benchmark hữu ích khi bạn cần hình dung năng lực trả lời câu hỏi kiến thức rộng, đặc biệt với những tác vụ cần tổng hợp nền tảng từ nhiều môn học.
Nhưng MMLU không nói nhiều về việc model có đọc đúng tài liệu nội bộ của bạn hay không. Nó cũng không tự chứng minh model biết dừng lại khi thiếu dữ kiện. Một model có thể làm tốt bài trắc nghiệm nhưng vẫn trả lời tự tin về một chính sách công ty không tồn tại, nếu Workflow RAG của bạn lấy nhầm tài liệu.
Lập luận chuyên sâu: GPQA Diamond, HLE và MATH-500
GPQA Diamond, HLE và MATH-500 nhắm vào lập luận logic, các câu hỏi có độ khó cao và khả năng giải toán. Đây là nơi các model Frontier thường được đem ra so kè vì người mua muốn biết chúng xử lý được câu hỏi phức tạp đến đâu.
Điểm tốt ở nhóm này đáng quan tâm nếu bạn xây trợ lý nghiên cứu, xử lý tài liệu chuyên môn hoặc cần phân tích nhiều bước. Dù vậy, đừng biến một điểm số logic thành giấy chứng nhận cho hệ thống ra quyết định. Một workflow pháp lý hay y tế còn cần truy xuất đúng nguồn, kiểm soát phạm vi trả lời, lưu vết và cơ chế chuyển sang chuyên gia con người khi cần.
Lập trình: HumanEval, HumanEval+, LiveCodeBench và SWE-bench Verified
HumanEval và HumanEval+ đo khả năng viết hàm, thường là bài toán code có đầu vào và kiểm thử rõ ràng. LiveCodeBench mở rộng góc nhìn sang các bài lập trình mới hơn. SWE-bench Verified gần với công việc phần mềm hơn: model cần xử lý GitHub issue trong repository, chứ không chỉ viết một hàm nhỏ tách khỏi hệ thống.
Khác biệt này quan trọng. Một assistant code viết được đoạn Python sạch trong cửa sổ chat chưa chắc hiểu cấu trúc repository, tái tạo lỗi, sửa đúng file, chạy test, nhận phản hồi từ execution rồi sửa tiếp. Khi đội kỹ thuật nói “chúng tôi cần AI viết code”, bạn phải hỏi lại: viết snippet, tạo test, sửa bug, hay tự xử lý issue? Mỗi câu cần bộ benchmark khác nhau.
Tuân thủ chỉ thị và thị hiếu người dùng: IFEval, MT-Bench, Chatbot Arena Elo
IFEval và MT-Bench quan sát khả năng làm theo chỉ thị. Đây là nhóm bị đánh giá thấp khi người ta mải nhìn MMLU. Với Production, đặc biệt các luồng Structured Output, yêu cầu “chỉ xuất JSON”, “không thêm diễn giải”, “dùng đúng trường dữ liệu” thường quan trọng hơn một câu trả lời học thuật hoa mỹ.
Chatbot Arena Elo phản ánh sở thích người dùng khi họ so sánh câu trả lời. Nó có giá trị vì sản phẩm AI cuối cùng phải được con người dùng. Nhưng Elo đo cảm nhận đối đầu trong một dạng tương tác; nó không thay thế kiểm thử độ chính xác nghiệp vụ, bảo mật dữ liệu hay khả năng thực thi công việc qua API.
Agent và môi trường thực thi: OSWorld, GAIA, Terminal-Bench 2.0
OSWorld, GAIA và Terminal-Bench 2.0 dịch chuyển cách đánh giá từ câu hỏi tĩnh sang môi trường có thao tác. Model phải quan sát, lập kế hoạch, dùng tool, xử lý phản hồi và hoàn thành một chuỗi hành động.
Đây là hướng gần thực tế hơn đối với AI Agent. Dù vậy, “gần hơn” không có nghĩa “giống hệt”. Máy tính trong benchmark không phải hệ thống CRM của bạn. Terminal trong benchmark không phải hạ tầng có secret, quyền production và chính sách compliance của công ty. Khoảng cách ấy là lý do tôi luôn tách rõ benchmark model khỏi đánh giá toàn bộ Agentic Workflow.
Giải mã MMLU, GSM8K, HumanEval và Arena Elo mà không bị leaderboard dắt mũi
Đọc benchmark như người trong nghề bắt đầu từ một nguyên tắc đơn giản: luôn hỏi “điểm này được tạo ra bằng dữ liệu nào, luật nào, prompt nào, tool nào và môi trường nào?” Nếu nhà cung cấp không nói rõ, con số ấy chỉ phù hợp cho marketing.
MMLU cho bạn một tín hiệu về kiến thức học thuật. GSM8K cho bạn tín hiệu về bài toán toán học ở một định dạng nhất định. HumanEval cho bạn tín hiệu về viết code theo unit test. Chatbot Arena Elo cho bạn tín hiệu về mức độ người dùng thích một phản hồi so với phản hồi khác.
Không benchmark nào trong số đó tự trả lời câu hỏi: “Model có tạo được báo giá đúng theo dữ liệu ERP của tôi không?” Câu hỏi này chứa ít nhất bốn vấn đề: truy xuất dữ liệu, hiểu quy tắc nghiệp vụ, tuân thủ schema đầu ra và kiểm soát thao tác có hậu quả. Điểm MMLU cao không giải quyết thay bạn bất kỳ vấn đề nào.
Cũng cần cảnh giác với khoảng cách nhỏ trên leaderboard. Khi một model đã ở vùng điểm rất cao, khác biệt một hoặc hai điểm phần trăm có thể nằm trong nhiễu thống kê hoặc do cách định dạng prompt. Nếu model A nhỉnh hơn model B trong một benchmark bão hoà, điều đó chưa đủ để kết luận A đáng trả thêm tiền, chấp nhận latency cao hơn hoặc khóa chặt kiến trúc vào một API duy nhất.
Benchmark là tín hiệu để đặt giả thuyết, không phải phán quyết để ký hợp đồng.
Tôi thường dùng leaderboard để lập danh sách ngắn, không dùng nó để chọn người thắng cuối cùng. Danh sách ngắn có thể gồm một Frontier model mạnh về reasoning, một lựa chọn Open-weight hay SLM tiết kiệm, rồi đưa cả hai vào tập dữ liệu công việc thật. Kết quả từ dữ liệu thật thường làm bảng xếp hạng đảo vị trí khá nhanh.
Ba lý do điểm benchmark cao không bảo đảm Agent đáng tin trong Production
Benchmark Saturation: khi vùng trên 90% không còn nói nhiều
Nhiều benchmark kinh điển đã gần bão hoà với các model Frontier. GSM8K được ghi nhận ở mức trần 99% với GPT-5.3 Codex. HumanEval ở 93%. MMLU ở vùng trên 90-93% với các model như Claude Opus 4.6, Gemini 3.1 Pro và GPT-5.3.
Con số này không vô dụng. Nó cho biết một thế hệ model đã vượt qua loại đề đó rất tốt. Nhưng sau khi benchmark bị bão hoà, nó mất sức phân biệt. Cố đọc ra “người thắng tuyệt đối” từ chênh lệch nhỏ ở vùng đỉnh là một kiểu tự lừa mình bằng số liệu.
Thay vì hỏi model nào hơn một điểm trên MMLU, hãy hỏi model nào ít vi phạm schema hơn trong workflow của bạn, model nào gọi tool ổn định hơn, model nào giữ ngữ cảnh tốt hơn với tài liệu nội bộ, và model nào có tổng chi phí phù hợp. Đây là các biến số làm sản phẩm sống hoặc chết.
Data Contamination: model có thể nhớ đề thay vì suy luận
Các benchmark công khai có nguy cơ bị thu thập vào web corpus dùng cho huấn luyện. Khi đó, model giải đúng có thể nhờ ghi nhớ mẫu thay vì lập luận từ đầu. Đây là vấn đề Data Contamination, hay nhiễm bẩn dữ liệu huấn luyện.
Một phát hiện đáng chú ý: khi lọc sạch những câu hỏi trùng lặp trong tập kiểm thử GSM8K, độ chính xác của nhiều model giảm tới 13%. Con số này nhắc chúng ta rằng điểm benchmark không tự động phản ánh reasoning thực chất.
Đừng hiểu sai: contamination không có nghĩa mọi benchmark đều vô giá trị, hay mọi model điểm cao đều học vẹt. Nó nghĩa là bạn phải giảm mức tự tin khi đọc một tập dữ liệu công khai, tĩnh và xuất hiện lâu trên internet. Benchmark càng quen thuộc, câu hỏi về contamination càng cần được đặt thẳng.
Scaffold Dependence: Agent mạnh hay yếu phụ thuộc vào dàn khung
Với các bài toán software engineering, model hiếm khi làm việc một mình. Nó nhận system prompt, được phân công vai trò, có vòng lặp tự sửa lỗi, chạy test, đọc execution feedback và gọi tool theo những giới hạn nhất định. Toàn bộ phần này là scaffold.
Ở SWE-bench, điểm giải quyết GitHub issue có thể biến động tới 25% chỉ vì khác scaffold: cấu trúc prompt, vòng phản hồi execution feedback hoặc chiến lược sửa lỗi. Đây là dữ kiện rất khó chịu cho các bài quảng cáo kiểu “model X đạt Y%”. Câu hỏi đúng phải là: X đạt Y% với scaffold nào?
Hai công ty dùng cùng một API có thể nhận hai kết quả cách xa nhau vì một bên chỉ gửi prompt đơn, bên kia xây Workflow biết lấy log, chạy test, cô lập lỗi và quay lại sửa. Nếu muốn hiểu sâu mặt an toàn của lớp thực thi này, bài viết về Sandbox AI không còn an toàn là một điểm nối cần đọc: môi trường để Agent thử hành động cũng là một bề mặt rủi ro.
Production xóa nhòa nhiều khoảng cách lý thuyết
Trên giấy, một Frontier model có thể dẫn đầu nhiều benchmark. Trong Production, một model Open-weight như Qwen hoặc GLM, hay một SLM phù hợp, vẫn có thể là lựa chọn tốt hơn cho một nhánh tác vụ cụ thể. Không phải vì nó thông minh hơn toàn diện. Vì bài toán có ràng buộc khác: chi phí, latency, dữ liệu, mức độ phức tạp và yêu cầu kiểm soát.
Ví dụ RAG cho customer support. Người dùng không cần model giải một bài logic cấp cao nếu tài liệu chính sách đã đủ rõ. Họ cần câu trả lời bám sát tài liệu, không bịa điều kiện hoàn tiền, không bỏ sót trường thông tin và biết nói “không tìm thấy dữ liệu” khi kho tri thức không có câu trả lời. Với bài toán ấy, IFEval và Custom Evaluation về instruction following thường cho tín hiệu thực dụng hơn MMLU thuần túy.
Hay Structured Output cho một API nghiệp vụ. Nếu model phải trả đúng schema để hệ thống sau đó xử lý tự động, một câu trả lời hay nhưng sai field có giá trị bằng không. Một lỗi dấu phẩy, thiếu trường hoặc bịa enum có thể làm workflow hỏng. Điểm Arena Elo cao không cứu được bạn khỏi lỗi tích hợp.
Ngôn ngữ bản địa là một góc khuất khác. Benchmark phổ biến không đại diện đầy đủ cho cách người dùng Việt viết tắt, trộn thuật ngữ, dùng địa danh, nêu quy tắc nội bộ hoặc diễn đạt mơ hồ. Một Agent có thể trả lời tiếng Anh xuất sắc nhưng lúng túng với câu hỏi tiếng Việt chứa văn phong ngành nghề. Đây là lý do dữ liệu kiểm thử nội bộ cần chứa đúng ngôn ngữ khách hàng thực sự dùng, gồm cả câu hỏi xấu, thiếu ngữ pháp và có nhiều ngữ cảnh ngầm.
Khi nhìn rộng hơn, câu chuyện không còn là chọn model có điểm cao nhất. Nó là thiết kế hạ tầng AI đúng với công việc. Tôi đã viết thêm về chuyển dịch từ cơn sốt model sang hạ tầng tự chủ trong bài AI Doanh nghiệp 2026. Benchmark là một lớp trong hạ tầng ấy, không phải toàn bộ chiến lược.
Ma trận đọc benchmark theo từng bài toán
Customer Support và RAG Pipeline
Ưu tiên kiểm tra khả năng tuân thủ chỉ thị qua IFEval hoặc các test tương tự, sau đó đo trực tiếp trên tài liệu và câu hỏi thật của doanh nghiệp. Hãy chấm các lỗi có tác động: trả lời sai chính sách, bỏ qua nguồn, không theo format hoặc không biết từ chối khi thiếu căn cứ. MMLU là tín hiệu phụ, không phải tiêu chí quyết định.
Code Assistant và tự động hóa phần mềm
HumanEval và HumanEval+ hữu ích khi cần biết năng lực sinh code cơ bản. LiveCodeBench giúp quan sát bài toán code rộng hơn. Nếu Agent phải xử lý issue trong repository, SWE-bench Verified gần nhu cầu hơn. Nhưng bạn vẫn phải kiểm thử bằng repository, pipeline và scaffold của chính mình vì hiệu năng có thể đổi mạnh theo execution feedback.
Research Assistant, pháp lý và y tế
GPQA Diamond, HLE, MATH-500 và MMLU giúp nhận diện năng lực reasoning, tri thức và xử lý câu hỏi khó. Song với miền nhạy cảm, benchmark nền tảng mới là vòng loại đầu. Bộ test nội bộ cần đo khả năng bám nguồn, phân biệt điều biết và điều không biết, tuân thủ phạm vi trả lời và xử lý yêu cầu mơ hồ.
Computer-use và Tool-using Agent
OSWorld, GAIA và Terminal-Bench 2.0 có ý nghĩa vì chúng đánh giá hành động trong môi trường. Dù vậy, hãy dựng môi trường thử riêng phản ánh tool, quyền truy cập và trạng thái lỗi của hệ thống thật. Một Agent thao tác nhầm trong demo có thể chỉ gây phiền. Một Agent thao tác nhầm trên dữ liệu doanh nghiệp có thể tạo sự cố.
Model Routing: đừng dùng một siêu model cho mọi prompt
Xu hướng hợp lý hơn trong năm 2026 là Model Routing: phân loại prompt theo độ phức tạp, đưa tác vụ đơn giản sang SLM hoặc model Open-weight chi phí thấp như Mistral Small, Qwen hay GLM, rồi chỉ gửi bài logic cấp cao sang Frontier model.
Cách làm này có thể cắt giảm 50-80% chi phí vận hành. Nhưng tôi không khuyên triển khai routing chỉ vì thấy con số tiết kiệm hấp dẫn. Routing thêm một hệ thống quyết định mới. Nếu classifier định tuyến sai, câu hỏi khó bị đẩy vào model yếu hoặc câu đơn giản bị đẩy lên model đắt, lợi ích sẽ mất.
Điểm cân bằng cần theo dõi là latency, cost và accuracy. Hãy định nghĩa rõ tác vụ nào thật sự đơn giản: phân loại, trích xuất, chuẩn hóa format, truy vấn lặp lại với ngữ cảnh hẹp. Hãy định nghĩa rõ tác vụ nào cần escalation: lập luận nhiều bước, yêu cầu có rủi ro cao, dữ liệu mâu thuẫn hoặc cần xử lý ngữ cảnh dài.
Routing cũng có ý nghĩa về dữ liệu. Một số tác vụ có thể giữ trong model nội bộ hoặc Open-weight, trong khi các bài cần reasoning cao mới gọi Frontier API. Lựa chọn này phải đi cùng chính sách dữ liệu và kiểm thử an toàn, chứ không thể chỉ dựa vào giá token. Chi phí inference cũng liên quan trực tiếp tới bài toán điện năng và hạ tầng mà tôi đã phân tích trong bài Cơn Khát Năng Lượng 2026.
Cẩm nang xây bộ Custom Evaluation cho doanh nghiệp
Nếu chỉ làm một việc sau khi đọc bài này, tôi chọn việc này: tạo bộ Custom Evaluation riêng. Bạn không cần đợi một nền tảng khổng lồ. Bạn cần tập trung vào các lỗi thật đang làm team mất thời gian hoặc tạo rủi ro.
Bước 1: Tạo Golden Dataset từ công việc thật
Bắt đầu với 100-200 ca kiểm thử thực tế. Chọn từ ticket, hội thoại hỗ trợ, yêu cầu nội bộ, issue phần mềm hoặc truy vấn báo cáo đã được xử lý. Loại bỏ dữ liệu nhạy cảm khi cần, nhưng đừng “làm sạch” đến mức câu hỏi mất hết độ khó đời thường.
Tập này cần có ca dễ, ca trung bình, ca mơ hồ, ca thiếu dữ kiện, ca cố tình đánh lạc hướng và ca cần từ chối. Nếu Golden Dataset toàn câu hỏi đẹp, bạn đang xây benchmark cho demo chứ không phải Production.
Bước 2: Viết rubric Pass/Fail rõ ràng với Domain Expert
Đừng dùng tiêu chí mơ hồ như “câu trả lời hay”. Hãy viết Pass/Fail theo điều có thể quan sát: có lấy đúng thông tin không, có tuân thủ format không, có nêu sai chính sách không, có gọi đúng tool không, có dừng khi không đủ dữ liệu không.
Domain Expert cần tham gia vì người hiểu miền mới biết lỗi nào nguy hiểm. Một kỹ sư AI có thể thấy câu trả lời hợp lý, nhưng chuyên gia vận hành biết ngay nó thiếu một điều kiện khiến quy trình sai hoàn toàn.
Bước 3: Dùng LLM-as-a-Judge có kiểm định
LLM-as-a-Judge giúp chấm ở quy mô lớn, nhất là các câu trả lời dài hoặc có nhiều điều kiện. Nhưng judge cũng là model, nó có thiên kiến và có thể chấm sai. Vì vậy, hãy đối chiếu kết quả judge với đánh giá của con người trên một phần mẫu, rồi điều chỉnh rubric khi phát hiện lệch.
Điểm quan trọng không phải tìm judge hoàn hảo. Điểm quan trọng là phát hiện sớm khi cách chấm của bạn đang thưởng cho câu trả lời nghe thuyết phục nhưng sai nghiệp vụ.
Bước 4: Kiểm tra lỗi thực thi, Red Teaming và Prompt Injection
Đối với Agent dùng tool, câu trả lời cuối chỉ là một phần bài kiểm tra. Bạn phải kiểm tra Agent gọi API gì, truyền tham số nào, phản ứng ra sao khi tool trả lỗi, và có bị lôi khỏi nhiệm vụ bởi nội dung độc hại trong dữ liệu hay không.
Red Teaming ở đây không cần làm màu. Hãy dùng những đầu vào mà người dùng hoặc dữ liệu bên ngoài có thể đưa vào thực tế: chỉ thị mâu thuẫn, tài liệu chứa prompt lạ, yêu cầu vượt quyền và dữ liệu thiếu ngữ cảnh. Mục tiêu là tìm đường hệ thống thất bại trước khi khách hàng tìm thấy.
Bước 5: Đánh giá liên tục, không chấm một lần rồi cất tủ
Model thay đổi, prompt thay đổi, tài liệu RAG thay đổi, API thay đổi và hành vi người dùng cũng thay đổi. Bộ evaluation phải chạy liên tục mỗi khi bạn đổi model, đổi scaffold, đổi routing hay cập nhật kho tri thức. Hãy xem nó như regression test cho AI Workflow.
Điểm benchmark công khai có thể giúp theo dõi thị trường. Golden Dataset giúp bạn theo dõi sản phẩm của mình. Hai thứ nên đi cùng nhau, nhưng không được thay thế nhau.
Từ đo IQ sang đo Work Execution
Hướng phát triển đáng chú ý của AI Benchmark là đo khả năng hoàn thành công việc trong môi trường động. OSWorld, GAIA và Terminal-Bench 2.0 phản ánh dịch chuyển đó: AI không chỉ trả lời, mà cần quan sát trạng thái, hành động, nhận phản hồi và sửa sai.
Đây là thay đổi đúng hướng, vì giá trị kinh tế của Agent nằm ở Work Execution. Nhưng nó cũng khiến đánh giá khó hơn. Bạn phải xét cả model, scaffold, tool, quyền truy cập, dữ liệu và môi trường. Một model mạnh bị đặt trong workflow yếu vẫn cho kết quả yếu. Một model vừa đủ, đặt trong workflow có kiểm soát tốt, đôi khi lại mang về hiệu quả ổn định hơn.
Quan điểm của tôi khá thẳng: thị trường sẽ bớt ám ảnh với model “toàn năng” khi các đội ngũ chịu đo tỷ lệ hoàn thành công việc thật. Lúc đó, benchmark công khai vẫn tồn tại, nhưng nó quay về đúng vị trí: công cụ so sánh năng lực nền, không phải huy chương thay cho năng lực triển khai.
Câu hỏi thường gặp
MMLU đạt trên 90% có nghĩa model có kiến thức ngang chuyên gia?
Không. MMLU đo hiệu năng trên một bộ câu hỏi chuẩn hoá về kiến thức học thuật. Điểm cao cho thấy model xử lý tốt dạng bài đó, nhưng không chứng minh model có phán đoán, trách nhiệm hay độ tin cậy tương đương chuyên gia trong công việc thực tế. Với tác vụ chuyên môn, vẫn cần dữ liệu miền, rubric và cơ chế kiểm soát riêng.
Làm sao biết model điểm cao nhờ suy luận thật hay do học vẹt bộ test?
Không có một phép thử duy nhất. Hãy xem benchmark có nguy cơ Data Contamination không, ưu tiên tập dữ liệu mới hoặc môi trường động khi phù hợp, rồi kiểm tra bằng Golden Dataset nội bộ chưa xuất hiện công khai. Việc độ chính xác GSM8K giảm tới 13% sau khi lọc câu trùng lặp cho thấy đây là câu hỏi bắt buộc phải đặt.
Doanh nghiệp vừa và nhỏ có cần tự xây Custom Evaluation?
Có, nếu AI đã chạm vào khách hàng, dữ liệu nội bộ hoặc quy trình vận hành. Bộ đầu tiên không cần quá lớn: 100-200 ca thật đã đủ để phát hiện phần lớn chênh lệch giữa demo và Production. Điều quan trọng là các ca ấy đại diện đúng công việc, được Domain Expert chấm bằng tiêu chí rõ ràng.
SWE-bench Verified khác HumanEval thế nào khi chọn code assistant?
HumanEval và HumanEval+ thiên về sinh hàm theo bài kiểm thử. SWE-bench Verified gần bài toán sửa issue trong repository hơn, có bối cảnh và yêu cầu thực thi rộng hơn. Tuy nhiên, điểm SWE-bench có thể biến động tới 25% theo scaffold, nên hãy kiểm tra model trong repository và workflow của chính bạn trước khi kết luận.
Có nên chọn model đứng đầu Chatbot Arena Elo cho chatbot doanh nghiệp?
Chỉ nên dùng Elo như một tín hiệu về sở thích người dùng. Chatbot doanh nghiệp còn cần chính xác nghiệp vụ, tuân thủ chỉ thị, bám tài liệu RAG, tạo output đúng schema và xử lý dữ liệu an toàn. Một model được người dùng thích hơn trong Arena chưa chắc ít gây lỗi hơn trong quy trình của bạn.
Nguồn tham khảo: Benchmark AI là gì? Cẩm nang đọc hiểu chỉ số đánh giá LLM và chiến lược chọn mô hình chuẩn xác
Bài viết là góc nhìn cá nhân của tác giả, mang tính tham khảo — không phải tin tức báo chí.
📬 Nhận bài viết mới — miễn phí
Đừng bỏ lỡ bài viết tiếp theo. Đăng ký để nhận trong inbox.

Tác giả
Cường Nguyễn — AI Thực Chiến
Tôi là Cường Nguyễn - Founder của AI Ops Solutions.
Tôi từng là Logistics Operations Manager và đồng sáng lập thương hiệu CATCA - #1 Shopee ngành Pet Care.
10 năm kinh nghiệm Logistics/E-commerce OperationsCo-founder CATCA - #1 Shopee ngành Pet CareMột trong 300+ n8n Verified Creator toàn cầuTư vấn Giải pháp chuyển đổi số bằng AI cho 3 SMEs/quý


