Bài viết
Bài viết cá nhân
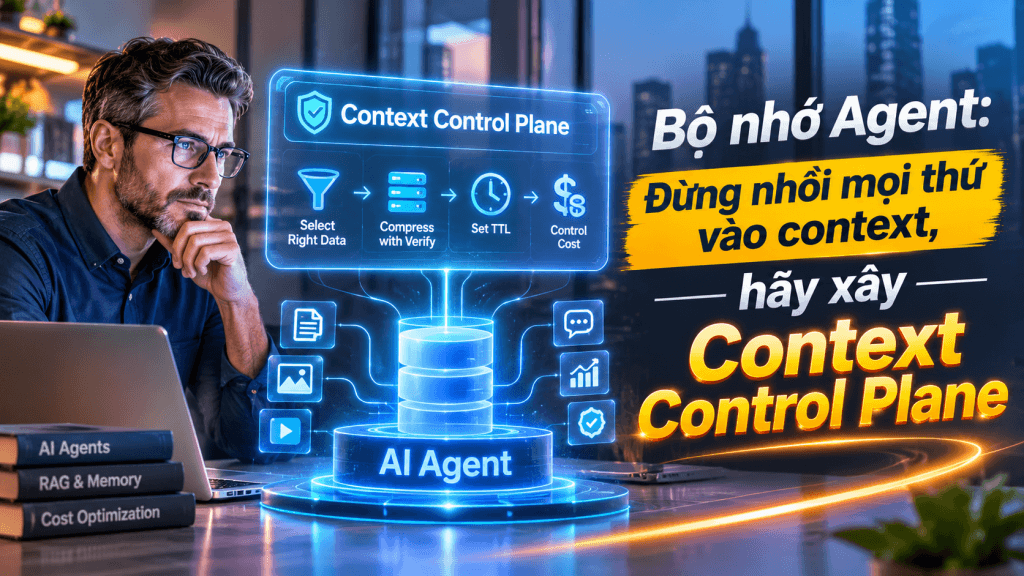
Bộ nhớ Agent: Đừng nhồi mọi thứ vào context, hãy xây Context Control Plane
👤 cuongnguyen📅 12/11/2026⏱ 18 phút đọc
Trong bài viết này(30 mục)⌄
- Vì sao agent chạy càng lâu càng dễ trả lời sai?
- Context, memory và knowledge không phải một thứ
- Từ viết prompt sang quản trị đầu vào
- Context Control Plane là gì và nằm ở đâu trong kiến trúc?
- Một bộ biên dịch trạng thái, không chỉ một hàm RAG
- Tách model khỏi bộ máy vận hành
- Bốn giai đoạn vòng đời ngữ cảnh
- Selection: chọn đúng trước khi chọn nhiều
- Injection: cấu trúc đầu vào để giảm nhầm lẫn
- Compression: nén nhưng không làm mất điều kiện
- Expiration: quên là một tính năng
- Bộ nhớ phân tầng: working, session và long-term
- Working memory là tài nguyên khan hiếm
- Session memory cần checkpoint
- Long-term memory không phải nhật ký bất tận
- Offloading, summarization và progressive disclosure dùng thế nào?
- Offloading: đưa nội dung lớn ra ngoài prompt
- Summarization: đừng đợi context đầy
- Progressive disclosure và subagent
- Bảy anti-pattern phá hỏng bộ nhớ agent
- Triển khai Context Control Plane bằng n8n cho SME
- Đo hiệu quả: giảm token chưa đủ
- Lộ trình triển khai: mua khả năng kiểm soát trước khi mua độ phức tạp
- Câu hỏi thường gặp
- Context Control Plane có thay thế RAG không?
- Agent có cửa sổ một triệu token còn cần nén và TTL không?
- Có nên lưu bộ nhớ dài hạn dưới dạng Markdown?
- Khi người dùng yêu cầu quên, cần xóa những gì?
- Khi nào chưa nên triển khai multi-agent có bộ nhớ?
- Kết luận: agent đáng tin phải biết quên đúng lúc
Tóm tắt cốt lõi: Agent chạy dài hạn không cần nhớ mọi thứ; nó cần một lớp quyết định dữ liệu nào được đưa vào model, với quyền hạn và thời hạn nào. Context Control Plane tách trạng thái khỏi model, phối hợp chọn lọc, tiêm, nén và hết hạn thông tin. Với SME, hãy bắt đầu bằng bộ nhớ phiên có cấu trúc, nguồn dữ liệu truy vết được và kiểm thử trước khi bổ sung vector database hay multi-agent.
Một model có cửa sổ 1 triệu token vẫn có thể bỏ sót yêu cầu khách hàng, dùng báo giá cũ hoặc quên rằng giao dịch cần phê duyệt. Dung lượng lớn không bảo đảm hệ thống chọn đúng dữ liệu, nhận ra mâu thuẫn hay phân biệt sự thật với suy đoán.
Trong workflow bán hàng, một phiên có thể chứa email, transcript cuộc gọi, kết quả CRM và nhiều phiên bản đề xuất. Nếu mỗi vòng đều nối thêm dữ liệu vào prompt, doanh nghiệp đang tích lũy cả thông tin hữu ích lẫn nhiễu. Agent phải đọc nhiều hơn nhưng chưa chắc biết điều gì còn hiệu lực.
Góc nhìn vận hành của tôi là: bộ nhớ agent trước hết là bài toán quản lý trạng thái. Model là bộ xử lý suy luận, không phải cơ sở dữ liệu nghiệp vụ. Bài viết này đi vào vòng đời dữ liệu, không bàn lại chuyện nhồi schema công cụ hay chỉ tối ưu giá token.
Vì sao agent chạy càng lâu càng dễ trả lời sai?
Trả lời nhanh: Agent chạy lâu dễ sai khi lịch sử tích tụ dữ liệu cũ, kết quả công cụ thừa và các chỉ dẫn mâu thuẫn. Cửa sổ lớn không tự giải quyết vấn đề. Hãy tách trạng thái tác vụ khỏi hội thoại, kiểm tra thời hạn dữ liệu và chỉ truy xuất thông tin cần cho quyết định hiện tại.
Context, memory và knowledge không phải một thứ
- Context: Dữ liệu thực sự được gửi vào một lần gọi model, gồm chỉ dẫn, trạng thái, bằng chứng và kết quả công cụ.
- Memory: Trạng thái được lưu giữa các lần gọi hoặc các phiên, như quyết định đã chốt, tiến độ và tùy chọn người dùng.
- Knowledge: Tri thức có thể truy xuất, như chính sách đổi trả, tài liệu sản phẩm và quy trình nghiệp vụ.
Lưu toàn bộ transcript chỉ tạo ra một kho lịch sử. Nó chưa tạo ra cơ chế xác định thông tin nào đáng tin, thuộc khách hàng nào và có còn được phép sử dụng hay không.
Nghiên cứu Lost in the Middle của Liu và cộng sự cho thấy hiệu quả sử dụng thông tin có thể phụ thuộc mạnh vào vị trí của nó trong ngữ cảnh dài. Kết quả này không có nghĩa mọi model mới đều suy giảm giống nhau, nhưng đủ để bác bỏ giả định: cứ đưa thêm dữ liệu là câu trả lời sẽ tốt hơn.
Từ viết prompt sang quản trị đầu vào
Prompt engineering điều chỉnh cách giao nhiệm vụ. Context engineering quyết định model được thấy gì khi thực hiện nhiệm vụ đó. Với agent production, phần thứ hai bao gồm cả phân quyền, truy xuất, ngân sách token, phiên bản dữ liệu và quy tắc xóa. Một prompt đẹp không sửa được số tồn kho đã hết hạn.
Context Control Plane là gì và nằm ở đâu trong kiến trúc?
Trả lời nhanh: Context Control Plane là lớp quản trị đầu vào suy luận: chọn dữ liệu, kiểm tra quyền, xếp hạng, định dạng, nén và loại bỏ thông tin hết hạn trước khi gọi model. Nó không thay cơ sở dữ liệu hay RAG; nó phối hợp chúng theo nhiệm vụ, ngân sách token và chính sách nghiệp vụ.

Tôi dùng thuật ngữ này như một mô hình kiến trúc đề xuất, không phải tên một tiêu chuẩn đã được chuẩn hóa. Control plane quản lý chính sách; pipeline thực thi chính sách có thể nằm trong cùng ứng dụng ở giai đoạn đầu.
Một bộ biên dịch trạng thái, không chỉ một hàm RAG
Luồng tối thiểu là: yêu cầu → xác định danh tính và tác vụ → đọc trạng thái → truy xuất bằng chứng → kiểm tra hiệu lực → dựng context → gọi model → kiểm chứng → lưu thay đổi. RAG giải quyết một phần truy xuất; nó không mặc nhiên giải quyết xung đột phiên bản hay quyền ghi bộ nhớ.
Mỗi bản ghi nên có tenant_id, subject_id, source_ref, observed_at, valid_until, version và trạng thái xác nhận. Khi một sự kiện không có thời hạn rõ ràng, hệ thống phải biết đó là quyết định có chủ ý hay dữ liệu chưa được phân loại.
Tách model khỏi bộ máy vận hành
Model đề xuất câu trả lời hoặc hành động; ứng dụng quyết định dữ liệu nào được đọc, cập nhật và xóa. Nhờ vậy, đổi provider không đồng nghĩa mất lịch sử nghiệp vụ. Bản tóm tắt, hồ sơ khách hàng và tài liệu gốc nằm trong storage doanh nghiệp kiểm soát, thay vì chỉ tồn tại trong một conversation ID.
Đừng hỏi agent nhớ được bao nhiêu. Hãy hỏi hệ thống có chứng minh được vì sao nó nhớ điều đó, và khi nào điều đó hết đúng hay không.
Bốn giai đoạn vòng đời ngữ cảnh
Selection: chọn đúng trước khi chọn nhiều
Dense retrieval phù hợp tìm nội dung gần nghĩa; BM25 hữu ích với mã hàng, tên riêng và chuỗi chính xác; duyệt quan hệ giúp nối khách hàng, hợp đồng và chính sách. Không phải SME nào cũng cần knowledge graph riêng: vài bảng quan hệ được thiết kế tốt có thể đủ.
Áp dụng bộ lọc tenant và quyền truy cập ngay trong truy vấn nếu hệ lưu trữ hỗ trợ. Sau đó mới xếp hạng theo độ liên quan, độ mới và độ tin cậy. Không truy xuất toàn bộ kho rồi trông chờ model tự bỏ dữ liệu của khách hàng khác.
Injection: cấu trúc đầu vào để giảm nhầm lẫn
Tách rõ chính sách, yêu cầu hiện tại, trạng thái đã xác nhận và bằng chứng tham khảo. Nội dung từ email hay website phải được đánh dấu là dữ liệu không đáng tin cậy, không phải chỉ dẫn hệ thống. Đây cũng là ranh giới giảm nguy cơ prompt injection.
Thứ tự và template cần được kiểm thử trên model thực tế. Một cấu trúc hữu ích là đặt mục tiêu và ràng buộc rõ ràng, gom bằng chứng theo nguồn, rồi yêu cầu đầu ra có trường tham chiếu. Không có thứ tự duy nhất bảo đảm hiệu quả cho mọi model.
Compression: nén nhưng không làm mất điều kiện
Model nhỏ có thể tạo bản tóm tắt, nhưng kiểm tra phải tập trung vào sự kiện bắt buộc được bảo toàn: số tiền, hạn chót, điều kiện ngoại lệ, yêu cầu phê duyệt. Chỉ số phân phối như perplexity hoặc KL divergence không tự chứng minh bản tóm tắt đúng nghiệp vụ.
Expiration: quên là một tính năng
Tồn kho và giá có thể cần làm mới trong phút–giờ; trạng thái phiên kết thúc theo tác vụ; chính sách lõi sống lâu hơn nhưng cần ngày tái kiểm chứng. TTL là thời hạn được dùng cho quyết định, không nhất thiết là thời hạn phải xóa bản ghi kiểm toán. Hai chính sách này cần tách riêng.
Bộ nhớ phân tầng: working, session và long-term
Không có một kho lưu trữ tối ưu cho mọi loại trạng thái. Bảng dưới là cấu hình tham khảo để thiết kế, không phải cam kết hiệu năng hay báo giá thị trường.
| Tầng / phương án | Dữ liệu nên giữ | Vòng đời và kiểm soát | Chi phí, đánh đổi | Khuyến nghị SME |
|---|---|---|---|---|
| Working context | Mục tiêu, trạng thái hiện tại, bằng chứng cần thiết | Dựng lại mỗi lần gọi; có ngân sách token | Tính phí lặp lại theo đầu vào; quá nhiều gây nhiễu | Đặt ngân sách theo loại tác vụ, không dùng hết cửa sổ mặc định |
| Session memory | Bước đang chạy, tham số đã xác nhận, mã tác vụ | TTL theo phiên; checkpoint sau chuyển trạng thái | Cần chống ghi đè và phục hồi sau lỗi | Redis hoặc PostgreSQL, kèm version và task_id |
| Long-term memory | Tùy chọn, sự kiện đã xác minh, chính sách | Lưu bền vững; tái kiểm chứng theo loại dữ liệu | Tốn quản trị chất lượng, phân quyền và xóa | Bắt đầu bằng dữ liệu có cấu trúc và tài liệu có phiên bản |
| Artifact store | Transcript, báo cáo dài, kết quả công cụ gốc | Retention riêng; quyền đọc theo tenant | Giảm tải context nhưng phát sinh truy xuất và I/O | Object storage riêng tư, preview kèm tham chiếu |
| Context của subagent | Bằng chứng cục bộ cho nhiệm vụ chuyên biệt | Kết thúc theo nhiệm vụ con; trả đầu ra giới hạn | Tăng số lần gọi và công điều phối | Chỉ tách khi nhiệm vụ độc lập, có hợp đồng đầu ra |
Working memory là tài nguyên khan hiếm
Đặt trần riêng cho chính sách, trạng thái, bằng chứng và phần dự phòng cho đầu ra. Nếu bằng chứng vượt ngân sách, hệ thống phải ưu tiên hoặc yêu cầu đọc tiếp; không được cắt chuỗi tùy tiện làm mất đơn vị tiền hay điều kiện hợp đồng.
Session memory cần checkpoint
Với Redis, cần quyết định cấu hình bền vững và khả năng mất dữ liệu có chấp nhận được không. Với PostgreSQL, dễ gắn trạng thái với giao dịch nghiệp vụ hơn. Dù chọn gì, dùng version hoặc optimistic locking để hai worker không ghi đè tiến độ của nhau.
Long-term memory không phải nhật ký bất tận
Chỉ đưa sự kiện đủ điều kiện vào bộ nhớ dài hạn. “Khách hàng hỏi giao cuối tuần” khác “khách hàng luôn muốn giao cuối tuần”. Một câu nói trong phiên không tự trở thành sở thích bền vững. Cần lưu nguồn, phạm vi áp dụng và cơ chế sửa sai.
Offloading, summarization và progressive disclosure dùng thế nào?
Các kỹ thuật trong hệ sinh thái Deep Agents minh họa cách giảm tải context. Có thể đối chiếu triển khai tại kho mã nguồn Deep Agents của LangChain. Hành vi middleware và giá trị mặc định có thể thay đổi; cần kiểm tra phiên bản cài đặt trước khi sử dụng các mốc dưới đây.
Offloading: đưa nội dung lớn ra ngoài prompt
Các mốc 20.000 token cho kết quả tool và 50.000 token cho thông điệp người dùng trong tư liệu nghiên cứu là điểm tham khảo triển khai, không phải giới hạn của LLM hay tiêu chuẩn chung. Nguyên tắc là lưu nội dung gốc thành artifact, chỉ gửi preview và tham chiếu để đọc từng phần.
Ví dụ, báo cáo công cụ có thể được lưu theo mẫu /large_tool_results/{tool_call_id}. Preview nên cho biết nội dung, phạm vi thời gian và cách truy cập. Chỉ lấy đầu/cuối tài liệu có thể bỏ sót dữ kiện giữa; vì vậy cần hỗ trợ tìm kiếm hoặc đọc theo đoạn, không chỉ cung cấp đường dẫn.
Summarization: đừng đợi context đầy
Mốc kích hoạt 85% cửa sổ cũng chỉ là tham khảo cấu hình. Tác vụ nhiều tool call có thể cần nén sớm hơn để còn chỗ cho kết quả tiếp theo và đầu ra. Giữ nguyên yêu cầu mới nhất, tóm tắt phần cũ, đồng thời bảo toàn bản gốc để truy hồi khi có tranh chấp.
Một summary tốt phải phân biệt đã xác nhận, đang suy đoán, đang chờ và đã bị thay thế. Nếu bốn nhóm bị trộn, nén chỉ làm sai lệch lan truyền nhanh hơn.
Progressive disclosure và subagent
Với skills, nạp tên và mô tả trước, nội dung đầy đủ khi cần. Với subagent, cô lập công việc ồn ào như đọc nhiều tài liệu. Tuy nhiên, đầu ra không nên chỉ là kết luận: cần thêm bằng chứng, giới hạn và trạng thái hoàn thành để agent chính có thể kiểm tra.
Bảy anti-pattern phá hỏng bộ nhớ agent
- Context stuffing: Nối mọi lịch sử vào prompt. Khắc phục bằng ngân sách theo tác vụ, truy xuất chọn lọc và artifact store.
- Generic retrieval: Dùng cùng một truy vấn cho mọi quyết định. Khắc phục bằng truy vấn theo bước, lọc metadata và kiểm tra nguồn.
- Stale data loops: Bản tóm tắt cũ được đọc rồi ghi lại như thông tin mới. Giữ nguyên thời điểm quan sát gốc; không gia hạn TTL chỉ vì đã đọc.
- Implicit/explicit mismatch: Suy luận của model ghi đè thông tin người dùng xác nhận. Đặt thứ bậc nguồn và giữ nhãn chưa xác minh.
- Unbounded memory growth: Lưu mọi thứ vô thời hạn. Áp dụng retention, quota, hợp nhất trùng lặp và quy trình xóa.
- Cross-tenant leakage: Chỉ lọc khách hàng bằng prompt. Thực thi ranh giới truy cập tại database, công cụ và artifact store.
- Summary laundering: Nội dung độc hại được tóm tắt thành chỉ dẫn có vẻ hợp lệ. Không nâng quyền dữ liệu khi nén; giữ nguồn và lớp tin cậy.
Một lỗi khó thấy là refresh giả: agent đọc giá cũ lúc 10 giờ rồi lưu lại với timestamp 10 giờ. Hệ thống tưởng giá vừa được kiểm tra. Cần tách observed_at, stored_at và last_verified_at; chỉ lần kiểm tra nguồn có thẩm quyền mới cập nhật thời điểm xác minh.
Triển khai Context Control Plane bằng n8n cho SME
Lấy workflow xử lý yêu cầu báo giá: đọc email, xác định khách hàng, tra sản phẩm, lấy giá và tạo bản nháp. Không cần bắt đầu bằng multi-agent. n8n có thể điều phối các bước, còn dữ liệu nghiệp vụ nằm trong hệ lưu trữ riêng.
- Định danh: Nhận sự kiện, xác thực tenant, tạo task_id và khóa chống xử lý trùng.
- Nạp trạng thái: Đọc checkpoint trong PostgreSQL; lấy cache còn hiệu lực nếu có.
- Thu thập bằng chứng: Truy xuất CRM, chính sách và giá bằng credential giới hạn quyền.
- Dựng context: Dùng node xử lý xác định để lọc TTL, chọn trường, tính ngân sách và gắn source_ref.
- Suy luận và kiểm tra: Yêu cầu đầu ra có schema; kiểm tra giá, mã hàng, quyền chiết khấu bằng logic ngoài model.
- Ghi và kết thúc: Lưu checkpoint, bản nháp, tham chiếu bằng chứng; chuyển người duyệt khi vượt ngưỡng.
Tách thành công của workflow khỏi thành công của nghiệp vụ. Một lần gọi model hoàn tất không chứng minh báo giá hợp lệ. Khi retry, thao tác gửi email hay tạo đơn phải có idempotency key để tránh lặp hành động.
Nếu kết nối công cụ qua MCP, cần nhớ rằng giao thức không tự quản lý vòng đời bộ nhớ. Bài kiến trúc MCP dành cho người làm automation giúp phân biệt lớp kết nối với lớp kiểm soát trạng thái này.
Đo hiệu quả: giảm token chưa đủ
Trả lời nhanh: Chỉ tối ưu bộ nhớ khi đồng thời đo chất lượng và chi phí. Bộ chỉ số tối thiểu gồm tỷ lệ hoàn thành đúng, độ chính xác của sự kiện truy hồi, tỷ lệ dùng dữ liệu hết hạn, token mỗi tác vụ và độ trễ p95. So sánh trên cùng tập tình huống trước khi triển khai.
Không nên lấy tỷ lệ adoption từ khảo sát làm mục tiêu vận hành. Một SME cần biết agent có giữ đúng điều kiện báo giá sau nhiều lượt trao đổi hay không, chứ không chỉ biết bao nhiêu doanh nghiệp khác đã triển khai agent.
- Task success: Hoàn tất nghiệp vụ theo tiêu chí có thể kiểm tra, không chỉ tạo được câu trả lời.
- Memory precision: Bao nhiêu sự kiện được truy hồi là đúng, đúng chủ thể và còn hiệu lực.
- Critical fact retention: Bao nhiêu điều kiện bắt buộc vẫn tồn tại sau nén.
- Stale-action rate: Bao nhiêu hành động dựa trên dữ liệu quá hạn.
- p95 latency: Độ trễ đuôi của cả truy xuất, nén, đọc artifact và retry.
Một bộ kiểm thử ban đầu nên có 50–100 tình huống được gán nhãn; đây là đề xuất khởi động, không bảo đảm độ tin cậy thống kê cho mọi hệ thống. Bổ sung ca xung đột, đổi yêu cầu giữa phiên, tài liệu chứa chỉ dẫn độc hại và yêu cầu xóa bộ nhớ.
Ví dụ giả định: giảm đầu vào từ 20.000 xuống 8.000 token là giảm 60% phần token đầu vào. Nhưng tổng chi phí không nhất thiết giảm tương ứng vì còn lần gọi tóm tắt, embedding, storage và công kiểm tra. Nếu tỷ lệ hoàn tất giảm, phương án mới có thể đắt hơn.
Lộ trình triển khai: mua khả năng kiểm soát trước khi mua độ phức tạp
Với SME, chi phí đáng kể thường nằm ở dữ liệu và vận hành: sửa chính sách, xử lý quyền, kiểm tra summary, điều tra lỗi và xóa bản sao. Không có một bảng giá token nào thay thế được các hạng mục này.
- Tuần 1: Chọn một workflow, xác định nguồn sự thật, phân loại trạng thái và xây baseline không có bộ nhớ dài hạn.
- Tuần 2: Thêm checkpoint, TTL, provenance và artifact store; đo lại trên cùng bộ kiểm thử.
- Tuần 3: Thêm truy xuất chọn lọc và nén có kiểm chứng nếu dữ liệu thực sự vượt ngân sách.
- Tuần 4: Canary với lưu lượng hạn chế, theo dõi lỗi và chuẩn bị rollback về cấu hình cũ.
Chỉ thêm vector database khi tìm kiếm ngữ nghĩa giải quyết vấn đề rõ ràng. Chỉ thêm subagent khi việc phân tách cải thiện chất lượng hoặc độ trễ sau khi tính cả điều phối. Lựa chọn hạ tầng nên được đặt trong bài toán TCO giữa AI tự vận hành và AI cloud, không chỉ dựa trên giá model.
Với đội CSKH hoặc sales, hãy nối chỉ số bộ nhớ với kết quả như độ chính xác báo giá và tỷ lệ giải quyết. Khung tính ROI cho chatbot và voice agent SME giúp tránh biến tối ưu kỹ thuật thành mục tiêu tách rời kinh doanh.
Câu hỏi thường gặp
Context Control Plane có thay thế RAG không?
Không. RAG cung cấp bằng chứng từ kho tri thức; Context Control Plane quyết định truy xuất khi nào, theo quyền nào, chọn phiên bản nào và đưa bao nhiêu vào model. Một hệ thống RAG đơn giản có thể chỉ cần vài hàm chính sách, chưa cần tách thành dịch vụ độc lập.
Agent có cửa sổ một triệu token còn cần nén và TTL không?
Có. Cửa sổ lớn mở rộng khả năng tiếp nhận, không xác nhận độ mới hay tính hợp lệ. TTL ngăn quyết định dựa trên dữ liệu quá hạn; nén giảm nhiễu và tải xử lý. Tuy nhiên, tài liệu cần đối chiếu chi tiết phải giữ bản gốc và cơ chế đọc lại.
Có nên lưu bộ nhớ dài hạn dưới dạng Markdown?
Markdown phù hợp ghi chú dễ đọc và tri thức nhỏ, nhưng không nên là nơi duy nhất lưu số dư, quyền truy cập hay trạng thái giao dịch. Những dữ liệu này cần schema, ràng buộc và kiểm soát cập nhật. Có thể sinh bản Markdown từ nguồn có cấu trúc để model sử dụng.
Khi người dùng yêu cầu quên, cần xóa những gì?
Phải xét dữ liệu gốc, cache, embedding, summary, artifact và chỉ mục liên quan. Với bản sao lưu hoặc hồ sơ bắt buộc lưu theo pháp luật, cần chính sách retention và hạn chế sử dụng rõ ràng. Xóa một dòng memory không bảo đảm mọi bản dẫn xuất đã biến mất.
Khi nào chưa nên triển khai multi-agent có bộ nhớ?
Khi tác vụ còn tuyến tính, nguồn sự thật chưa rõ hoặc đội vận hành chưa có evaluation. Multi-agent làm tăng số lần gọi, điểm ghi trạng thái và khả năng xung đột. Hãy chứng minh một agent với trạng thái có cấu trúc đã đạt chất lượng trước khi phân tán công việc.
Kết luận: agent đáng tin phải biết quên đúng lúc
Context là đầu vào được quản trị, không phải nơi đổ mọi lịch sử. Bộ nhớ tốt phải trả lời được dữ liệu đến từ đâu, thuộc về ai, còn hiệu lực không và có thể xóa bằng cách nào.
Ưu tiên thực tế là tách trạng thái khỏi model, lưu bằng chứng gốc, đặt TTL theo nghiệp vụ và kiểm thử trước mỗi thay đổi nén hay truy xuất. Các ngưỡng 20.000, 50.000 token hay 85% chỉ hữu ích khi phù hợp phiên bản triển khai và workload của bạn.
Agent đáng tin không phải agent nhớ nhiều nhất. Đó là agent được hệ thống cấp đúng thông tin cho quyết định hiện tại — và không tiếp tục hành động trên những điều đã hết đúng.
Tác giả: Cường Nguyễn — Founder AI Ops Solutions | Verified n8n Creator. Kết nối: Facebook · LinkedIn · YouTube · TikTok
Bài viết là góc nhìn cá nhân của tác giả, mang tính tham khảo — không phải tin tức báo chí.
📬 Nhận bài viết mới — miễn phí
Đừng bỏ lỡ bài viết tiếp theo. Đăng ký để nhận trong inbox.
Tác giả
Cường Nguyễn — AI Thực Chiến
Tôi là Cường Nguyễn - Founder của AI Ops Solutions.
Tôi từng là Logistics Operations Manager và đồng sáng lập thương hiệu CATCA - #1 Shopee ngành Pet Care.
10 năm kinh nghiệm Logistics/E-commerce OperationsCo-founder CATCA - #1 Shopee ngành Pet CareMột trong 300+ n8n Verified Creator toàn cầuTư vấn Giải pháp chuyển đổi số bằng AI cho 3 SMEs/quý