Bài viết
Bài viết cá nhân
AI mã nguồn mở hay AI cloud: đừng mua GPU trước khi tính 36 tháng
👤 cuongnguyen📅 15/08/2026⏱ 17 phút đọc
Trong bài viết này(15 mục)⌄
- AI mã nguồn mở hay AI cloud: câu hỏi thực sự là gì?
- Tóm tắt nhanh: local thắng ở đâu, cloud thắng ở đâu?
- Giá GPU không phải chi phí inference
- Hãy tính TCO từ workload, không tính từ cấu hình máy
- Latency: local không mặc định nhanh hơn cloud
- Chất lượng model quyết định chi phí nhiều hơn giá hạ tầng
- Quyền kiểm soát dữ liệu là lý do hợp lệ, nhưng không phải lá bùa
- Ba quyết định thực tế tôi sẽ đưa ra
- Checklist 36 tháng trước khi ký hợp đồng hoặc mua GPU
- Câu hỏi thường gặp
- Chạy model local có chắc rẻ hơn gọi AI cloud không?
- Cam kết GPU ba năm có nên chọn vì giảm khoảng 50–60%?
- H200 reserved khoảng 2.016 USD/tháng có phải là mốc hòa vốn?
- Doanh nghiệp không có đội MLOps nên đi hướng nào?
- Có nên mua RTX 5090 hoặc workstation RTX 5090 đôi để thử nghiệm?
AI mã nguồn mở hay AI cloud: câu hỏi thực sự là gì?
Tôi thấy nhiều đội kỹ thuật mắc cùng một lỗi: lấy giá một GPU rồi đặt cạnh giá API, sau đó kết luận self-hosted rẻ hơn hoặc cloud đắt quá. Cách tính ấy nghe hợp lý trong một slide, nhưng đưa vào vận hành thì thiếu gần hết phần quan trọng.
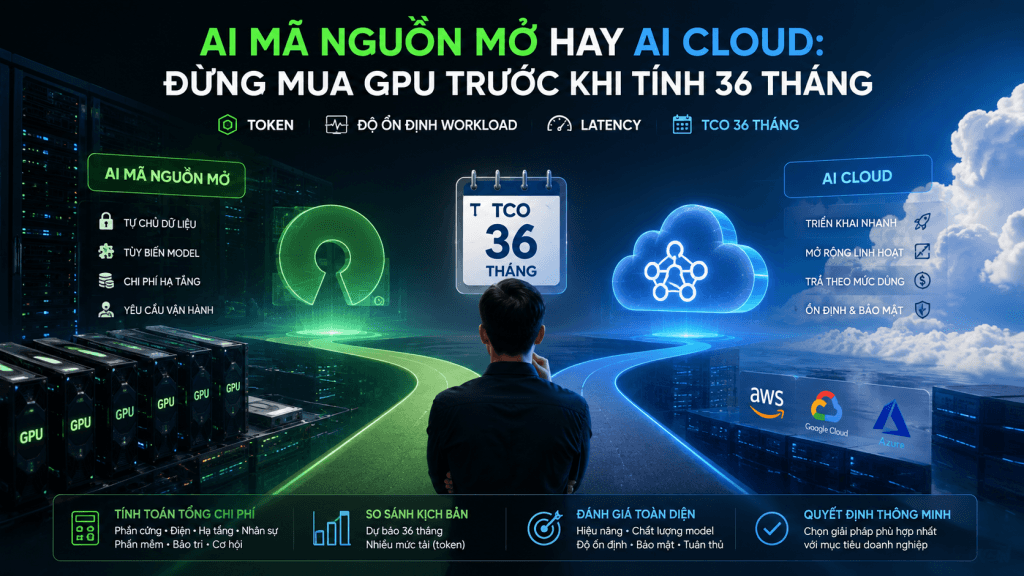
Câu hỏi đúng không phải là “mua GPU hay gọi API rẻ hơn?”. Câu hỏi đúng là: trong 12 đến 36 tháng, hệ thống nào tạo ra chất lượng đầu ra chấp nhận được với tổng chi phí sở hữu thấp hơn và ít rủi ro vận hành hơn?
Tổng chi phí sở hữu, hay TCO, gồm tiền GPU, tiền máy chủ, điện, làm mát, network, lưu trữ, giám sát, nhân sự xử lý sự cố, thời gian triển khai, thời gian cập nhật model và cả chi phí của những lần hệ thống chậm hoặc ngừng phục vụ. API cloud cũng có TCO: chi phí token, chi phí tích hợp, chi phí fallback, chi phí quan sát chất lượng đầu ra và chi phí bị khóa vào một nhà cung cấp nếu thiết kế quá cẩu thả.
Điểm tôi muốn nói thẳng: đừng chọn một phe theo niềm tin. “AI cloud luôn đắt” sai. “Open-weight chạy local là miễn phí” cũng sai. GPU đã mua vẫn phải được vận hành. Model tải về vẫn cần hạ tầng. Và một model có thể chạy được không đồng nghĩa nó đáp ứng được SLA của sản phẩm.
Khái niệm cũng cần tách bạch. Open-weight nói về việc có weights để tải và triển khai. Self-hosted nói về nơi bạn chạy inference. Cloud API nói về việc gọi model qua API của nhà cung cấp. Một model open-weight có thể chạy trên máy cá nhân, bare-metal, colocation hoặc GPU cloud. Ngược lại, dùng GPU cloud để tự chạy model không biến kiến trúc đó thành API cloud theo nghĩa thuê model đóng gói.
Đây cũng là lý do tôi khuyên đọc kỹ phần giấy phép và lớp triển khai, thay vì chỉ nhìn chữ “open”. AI mở không miễn phí; phần tốn tiền thường nằm ở hạ tầng, vận hành và quyền sử dụng thực tế, không nằm ở nút tải model.
Tóm tắt nhanh: local thắng ở đâu, cloud thắng ở đâu?
Nếu buộc phải đưa ra một quyết định nhanh cho đa số đội nhỏ, tôi chọn cloud API trước. Không phải vì cloud luôn rẻ hơn, mà vì nó mua cho bạn tốc độ thử nghiệm và tránh một loạt bài toán vận hành khi chưa biết workload thật có tồn tại hay không.
Self-hosted bắt đầu thuyết phục khi ba điều cùng xuất hiện: sản lượng token đủ lớn, workload đều và dự đoán được, đội ngũ có khả năng vận hành hạ tầng inference. Thiếu một trong ba điều này, GPU riêng rất dễ thành tài sản đắt tiền nhưng nhàn rỗi.
Cloud hợp với lưu lượng thấp, lưu lượng biến động mạnh, sản phẩm còn đang tìm product-market fit, hoặc những tác vụ cần chất lượng model cao nhất mà đội ngũ không muốn tự gánh phần serving. Bạn trả tiền theo mức sử dụng và đổi lại có thể thay model nhanh hơn. Cái giá của sự linh hoạt là biên chi phí khó kiểm soát nếu ứng dụng bơm token vô kỷ luật.
Local hoặc self-hosted hợp với workload lặp lại, cần kiểm soát đường đi của dữ liệu, có tải ổn định và có thể chuẩn hóa model phục vụ một nhóm tác vụ hẹp. Khi ấy, chi phí cố định của hạ tầng được dàn lên sản lượng lớn hơn. Nhưng đừng gọi đây là tiết kiệm nếu GPU chỉ bận vài giờ rồi nằm im phần còn lại của ngày.
Phương án tôi thích nhất trong thực tế là hybrid. Đưa các yêu cầu dễ, có cấu trúc, lặp lại sang model tự vận hành; giữ những yêu cầu khó, cần reasoning sâu, context dài hoặc cần năng lực model mà local chưa đáp ứng cho cloud. Hybrid không phải dấu hiệu thiếu quyết đoán. Nó là cách không bắt một hạ tầng phải giải mọi bài toán.
- Cloud trước nếu bạn đang khám phá use case, chưa có số liệu token thật hoặc không có người chịu trách nhiệm hạ tầng inference.
- Self-hosted trước nếu workload đã rõ, chạy đều, dữ liệu có yêu cầu kiểm soát nghiêm ngặt và đội có năng lực vận hành.
- Hybrid nếu bạn có nhiều loại tác vụ và muốn giảm chi phí mà không hy sinh chất lượng ở những chỗ quan trọng.
Giá GPU không phải chi phí inference
Dữ liệu tham chiếu của SitePoint cho thấy mặt bằng GPU cloud giữa năm 2026 đã có khoảng cách rất lớn tùy cấu hình và kiểu cam kết. NVIDIA H200 on-demand được ước tính khoảng 4,50–6,00 USD/giờ. Cấu hình tương đương tại Lambda Labs và CoreWeave ở mức 3,50–4,50 USD/giờ. B200 ở khoảng 6,00–8,50 USD/giờ; GB200 NVL2 ở khoảng 10–14 USD/giờ.
Nhìn vào các số này, nhiều người sẽ làm phép nhân với 24 giờ rồi hoảng. Hoảng là đúng nếu workload buộc bạn chạy liên tục mà không dùng hết công suất. Một H200 reserved khoảng 2,80 USD/giờ, tương đương khoảng 2.016 USD/tháng khi chạy liên tục. Con số ấy không nói rằng H200 đắt hay rẻ. Nó chỉ nói rằng bạn cần có lý do rất rõ để giữ một GPU chạy xuyên tháng.
Cam kết làm thay đổi bài toán mạnh. Theo ước tính được nêu, cam kết một năm có thể giảm 30–40%, còn ba năm giảm khoảng 50–60%. Nhưng giảm giá không phải tiết kiệm nếu bạn cam kết với một nhu cầu chưa được chứng minh. Tôi không thích ký dài hạn chỉ vì bảng tính cho ra giá đẹp. Workload LLM thay đổi nhanh; model, yêu cầu chất lượng và kiểu truy vấn cũng đổi nhanh.
Bare-metal có vẻ hấp dẫn hơn khi nhìn tiền tháng. Một máy chủ với A6000 Ada 48GB được ước tính 400–700 USD/tháng. Máy chủ dual hoặc quad H100 có thể ở mức 4.000–10.000 USD/tháng. Nhưng tiền thuê máy mới là phần nhìn thấy. Bạn còn phải hỏi: ai cài serving stack, ai theo dõi memory, ai xử lý khi model không load được, ai chịu trách nhiệm khi người dùng đồng thời tăng lên và latency nhảy vọt?
Tự mua phần cứng cũng không phải phép màu. RTX 5090 được nêu ở khoảng 2.000–2.500 USD, A6000 Ada ở khoảng 4.500–5.500 USD, còn H100 SXM đã qua sử dụng là 15.000–20.000 USD cho mỗi GPU. Một workstation RTX 5090 đôi có thể ở khoảng 6.000–8.000 USD. Mac Studio M4 Ultra 192GB được nêu trong khoảng 8.000–15.000 USD.
Đừng biến các mức giá đó thành bảng xếp hạng “mua gì ngon nhất”. Chúng là đầu vào của TCO. Giá mua là chi phí một lần; nhu cầu inference là bài toán diễn ra mỗi ngày. Nếu đội của bạn không có đủ tải để khai thác phần cứng, GPU rẻ vẫn là GPU đắt.
Hãy tính TCO từ workload, không tính từ cấu hình máy
Tôi thường bắt đầu bằng một bảng rất đơn giản, không hỏi model trước. Hỏi workload trước. Mỗi dòng là một use case: chatbot nội bộ, trích xuất tài liệu, phân loại ticket, hỗ trợ viết nội dung, AI Agent gọi tool, hoặc trợ lý cho đội chăm sóc khách hàng. Với từng use case, ghi lại lượng token, mức dao động theo thời gian, mức độ nhạy cảm dữ liệu, latency chấp nhận được và hậu quả khi đầu ra sai.
Sau đó mới đưa chi phí vào công thức:
TCO self-hosted = phần cứng hoặc tiền thuê + điện và làm mát + colocation hoặc network + lưu trữ + software + thời gian vận hành + chi phí downtime.
Với cloud, công thức ngắn hơn ở phần hạ tầng nhưng không được bỏ qua phần thiết kế:
TCO cloud = chi phí API theo token + network và tích hợp + observability + fallback + chi phí kiểm soát usage + chi phí thay đổi nhà cung cấp.
Hai công thức này không thể so bằng một con số giả định đẹp. Bạn cần số liệu thực của chính mình: token input và output, tần suất gọi, số yêu cầu đồng thời, thời gian cao điểm và yêu cầu phục hồi khi lỗi. Không có các biến ấy, mọi kết luận “điểm hòa vốn” chỉ là phỏng đoán.
Có một bẫy tâm lý rất phổ biến: đội kỹ thuật tính công suất trung bình, còn người dùng tạo tải theo đỉnh. Nếu hạ tầng local chỉ đủ cho lưu lượng trung bình, bạn vẫn phải mua thêm năng lực cho peak hoặc chấp nhận hàng đợi. Nếu thuê GPU đủ cho peak nhưng peak hiếm khi xảy ra, bạn lại trả tiền cho thời gian nhàn rỗi. Cloud API hấp thụ kiểu biến động này tốt hơn về mặt kiến trúc; self-hosted chỉ thắng khi tải đủ đều hoặc bạn có cách dùng chung năng lực giữa nhiều workload.
Nhân sự là chỗ nhiều bảng tính cố tình để bằng 0. Nó không bằng 0. Một hệ thống self-hosted cần người hiểu deployment, capacity, cập nhật, logging, phân quyền và xử lý sự cố. Nếu bạn đã có người làm việc đó cho hệ thống khác, phần chi phí tăng thêm có thể thấp. Nếu bạn phải tuyển hoặc thuê ngoài chỉ để giữ một model chạy ổn định, giả định “local rẻ” gần như cần làm lại từ đầu.

Latency: local không mặc định nhanh hơn cloud
“Chạy local sẽ nhanh hơn vì không đi qua Internet” là một nửa sự thật. Đúng, inference gần người dùng hoặc trong cùng mạng có thể cắt phần round-trip network. Nhưng latency mà người dùng cảm nhận còn phụ thuộc server có đang bận không, model có được giữ sẵn trong memory không, có bao nhiêu yêu cầu đồng thời và hệ thống có đang xếp hàng không.
Máy local cho một người dùng có thể phản hồi rất tốt. Đưa cùng máy ấy cho cả phòng ban, bài toán đổi hẳn. Khi concurrency tăng, throughput, batching và hàng đợi mới là thứ quyết định. Một demo trên laptop không phải benchmark production. Nó không cho bạn biết P99 latency lúc nhiều người cùng gửi prompt dài.
Vì vậy benchmark phải dùng prompt thật, độ dài thật, cách người dùng thật sự thao tác. Đừng lấy một prompt ngắn để đo rồi suy ra chatbot nội bộ có dữ liệu dài cũng sẽ ổn. Đừng lấy tốc độ sinh token của một lượt chạy rỗng để kết luận hệ thống chịu được tải. Và cũng đừng đánh giá cloud chỉ bằng một lần gọi API lúc mạng văn phòng đang chập chờn.
Tôi xem latency theo hai lớp. Lớp đầu là thời gian bắt đầu phản hồi: người dùng có cảm giác hệ thống đang làm việc hay bị treo? Lớp sau là thời gian hoàn thành: yêu cầu dài có kết thúc trong mức chấp nhận được không? Có use case chịu được chờ lâu hơn vì đầu ra có giá trị cao. Có use case như hỗ trợ tác nghiệp thì vài giây chờ đợi đã phá trải nghiệm. Cùng là LLM nhưng quyết định hạ tầng có thể khác hẳn.
Nếu bạn đang xây AI Agent, đừng chỉ tính một lần inference. Agent có thể gọi model nhiều lượt, gọi tool, đọc dữ liệu rồi quay lại gọi model. Chỗ cần tối ưu thường là cả Workflow, không phải riêng GPU. Bài về điều phối AI Agents cũng đi đến một ý tương tự: orchestration có kiểm soát quan trọng hơn việc thêm nhiều thành phần cho có vẻ hiện đại.
Chất lượng model quyết định chi phí nhiều hơn giá hạ tầng
Đây là điểm các đội mê self-hosted hay bỏ qua nhất. Một model local rẻ nhưng trả lời sai nhiều, cần prompt dài hơn, cần retry nhiều hơn hoặc buộc con người sửa đầu ra thì không hề rẻ. Chi phí thật phải tính cả số lần hệ thống không giải quyết được công việc.
Tôi không xem câu hỏi là “model open-weight có bằng model cloud không?”. Câu hỏi hữu ích hơn là: model này có đủ tốt cho tác vụ cụ thể của tôi không? Một tác vụ hẹp, đầu ra có schema, tiêu chí kiểm tra rõ và dữ liệu tương đối lặp lại có thể phù hợp để tự vận hành. Một tác vụ mở, cần suy luận nhiều bước, phải hiểu ngữ cảnh lớn hoặc có yêu cầu chất lượng cao hơn thì cloud thường là lựa chọn an toàn để bắt đầu.
Điều này dẫn tới cách làm thực dụng: chia workload theo độ khó và giá trị. Đừng để mọi truy vấn mặc định đi vào model đắt nhất. Cũng đừng ép mọi truy vấn đi qua model local chỉ để chứng minh đầu tư GPU là đúng. Model router tốt bắt đầu từ các quy tắc giản dị: dữ liệu nào nhạy cảm, yêu cầu nào có cấu trúc, yêu cầu nào cần chất lượng cao, yêu cầu nào cần xử lý ngay.
Chất lượng cũng cần benchmark bằng dữ liệu của công ty. Benchmark công khai có ích để chọn danh sách ngắn, nhưng không thay thế được tập kiểm thử nội bộ. Lấy các yêu cầu đã được ẩn dữ liệu nhạy cảm, định nghĩa thế nào là đúng, thế nào là chấp nhận được, thế nào là nguy hiểm. Chạy cùng tập đó trên các lựa chọn bạn đang cân nhắc. Khi chưa có tập đánh giá, cuộc tranh luận model thường dựa vào cảm giác.
Quyền kiểm soát dữ liệu là lý do hợp lệ, nhưng không phải lá bùa
Self-hosted cho bạn quyền kiểm soát lớn hơn về nơi inference diễn ra và cách dữ liệu di chuyển. Với một số workload, lý do này đủ mạnh để chấp nhận chi phí cao hơn. Nhưng tự chạy model không tự động tạo ra hệ thống bảo mật.
Bạn vẫn phải quản lý quyền truy cập, log, secrets, network, lưu trữ prompt, bản sao dữ liệu và quy trình xử lý sự cố. Nếu dữ liệu nhạy cảm đi qua RAG, rủi ro không chỉ nằm ở model. Nó còn nằm ở kho tài liệu, embedding, pipeline index và quyền người dùng được phép truy xuất nội dung nào.
Vì vậy tôi không khuyên dùng câu “dữ liệu nhạy cảm nên local” như một luật tuyệt đối. Câu đúng hơn là: dữ liệu nhạy cảm cần có kiến trúc dữ liệu, kiểm soát truy cập và đường đi có thể kiểm toán. Self-hosted có thể hỗ trợ mục tiêu đó. Cloud có thể phù hợp ở phần dữ liệu đã được lọc, ẩn danh hoặc không chứa nội dung cần bảo vệ. Hybrid thường cho đội ngũ nhiều lựa chọn hơn.
Ba quyết định thực tế tôi sẽ đưa ra
Trường hợp một: sản phẩm mới hoặc đội nhỏ. Tôi dùng cloud API, đặt quota, logging và cache ngay từ đầu. Mục tiêu là xác minh người dùng có thực sự dùng tính năng hay không, họ gửi bao nhiêu token và yêu cầu chất lượng đến đâu. Mua GPU ở giai đoạn này là đưa chi phí cố định vào một giả thuyết chưa được chứng minh.
Trường hợp hai: workload nội bộ lặp lại và tải đã ổn định. Tôi benchmark self-hosted với một cấu hình thuê theo tháng trước, thay vì mua phần cứng ngay. A6000 Ada 48GB bare-metal được ước tính ở khoảng 400–700 USD/tháng là một dữ kiện đáng để đưa vào thử nghiệm, không phải lời mời ký cam kết dài. Nếu benchmark qua nhiều chu kỳ sử dụng cho thấy chất lượng, latency và vận hành đạt yêu cầu, khi ấy mới tính tiếp reserved hoặc phần cứng sở hữu.
Trường hợp ba: workload hỗn hợp. Tôi dùng hybrid. Các luồng có đầu ra rõ ràng và mức rủi ro thấp đi qua hạ tầng tự vận hành. Các luồng khó hoặc có giá trị cao đi cloud. Cần có fallback hai chiều: local lỗi thì có đường dự phòng phù hợp; cloud lỗi hoặc vượt quota thì hệ thống biết hạ cấp chức năng thay vì im lặng.
Điều tôi không làm là mua cấu hình lớn chỉ vì sợ hóa đơn API. Hóa đơn API cao đôi khi là dấu hiệu sản phẩm đang có usage thật; khi đó cần tối ưu token, cache, prompt và routing trước. Hóa đơn GPU cao trong khi GPU không dùng hết thì thường là dấu hiệu bạn đã tối ưu sai thứ tự.
Checklist 36 tháng trước khi ký hợp đồng hoặc mua GPU
- Đo workload: ghi token input, token output, số lần gọi, thời điểm peak và số người dùng đồng thời.
- Chia tác vụ: tách yêu cầu có cấu trúc khỏi yêu cầu cần chất lượng cao và khó kiểm tra.
- Benchmark bằng dữ liệu thật: đo chất lượng, thời gian bắt đầu phản hồi, thời gian hoàn thành và độ ổn định dưới tải.
- Tính đủ TCO: đưa phần cứng, điện, máy chủ, network, software, vận hành và downtime vào cùng một bảng.
- Đừng nhầm discount với tiết kiệm: cam kết một năm giảm 30–40%, ba năm giảm khoảng 50–60%, nhưng chỉ có ý nghĩa khi nhu cầu đủ chắc.
- Thiết kế đường lui: API interface, logging và model router cần đủ linh hoạt để đổi model hoặc đổi nơi chạy.
Quyết định cuối cùng của tôi khá đơn giản: API trước để tìm workload, self-hosted sau khi workload chứng minh được sản lượng và độ ổn định, hybrid khi chất lượng cùng kiểm soát dữ liệu đều quan trọng. Đây không phải câu trả lời hào nhoáng. Nó là câu trả lời ít đốt tiền nhất cho phần lớn đội ngũ.
Câu hỏi thường gặp
Chạy model local có chắc rẻ hơn gọi AI cloud không?
Không chắc. Local có chi phí cố định từ phần cứng hoặc tiền thuê máy, điện, network và vận hành. Cloud có chi phí biến đổi theo mức sử dụng. Nếu tải nhỏ hoặc thất thường, cloud thường tránh được thời gian GPU nhàn rỗi. Local chỉ có lợi khi workload đủ ổn định để tận dụng năng lực đã trả tiền.
Cam kết GPU ba năm có nên chọn vì giảm khoảng 50–60%?
Tôi chỉ cân nhắc sau khi đã có dữ liệu sử dụng đủ tin cậy. Giảm giá lớn không bù được rủi ro chọn nhầm năng lực hoặc bị thay đổi yêu cầu model. Cam kết ba năm là quyết định tài chính và vận hành, không phải mẹo tối ưu hóa đơn giá.
H200 reserved khoảng 2.016 USD/tháng có phải là mốc hòa vốn?
Không. Đây là ước tính chi phí khi một H200 reserved chạy liên tục, dựa trên mức khoảng 2,80 USD/giờ. Điểm hòa vốn còn phụ thuộc sản lượng token thực tế, chất lượng model cần dùng, tỷ lệ tải, concurrency, chi phí nhân sự và phương án cloud mà bạn so sánh.
Doanh nghiệp không có đội MLOps nên đi hướng nào?
Tôi nghiêng về cloud API hoặc managed self-hosting trong giai đoạn đầu. Đừng biến một dự án ứng dụng LLM thành dự án xây hạ tầng chỉ vì muốn tiết kiệm chi phí trên giấy. Khi usage đã rõ, bạn có thể thuê GPU theo tháng để benchmark self-hosted trước khi tự mua máy.
Có nên mua RTX 5090 hoặc workstation RTX 5090 đôi để thử nghiệm?
Có thể hợp lý cho thử nghiệm nội bộ nếu đội hiểu giới hạn của môi trường đó. RTX 5090 được nêu khoảng 2.000–2.500 USD, còn workstation RTX 5090 đôi khoảng 6.000–8.000 USD. Nhưng kết quả một người dùng trên workstation không đủ để chứng minh hệ thống production chịu được tải nhiều người dùng.
Nguồn tham khảo: AI mã nguồn mở hay AI cloud? Bài toán TCO, latency và điểm hòa vốn để không đốt tiền
Bài viết là góc nhìn cá nhân của tác giả, mang tính tham khảo — không phải tin tức báo chí.
📬 Nhận bài viết mới — miễn phí
Đừng bỏ lỡ bài viết tiếp theo. Đăng ký để nhận trong inbox.

Tác giả
Cường Nguyễn — AI Thực Chiến
Tôi là Cường Nguyễn - Founder của AI Ops Solutions.
Tôi từng là Logistics Operations Manager và đồng sáng lập thương hiệu CATCA - #1 Shopee ngành Pet Care.
10 năm kinh nghiệm Logistics/E-commerce OperationsCo-founder CATCA - #1 Shopee ngành Pet CareMột trong 300+ n8n Verified Creator toàn cầuTư vấn Giải pháp chuyển đổi số bằng AI cho 3 SMEs/quý


