Bài viết
Bài viết cá nhân
Cách xây dựng Trading Bot với AI
👤 cuongnguyen📅 29/08/2026⏱ 21 phút đọc
Trong bài viết này(30 mục)⌄
- AI Trading Bot không phải một mô hình dự đoán giá
- Rule-based Bot, AI Trading Bot và AI Agent khác nhau ở đâu?
- Rule-based Bot: dễ hiểu, dễ kiểm tra, cũng dễ bị thị trường làm lộ điểm yếu
- AI Trading Bot: dùng xác suất thay cho mệnh lệnh cứng
- AI Agent: một lớp điều phối, không phải giấy phép để bot tự do
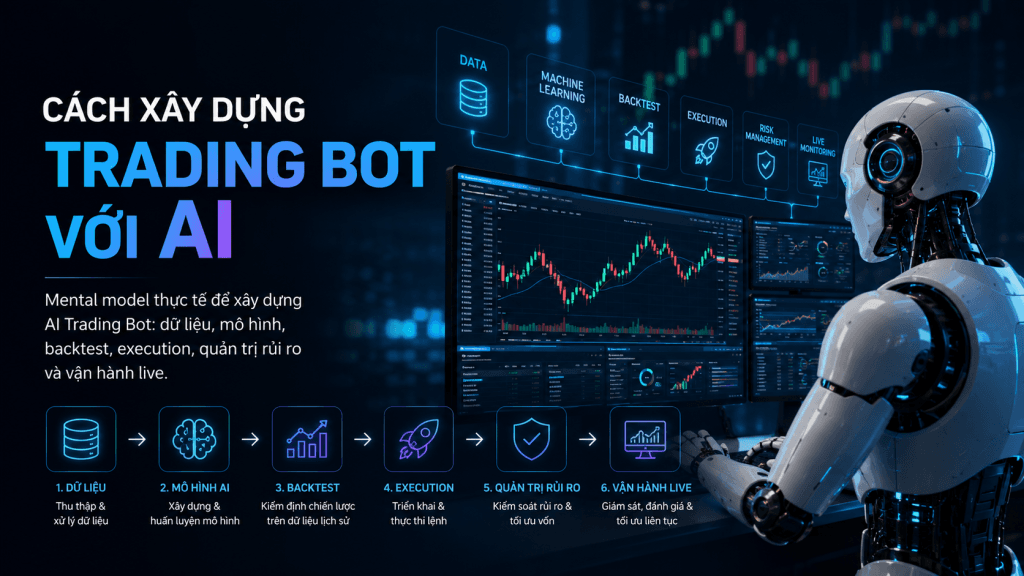
- Kiến trúc 5 tầng của một AI Trading Bot có thể vận hành
- Dữ liệu và Feature Engineering: nơi lợi thế thường nằm
- Đừng chỉ lấy OHLCV rồi gọi đó là dữ liệu thị trường
- Look-ahead bias là lỗi khiến backtest đẹp một cách vô lý
- Feature phải mô tả giả thuyết, không phải là bộ sưu tập chỉ báo
- Chọn model: bắt đầu bằng thứ bạn có thể đánh giá
- Tree-based Models thường là điểm xuất phát tốt
- LSTM và Transformers dành cho chuỗi thời gian, không phải bùa chú
- Deep Reinforcement Learning phù hợp khi bài toán là quản lý hành động
- Backtesting chuẩn Quant: nơi phải nghi ngờ kết quả đẹp nhất
- Dùng Walk-forward validation và Out-of-sample holdout
- Ma sát thị trường phải đi vào mô phỏng
- Đo cả lợi nhuận lẫn cách bot chịu thua
- Execution Engine và Risk Management: phần quyết định bot có sống nổi không
- Kết nối sàn là bài toán trạng thái, không phải chỉ là gọi API
- Limit Order và Market Order là lựa chọn về đánh đổi
- Risk engine phải có quyền phủ quyết tuyệt đối
- Monitoring, MLOps và Paper Trading: bot live không bao giờ là bản hoàn tất
- Những sai lầm tôi thấy nhiều nhất khi build AI Trading Bot
- Câu hỏi thường gặp
- Cần bao nhiêu vốn và kiến thức lập trình để bắt đầu build AI Trading Bot?
- Vì sao backtest rất đẹp nhưng bot chạy live lại lỗ liên tục?
- Nên chọn Machine Learning cổ điển hay Deep Reinforcement Learning?
- Làm thế nào để bot tự ngừng giao dịch khi có Black Swan?
- LLM có nên trực tiếp quyết định buy hay sell không?
AI Trading Bot không phải một mô hình dự đoán giá
Khi nghe cụm AI Trading Bot, nhiều người hình dung một con bot đọc chart, đoán nến tiếp theo rồi tự bấm buy hoặc sell. Đó là cách hiểu nguy hiểm nhất. Một hệ thống giao dịch tự động đủ nghiêm túc không phải là một model dự báo giá. Nó là một dây chuyền gồm dữ liệu, tín hiệu, giới hạn rủi ro, khớp lệnh, giám sát và quy trình dừng khẩn cấp.
Thị trường đang đổ tiền vào câu chuyện này. Theo dữ liệu từ eToro và PanewsLab, khoảng 58% nhà đầu tư cá nhân tại các thị trường phát triển đã dùng công cụ hỗ trợ AI để quản trị danh mục. Các quỹ đầu tư mạo hiểm đã rót hơn 213 triệu USD vào công nghệ AI Web3 trading. Một số tác tử tự hành như hệ sinh thái ElizaOS của ai16z và aixbt được ghi nhận có khối lượng xử lý lệnh vượt 400 triệu USD mỗi tháng.
Nhưng tiền chảy vào một thị trường không tự động biến nó thành máy in lợi nhuận. Intellectia.ai đưa ra một dữ liệu đáng để nhìn thẳng: chỉ khoảng 10% đến 30% người dùng trading bot đạt mức sinh lời bền vững dài hạn. Phần còn lại không nhất thiết thất bại vì chọn sai LSTM hay chưa dùng đúng LLM. Họ thường hỏng ở các chỗ buồn tẻ hơn: dữ liệu đến chậm, backtest sạch quá mức, phí giao dịch bị xem nhẹ, lệnh live khớp khác giả định và bot không biết khi nào phải im lặng.
Bot không kiếm tiền vì nó có AI. Bot chỉ có cơ hội kiếm tiền nếu cả hệ thống xử lý được một lợi thế nhỏ sau khi trừ mọi ma sát của thị trường.
Tôi có quan điểm khá rõ: nếu bạn chưa viết được một Rule-based Bot có log tốt, kiểm soát vị thế rõ và backtest trung thực, nhảy ngay vào Deep Reinforcement Learning thường là cách nhanh nhất để tạo ra một dự án nghe rất ngầu nhưng không thể vận hành. AI nên tăng chất lượng quyết định trong một hệ thống đã có kỷ luật, không thay thế kỷ luật.
Bài viết này không hứa hẹn một chiến lược thắng. Mục tiêu là dựng đúng mental model để bạn biết mình đang xây thứ gì, phần nào đáng đầu tư thời gian, và phần nào nên nghi ngờ ngay từ đầu.
Rule-based Bot, AI Trading Bot và AI Agent khác nhau ở đâu?
Rule-based Bot: dễ hiểu, dễ kiểm tra, cũng dễ bị thị trường làm lộ điểm yếu
Rule-based Bot hay Expert Advisor vận hành bằng điều kiện cố định. Ví dụ: khi một chỉ báo cắt một ngưỡng thì vào lệnh; khi giá đi ngược đến mức định sẵn thì thoát. Điểm mạnh của nó là tính quyết định. Bạn nhìn được từng điều kiện, tái tạo được hành vi và biết chính xác vì sao một lệnh xuất hiện.
Điểm yếu là thị trường không cam kết giữ nguyên cơ chế vận động. Một rule hoạt động trong giai đoạn có xu hướng có thể bị bào mòn khi giá đi ngang. Nếu người xây bot cứ thêm điều kiện để sửa từng giai đoạn lịch sử, hệ thống rất dễ bị overfitting: nó học thuộc quá khứ thay vì nhận ra cấu trúc có thể lặp lại.
AI Trading Bot: dùng xác suất thay cho mệnh lệnh cứng
AI Trading Bot nên trả lời theo dạng xác suất hoặc confidence score, không phải một lệnh buy/sell trần trụi. Thay vì nói “mua ngay”, model có thể trả về mức tin cậy cho một giả thuyết: xác suất điều kiện hiện tại thuận lợi cho một vị thế là bao nhiêu. Engine phía sau mới dùng score đó cùng với thanh khoản, biến động, vị thế đang mở và hạn mức rủi ro để quyết định có giao dịch hay không.
Khác biệt này rất quan trọng. Model có thể đúng ở mức độ thống kê nhưng vẫn không đáng giao dịch nếu confidence thấp, spread xấu, phí cao hoặc danh mục đã chịu rủi ro quá lớn. Một model tốt không có quyền vượt qua Risk Management Engine.
AI Agent: một lớp điều phối, không phải giấy phép để bot tự do
AI Agent thường được nói đến như thực thể tự quan sát, lập kế hoạch, gọi công cụ và thực thi hành động. Trong trading, agent có thể lấy dữ liệu thị trường, đọc tin tức bằng NLP, kiểm tra trạng thái ví, đề xuất chiến lược rồi gửi lệnh. Nó hữu ích ở khâu orchestration: gom thông tin, gọi API, tạo báo cáo và phản ứng theo Workflow.
Nhưng tự hành không đồng nghĩa với đáng tin. Tôi sẽ không cho một LLM quyền tự do đặt lệnh chỉ vì nó viết được lời giải thích thuyết phục. LLM có thể dùng để trích xuất sentiment từ tin tức, phân loại sự kiện hoặc tạo lớp giao tiếp cho hệ thống. Quyết định cuối cùng cần đi qua các rule xác định được: giới hạn vốn, điều kiện thanh khoản, max drawdown, daily trade limit và kill switch. Tư duy này cũng giống cách xây Agent trong môi trường nghiêm túc: quyền hành động phải đi kèm boundary rõ ràng, như bài viết về kiến trúc Agentic và Trusted Agents đã phân tích.
Kiến trúc 5 tầng của một AI Trading Bot có thể vận hành
Một kiến trúc end-to-end có thể tách thành năm tầng khép kín: Data & Feature Engineering, Modeling, Backtesting & Validation, Execution & Risk Management, rồi Monitoring & MLOps. Tách như vậy không phải để vẽ sơ đồ đẹp. Nó giúp bạn khoanh đúng lỗi khi bot hoạt động tệ.
- Data & Feature Engineering: thu thập, làm sạch, đồng bộ thời gian và biến dữ liệu thô thành feature.
- Modeling Layer: ước lượng xác suất, phân loại trạng thái hoặc tối ưu hành động theo dữ liệu đầu vào.
- Backtesting & Validation: kiểm tra giả thuyết với dữ liệu lịch sử mà không tự lừa mình.
- Execution & Risk Management: chuyển quyết định thành lệnh thực, với các giới hạn bắt buộc.
- Monitoring & MLOps: quan sát bot, phát hiện drift, nhận diện regime shift và quản lý retraining.
Luồng xử lý lý tưởng đi từ WebSocket dữ liệu thời gian thực hoặc nguồn dữ liệu lịch sử, qua Data Pipeline, tạo feature, chấm điểm bằng model, kiểm tra rủi ro, gửi lệnh, nhận xác nhận khớp lệnh rồi ghi lại mọi thứ. Log không phải phần phụ. Nếu không lưu input, output model, confidence score, quyết định risk engine, yêu cầu gửi lệnh và trạng thái khớp, bạn không thể điều tra một khoản lỗ.
Mô hình tôi thích là hybrid. AI xử lý phần mơ hồ: đọc dữ liệu phi cấu trúc, nhận diện pattern, ước lượng xác suất. Rule xử lý phần không được phép mơ hồ: không vượt hạn mức, không giao dịch khi feed lỗi, không tăng vị thế sau khi circuit breaker kích hoạt. Đây là cách phân công thực tế hơn rất nhiều so với khẩu hiệu “để AI tự trade”.
Dữ liệu và Feature Engineering: nơi lợi thế thường nằm
Nghiên cứu được trích dẫn cho rằng 80% lợi thế của bot đến từ chất lượng dữ liệu và Feature Engineering, thay vì độ phức tạp của model. Tôi đồng ý với tinh thần này. Một Transformer ăn dữ liệu lệch thời gian, thiếu nến hoặc nhầm timezone vẫn chỉ là một cỗ máy tạo ra confidence score sai với vẻ ngoài rất chuyên nghiệp.
Đừng chỉ lấy OHLCV rồi gọi đó là dữ liệu thị trường
OHLCV đa khung thời gian là điểm bắt đầu: open, high, low, close và volume. Nhưng một bot có thể cần thêm order book imbalance, độ sâu sổ lệnh, dữ liệu on-chain về hoạt động whale, gas spikes và tin tức được xử lý bằng NLP sentiment. Các nguồn này tạo ra Alternative Data, tức dữ liệu có thể phản ánh trạng thái thị trường mà nến giá chưa diễn tả hết.
Dù vậy, thêm nguồn dữ liệu không mặc định tạo alpha. Mỗi feed mới kéo theo câu hỏi khó: nguồn có độ trễ bao nhiêu, timestamp có nhất quán không, dữ liệu mất thì hệ thống xử lý thế nào, và feature này có thật sự tồn tại trước thời điểm bot ra quyết định không? Một feature không trả lời nổi các câu đó không nên vào production.
Look-ahead bias là lỗi khiến backtest đẹp một cách vô lý
Look-ahead bias xảy ra khi hệ thống vô tình dùng thông tin tương lai để ra quyết định ở quá khứ. Nó có thể đến từ cách ghép dữ liệu tin tức sai timestamp, chuẩn hóa dữ liệu trên toàn bộ tập lịch sử trước khi chia train/test, hoặc dùng cây nến chưa đóng để tạo feature mà giả định bot đã biết kết quả cuối cùng.
Hãy đặt một nguyên tắc đơn giản: tại thời điểm T, pipeline chỉ được chạm vào dữ liệu chắc chắn đã tồn tại tại T. Mọi phép biến đổi, scaler, feature selection và nhãn huấn luyện đều phải tuân thủ thứ tự thời gian. Với dữ liệu thị trường, đây không phải chi tiết triển khai; đây là ranh giới giữa một nghiên cứu hợp lệ và một ảo tưởng.
Feature phải mô tả giả thuyết, không phải là bộ sưu tập chỉ báo
Momentum, volatility clusters, order book imbalance, gas usage trends và whale tracking đều có thể là feature. Nhưng bạn cần biết mình kỳ vọng chúng nói lên điều gì. Momentum có thể mô tả quán tính giá. Volatility cluster có thể mô tả mức nhiễu và rủi ro thay đổi. Imbalance có thể phản ánh áp lực mua bán tại một thời điểm. Whale tracker hoặc gas trend có thể là tín hiệu phụ cho những thị trường có dữ liệu on-chain.
Đừng ném tất cả vào model rồi hy vọng thuật toán tự tìm chân lý. Đó là công thức dễ tạo data snooping. Tôi thường ưu tiên ít feature hơn nhưng truy được nguồn gốc, kiểm tra được thời gian và lý giải được vai trò. Nếu feature bị mất, bot phải có chính sách rõ ràng: bỏ qua giao dịch, dùng giá trị an toàn, hay chuyển sang mode hạn chế. Không có câu trả lời chung, nhưng không được để thư viện xử lý im lặng.
Chọn model: bắt đầu bằng thứ bạn có thể đánh giá
Tree-based Models thường là điểm xuất phát tốt
Với dữ liệu dạng bảng, Gradient-Boosted Decision Trees như XGBoost, LightGBM, Random Forest là những lựa chọn phổ biến. Chúng hợp với feature đã được thiết kế từ giá, volume, order book hoặc tín hiệu on-chain. Điểm thực dụng là bạn có thể huấn luyện, kiểm tra và so sánh chúng khá rõ trong một pipeline định lượng.
Đừng coi model cổ điển là “kém AI” hơn Deep Learning. Nếu dữ liệu của bạn là một bảng feature theo thời điểm, một tree-based model tốt và pipeline sạch thường đáng tin hơn một mạng sâu được dựng chỉ để bài toán nghe hiện đại hơn.
LSTM và Transformers dành cho chuỗi thời gian, không phải bùa chú
LSTM và Transformers thường được dùng khi bạn muốn model xử lý chuỗi dữ liệu liên tục. Chúng có thể học quan hệ theo thời gian thay vì chỉ nhìn từng dòng feature riêng lẻ. Nhưng năng lực biểu diễn cao cũng làm chi phí kiểm định cao hơn. Nếu nhãn không chuẩn, dữ liệu ít hoặc regime thay đổi nhanh, model phức tạp sẽ học rất giỏi những nhiễu đã qua.
Đây là chỗ nhiều người đi lạc: họ xem biểu đồ loss giảm dần như bằng chứng model hiểu thị trường. Nó chỉ chứng minh model đang tối ưu mục tiêu huấn luyện. Giá trị kinh tế chỉ được xác nhận sau validation, sau phí và sau kiểm tra live.
Deep Reinforcement Learning phù hợp khi bài toán là quản lý hành động
Deep Reinforcement Learning với PPO, DQN hoặc FinRL được dùng để tối ưu quyết định trong môi trường động. Thay vì chỉ dự báo giá, DRL có thể học cách quản lý vị thế: vào, giữ, giảm hoặc thoát theo phần thưởng đã định nghĩa.
Vấn đề nằm ở chữ “phần thưởng”. Nếu reward chỉ thưởng lợi nhuận thô, agent có thể học hành vi mang rủi ro lớn. Nếu mô phỏng không đưa vào phí, slippage, funding rate và độ trễ khớp lệnh, agent sẽ học cách thắng trong môi trường không tồn tại. DRL là hướng nghiên cứu hấp dẫn, nhưng tôi sẽ chỉ dùng nó sau khi execution simulator và risk constraint đã đủ nghiêm.
ElizaOS và các AI Multi-Agent có thể gợi ý một lớp phối hợp thú vị giữa dữ liệu, phân tích và hành động. Nhưng hệ thống nhiều agent làm tăng bề mặt lỗi: agent nào có quyền đọc gì, quyền gọi API nào, khi nhận tín hiệu xung đột thì ai quyết, và làm sao tái hiện được quyết định? Hãy giải được các câu hỏi đó trước khi gọi nó là autonomous.
Backtesting chuẩn Quant: nơi phải nghi ngờ kết quả đẹp nhất
Backtest không phải bằng chứng chiến lược sẽ kiếm tiền. Backtest là công cụ để loại bỏ những ý tưởng yếu trước khi chúng đụng vào vốn thật. Nếu dùng nó như máy xác nhận niềm tin, bạn sẽ luôn tìm được một tham số đẹp.
Dùng Walk-forward validation và Out-of-sample holdout
Walk-forward validation giữ đúng trật tự thời gian: huấn luyện trên một đoạn quá khứ, đánh giá trên đoạn tiếp theo, rồi dịch cửa sổ đi. Out-of-sample holdout là một phần dữ liệu được giữ lại cho kiểm tra cuối, không dùng để tinh chỉnh lặp đi lặp lại. Hai lớp này giúp bạn phân biệt tín hiệu có khả năng tổng quát với kết quả chỉ hợp một đoạn lịch sử.
Nếu bạn thử nhiều model, nhiều threshold và nhiều bộ feature trên cùng holdout cho đến khi tìm được cấu hình đẹp, holdout đó đã không còn độc lập. Đây là lý do cần kỷ luật thí nghiệm: lưu cấu hình, lý do thay đổi và kết quả của từng lần chạy. Kỹ năng ấy cũng chính là tinh thần của AI thực chiến: làm một hệ thống thật, quan sát lỗi thật thay vì tối ưu câu chuyện trên slide.
Ma sát thị trường phải đi vào mô phỏng
Backtest cần mô phỏng phí sàn 0.1%, slippage 0.05%, funding rate và độ trễ khớp lệnh theo dữ liệu nghiên cứu. Đây là các chi phí có thể biến một edge mỏng thành âm. Các chuyên gia quant nhấn mạnh hiệu suất thực tế thường thấp hơn backtest từ 20% đến 30%. Tôi xem đó là lý do để đặt chuẩn đánh giá khắt khe hơn, chứ không phải một con số để trấn an khi bot chạy tệ.
Hãy phân biệt signal time, decision time, order send time, exchange acknowledgment time và fill time. Nếu backtest cho bot vào đúng giá close của cây nến vừa dùng để tính tín hiệu, bạn đang cấp cho nó tốc độ mà hệ thống live không có. Nếu lệnh lớn gặp sổ lệnh mỏng, giá khớp cũng không còn giống một con số duy nhất trên chart.
Đo cả lợi nhuận lẫn cách bot chịu thua
Sharpe Ratio sau phí, Max Drawdown, Profit Factor và Expectancy là bộ chỉ số cần theo dõi. Win rate tự nó gần như vô nghĩa. Một hệ thống thắng nhiều lệnh nhỏ vẫn có thể mất toàn bộ kết quả chỉ bởi một lần thua lớn. Ngược lại, một hệ thống có tỷ lệ thắng thấp có thể sống được nếu expectancy sau mọi chi phí vẫn dương và drawdown nằm trong mức bạn chịu được.
Hãy hỏi thêm những câu không thoải mái: lợi nhuận có tập trung vào một vài lệnh không? Bot có phụ thuộc vào một regime cụ thể không? Kết quả có còn ổn nếu tăng nhẹ slippage hoặc giảm chất lượng fill không? Khi câu trả lời quá mong manh, đừng cố sửa biểu đồ. Hãy quay lại giả thuyết.
Execution Engine và Risk Management: phần quyết định bot có sống nổi không
Kết nối sàn là bài toán trạng thái, không phải chỉ là gọi API
Với CEX, CCXT là lựa chọn phổ biến để tích hợp API. Với DEX, Web3.py và Smart Wallets thường nằm trong lớp kết nối. Nhưng API chỉ là cánh cửa. Execution Engine phải biết lệnh nào đã gửi, lệnh nào được sàn nhận, lệnh nào khớp một phần, lệnh nào bị từ chối và lệnh nào còn treo khi mạng gặp sự cố.
Thiết kế cần tránh gửi trùng lệnh khi reconnect. Nó cần xử lý API rate limits, timeout và trạng thái không chắc chắn. Nếu bot mất kết nối sau khi gửi yêu cầu, đừng mặc định lệnh thất bại rồi gửi lại. Hãy truy vấn trạng thái bằng client order identifier hoặc cơ chế tương đương trước khi làm bất cứ thứ gì tiếp theo.
Limit Order và Market Order là lựa chọn về đánh đổi
Market Order ưu tiên khả năng được khớp nhưng phải chấp nhận slippage. Limit Order kiểm soát giá tốt hơn nhưng có rủi ro không được khớp, nhất là khi thị trường dịch chuyển nhanh. Một bot nghiêm túc cần biết khi nào ưu tiên certainty of execution, khi nào ưu tiên price control và khi nào không giao dịch vì hai lựa chọn đều xấu.
Đừng để model quyết định mọi thứ mà không có ràng buộc thanh khoản. Confidence score cao không cứu được một lệnh gây tác động thị trường hoặc một lệnh bị khớp tệ hơn hẳn giả định trong backtest.
Risk engine phải có quyền phủ quyết tuyệt đối
Dynamic Position Sizing có thể dùng Kelly Criterion kết hợp confidence score. Ý tưởng hợp lý là mức tin cậy cao hơn có thể nhận quy mô vị thế khác, thay vì mọi lệnh đều bằng nhau. Nhưng Kelly không phải nút tăng đòn bẩy. Nó chỉ có ý nghĩa khi các giả định về xác suất và payoff đủ đáng tin, điều vốn rất khó trong thị trường thay đổi cơ chế.
Risk engine cần kiểm tra vị thế hiện tại, tổng phơi nhiễm, phí, trạng thái kết nối, daily trade limit và drawdown trước khi lệnh được phép đi ra ngoài. Stop-loss, take-profit và trailing stop dựa trên ATR có thể là các cơ chế quản lý lệnh. Circuit breaker phải tự ngắt bot khi Max Drawdown chạm vùng ví dụ 10-15% hoặc khi vượt Daily Trade Limit. Kill switch cần tồn tại ở cấp vận hành, không chỉ là một hàm ít khi được gọi trong code.
Model được quyền đề xuất. Risk engine được quyền nói không. Execution engine phải tôn trọng chữ không đó.
Monitoring, MLOps và Paper Trading: bot live không bao giờ là bản hoàn tất
Thị trường có regime shifts: từ trend sang choppy sideways, từ thanh khoản bình thường sang điều kiện bất ổn. Một model được huấn luyện cho giai đoạn trước có thể mất hiệu lực khi phân phối dữ liệu đầu vào đổi khác. Đây là model drift, và nó cần được xem là rủi ro vận hành chứ không phải bất ngờ hiếm gặp.
Monitoring nên theo dõi ít nhất các lớp sau: chất lượng feed, độ trễ dữ liệu, tỷ lệ lỗi API, trạng thái order, chênh lệch giữa giá kỳ vọng và giá fill, phân phối feature, confidence score, PnL sau phí, drawdown và trạng thái circuit breaker. Dashboard đẹp không quan trọng bằng alert đúng lúc. Một cảnh báo về feed cũ hoặc lệnh treo có giá trị hơn nhiều so với một biểu đồ PnL mượt mà.
Paper Trading là bước cần có trước vốn thật. Nó không tái tạo hoàn hảo thị trường live, nhưng nó cho bạn kiểm tra Workflow, reconnect, log, xử lý lỗi và mối liên kết giữa signal với execution. Bot qua backtest vẫn có thể hỏng ở Paper Trading vì những lỗi không xuất hiện trong notebook: schema dữ liệu thay đổi, API trả về chậm, timestamp lệch hoặc một lệnh bị xử lý ngoài dự kiến.
Retraining định kỳ cũng không phải nghi thức. Bạn cần phát hiện drift, đánh giá phiên bản model mới, chạy validation, kiểm tra an toàn rồi mới re-deploy. Không nên thay model trực tiếp chỉ vì bản mới có metric train đẹp hơn. Mỗi model cần version, tập dữ liệu, cấu hình feature và kết quả kiểm thử đi kèm. Nếu phiên bản mới gây vấn đề, phải biết cách rollback.
Những sai lầm tôi thấy nhiều nhất khi build AI Trading Bot
- Nhầm win rate với lợi nhuận: tỷ lệ thắng cao không nói được gì nếu lệnh thua và chi phí xóa sạch kết quả.
- Chạy theo model phức tạp quá sớm: dùng LSTM, Transformers hay DRL trước khi kiểm soát được dữ liệu và execution thường chỉ làm lỗi khó thấy hơn.
- Backtest không có ma sát: bỏ phí, slippage, funding rate hoặc latency là tạo một thị trường giả.
- Cho LLM quyền gửi lệnh trực tiếp: văn bản thuyết phục không phải là kiểm soát rủi ro.
- Không có kill switch: bot không được phép tiếp tục giao dịch chỉ vì process vẫn còn chạy.
- Bảo mật API Key và Private Key hời hợt: quyền rút tiền, quyền giao dịch và secret của hệ thống cần được quản lý cẩn thận.
- Bỏ qua rủi ro pháp lý, thuế và tuân thủ: đây là phần người xây phải tự kiểm tra theo thị trường mà mình giao dịch.
Nếu bạn mới bắt đầu, hãy làm scope nhỏ: một thị trường, một tần suất, một bộ feature, một chiến lược baseline, một execution path và một dashboard log. Chưa cần gọi nó là AI Agent. Khi bạn đã đo được từ dữ liệu đầu vào đến fill thực tế, bạn mới có nền để nâng cấp model. Nếu bạn đang thiếu nền tảng để tự dựng pipeline này, lộ trình học AI theo hướng thực chiến có thể giúp chia nhỏ vấn đề thành các phần dễ triển khai hơn.
Câu hỏi thường gặp
Cần bao nhiêu vốn và kiến thức lập trình để bắt đầu build AI Trading Bot?
Đừng lấy vốn làm điểm xuất phát. Hãy bắt đầu bằng kiến thức đủ để xử lý dữ liệu chuỗi thời gian, gọi API, quản lý trạng thái lệnh, viết backtest và đọc log. Paper Trading cho phép bạn kiểm tra hệ thống trước khi đưa vốn thật vào. Vốn chỉ nên xuất hiện sau khi bạn đã biết bot xử lý phí, slippage, lỗi mạng và drawdown thế nào.
Vì sao backtest rất đẹp nhưng bot chạy live lại lỗ liên tục?
Các nguyên nhân thường gặp là overfitting, look-ahead bias, phí và slippage bị đánh giá thấp, latency khác giả định, hoặc điều kiện thị trường đã đổi. Dữ liệu nghiên cứu cho thấy hiệu suất thực tế thường kém backtest từ 20% đến 30%. Hãy kiểm tra timestamp, fill assumption, funding rate, logic reconnect và toàn bộ đường đi của lệnh trước khi kết luận model kém.
Nên chọn Machine Learning cổ điển hay Deep Reinforcement Learning?
Với dữ liệu dạng bảng, XGBoost, LightGBM hoặc Random Forest là điểm bắt đầu thực dụng. LSTM và Transformers phù hợp hơn khi cần xử lý chuỗi liên tục. DRL như PPO, DQN hoặc FinRL đáng xem xét khi mục tiêu là tối ưu quản lý vị thế theo môi trường động. Chọn theo cấu trúc bài toán và khả năng kiểm định, không theo mức độ thời thượng của thuật toán.
Làm thế nào để bot tự ngừng giao dịch khi có Black Swan?
Không có một model nào đảm bảo nhận diện mọi Black Swan. Cách đúng là thiết kế nhiều lớp phòng thủ: max drawdown, daily trade limit, circuit breaker, kill switch, kiểm tra feed bất thường và điều kiện dừng khi execution không đáng tin. Ví dụ, circuit breaker có thể ngắt bot khi Max Drawdown chạm vùng 10-15%. Mục tiêu của cơ chế này không phải dự báo mọi cú sốc, mà là giới hạn thiệt hại khi dự báo thất bại.
LLM có nên trực tiếp quyết định buy hay sell không?
Theo tôi, không nên để LLM trực tiếp có toàn quyền gửi lệnh. LLM phù hợp hơn với NLP sentiment, tóm tắt tin tức, điều phối công cụ hoặc hỗ trợ phân tích. Lệnh cần đi qua model định lượng nếu có, rồi qua Risk Management Engine với các rule xác định được. Hệ thống càng tự hành, audit trail và giới hạn quyền càng phải chặt.
Nguồn tham khảo: Cách xây dựng Trading Bot với AI: Hướng dẫn từ Kiến trúc kỹ thuật, Machine Learning đến Quản trị rủi ro thực chiến
Bài viết là góc nhìn cá nhân của tác giả, mang tính tham khảo — không phải tin tức báo chí.
📬 Nhận bài viết mới — miễn phí
Đừng bỏ lỡ bài viết tiếp theo. Đăng ký để nhận trong inbox.

Tác giả
Cường Nguyễn — AI Thực Chiến
Tôi là Cường Nguyễn - Founder của AI Ops Solutions.
Tôi từng là Logistics Operations Manager và đồng sáng lập thương hiệu CATCA - #1 Shopee ngành Pet Care.
10 năm kinh nghiệm Logistics/E-commerce OperationsCo-founder CATCA - #1 Shopee ngành Pet CareMột trong 300+ n8n Verified Creator toàn cầuTư vấn Giải pháp chuyển đổi số bằng AI cho 3 SMEs/quý


