Bài viết
Bài viết cá nhân
Dữ liệu lỗi: Không thể biến nguồn BBC thành bài phân tích đáng tin
👤 cuongnguyen📅 06/11/2026⏱ 5 phút đọc
Tin chính là gì?
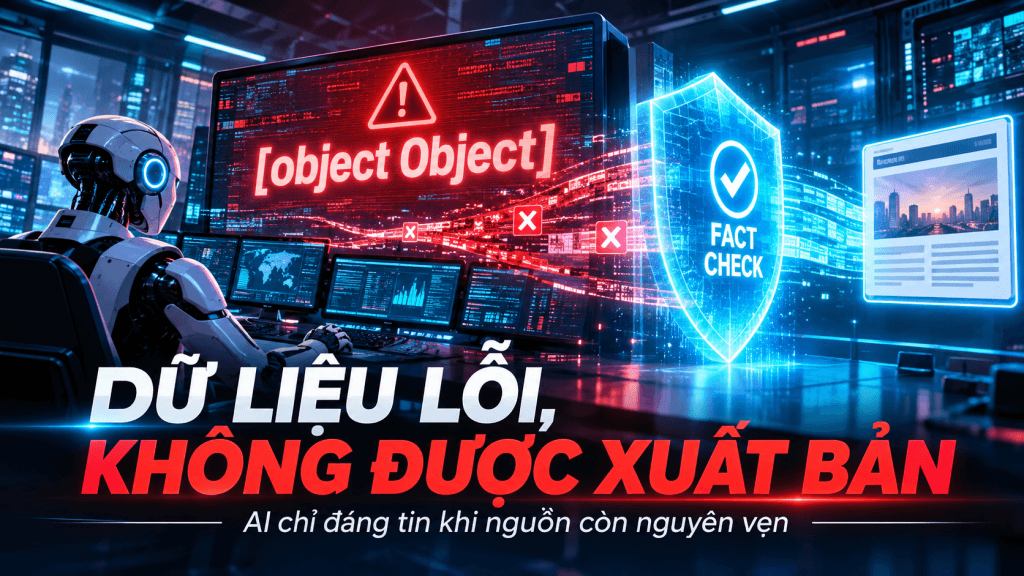
Thông tin đầu vào yêu cầu trích dẫn một bài viết từ BBC, tại liên kết được cung cấp. Tuy nhiên, phần dữ liệu nghiên cứu đi kèm không chứa nội dung có thể kiểm chứng: toàn bộ các mục “Sự thật đã xác minh” đều hiển thị dưới dạng [object Object], còn tiêu đề đề xuất để trống.
Vì vậy, không có cơ sở để xác định bài báo nói về công ty nào, sản phẩm nào, tuyên bố nào, mốc thời gian nào hay số liệu nào. Viết một Daily Spotlight như thể đã biết chủ đề sẽ đồng nghĩa với việc bịa đặt dữ kiện — điều không thể chấp nhận với một kênh kiến thức AI & Tech.
Điểm đáng chú ý ở đây không nằm ở một tin công nghệ cụ thể, mà ở lỗi đứt gãy giữa bước thu thập dữ liệu và bước biên tập. Khi research payload mất cấu trúc, hệ thống xuất bản mất luôn nền tảng để phân biệt fact, quote, suy luận và nhận định.
Vì sao đáng chú ý?
AI có thể viết nhanh, nhưng không thể thay thế kỷ luật nguồn. Một URL uy tín không tự động biến mọi nội dung được tạo ra từ URL đó thành đáng tin. Người viết cần biết rõ đâu là thông tin được BBC xác nhận, đâu là phát biểu từ doanh nghiệp, đâu là số liệu do bên thứ ba công bố.
Lỗi [object Object] thường cho thấy dữ liệu có cấu trúc đã bị ép sang chuỗi văn bản mà không được serialize đúng cách. Hậu quả rất nghiêm trọng: headline có thể sai chủ thể, số liệu có thể bị gán nhầm ngữ cảnh, còn nhận định chiến lược sẽ xây trên một nền dữ liệu rỗng.
Với nội dung AI và công nghệ, sai một chi tiết nhỏ đã đủ phá hỏng giá trị bài viết. Nhầm tên model, nhầm benchmark, nhầm trạng thái “ra mắt” với “thử nghiệm”, hoặc nhầm tuyên bố marketing thành năng lực đã kiểm chứng đều có thể khiến độc giả ra quyết định sai.

Tác động thực chiến
Với đội ngũ content, đây là tín hiệu phải dừng pipeline thay vì “điền cho đủ bài”. Quy trình tối thiểu cần có một lớp kiểm tra trước xuất bản:
- Kiểm tra schema: xác nhận các trường tiêu đề, sự kiện, chủ thể, thời điểm, nguồn trích dẫn và số liệu đều có giá trị đọc được.
- Tách fact và opinion: fact phải truy ngược về nguồn; opinion phải dựa trên fact đã giữ được provenance.
- Chặn xuất bản khi thiếu ngữ cảnh: không cho phép model suy đoán chủ đề từ URL hoặc tự lấp chỗ trống bằng kiến thức nền.
- Lưu bản nghiên cứu có thể audit: mỗi claim cần gắn nguồn, đoạn trích và thời điểm thu thập.
Với đội ngũ xây AI Agent cho newsroom, đây là một bài test thiết kế quan trọng. Agent không nên được thưởng vì hoàn thành văn bản; agent phải được thưởng vì từ chối hoàn thành khi bằng chứng không đạt chuẩn. “Tôi không đủ dữ liệu để kết luận” là một output có giá trị hơn nhiều so với một bài viết trơn tru nhưng sai.
Cường Nguyễn nhận định
Đây là lỗi vận hành, không phải lỗi câu chữ. Một hệ thống cho phép [object Object] đi thẳng vào khâu biên tập đã thất bại ở data contract cơ bản. Đừng đổ lỗi cho LLM khi model tạo ra nội dung thiếu căn cứ: dữ liệu đầu vào đã không cung cấp bất kỳ căn cứ nào để model làm việc tử tế.
Tôi phản đối tư duy “cứ xuất bản trước, sửa sau” trong mảng AI & Tech. Tốc độ xuất bản chỉ có ý nghĩa khi fact vẫn nguyên vẹn. Một bài sai về sản phẩm, chiến lược hay năng lực kỹ thuật có thể gây mất niềm tin lâu hơn rất nhiều so với lợi thế từ vài giờ lên bài sớm.
Khuyến nghị cụ thể cho engineers và founders: hãy thêm một hard gate trước bước generation. Nếu trường fact, chủ thể hoặc nội dung nguồn không parse được; nếu xuất hiện giá trị kiểu [object Object]; hoặc nếu không có trích dẫn có thể truy vết, pipeline phải trả trạng thái RESEARCH_INVALID và yêu cầu thu thập lại dữ liệu. Không có ngoại lệ vì deadline.
Câu hỏi thường gặp
Vì sao không suy luận chủ đề trực tiếp từ URL BBC?
URL không cung cấp đủ nội dung để xác nhận chủ thể, phát biểu, số liệu hay ngữ cảnh. Suy luận từ mã định danh URL sẽ biến phỏng đoán thành fact, đi ngược yêu cầu kiểm chứng.
[object Object] có nghĩa là gì?
Đây thường là dấu hiệu một object dữ liệu đã bị chuyển thành text theo cách không đúng. Thay vì hiện các trường nội dung, hệ thống chỉ hiện nhãn mặc định của object.
Muốn xuất bản bài phân tích đúng chuẩn cần bổ sung gì?
Cần cung cấp tiêu đề bài BBC, phần tóm tắt fact, các trích dẫn chính, tên tổ chức hoặc sản phẩm liên quan, thời điểm và mọi số liệu đã được kiểm chứng từ nguồn.
Nguồn tham khảo: BBC
Tác giả: Cường Nguyễn — Founder AI Ops Solutions | Verified n8n Creator. Kết nối: Facebook · LinkedIn · YouTube · TikTok
Bài viết là góc nhìn cá nhân của tác giả, mang tính tham khảo — không phải tin tức báo chí.
📬 Nhận bài viết mới — miễn phí
Đừng bỏ lỡ bài viết tiếp theo. Đăng ký để nhận trong inbox.
Tác giả
Cường Nguyễn — AI Thực Chiến
Tôi là Cường Nguyễn - Founder của AI Ops Solutions.
Tôi từng là Logistics Operations Manager và đồng sáng lập thương hiệu CATCA - #1 Shopee ngành Pet Care.
10 năm kinh nghiệm Logistics/E-commerce OperationsCo-founder CATCA - #1 Shopee ngành Pet CareMột trong 300+ n8n Verified Creator toàn cầuTư vấn Giải pháp chuyển đổi số bằng AI cho 3 SMEs/quý


