Bài viết
Bài viết cá nhân
Dữ liệu và quy trình quan trọng hơn AI model: bài học triển khai AI thất bại cho SME
👤 cuongnguyen📅 24/08/2026⏱ 27 phút đọc
Trong bài viết này(32 mục)⌄
- Cú sốc thực tế năm 2026: AI thất bại nhiều hơn vì doanh nghiệp đánh sai trọng tâm
- Ảo tưởng sẵn sàng cho AI bắt đầu từ một bản demo
- Model đang là commodity, còn dữ liệu và Workflow mới là lợi thế
- Bẫy Technology-First: mua công nghệ rồi mới đi tìm bài toán
- Nhiều dữ liệu không đồng nghĩa dữ liệu tốt
- Dữ liệu kém là kẻ hủy diệt thầm lặng của AI pilot
- RAG và Fine-tuning không phải thuốc chữa dữ liệu mục
- Hallucination thường là triệu chứng, không luôn là nguyên nhân
- Quy trình vận hành quyết định AI sinh lời hay thành gánh nặng
- Tự động hóa quy trình rác chỉ làm rác chạy nhanh hơn
- RACI và Human-in-the-loop không phải thủ tục giấy tờ
- Khung 10/20/70: cách phân bổ lại tiền và sự chú ý
- 10% cho model: chọn vừa vặn thay vì overkill
- 20% cho dữ liệu và hạ tầng: xây đường ống tối thiểu nhưng thật
- 70% cho con người và quy trình: phần ít sexy nhưng quyết định sống chết
- Hai kịch bản SME thường gặp và bài học thực dụng
- Kịch bản thất bại: chatbot và dự báo chạy trên các nguồn bị đứt
- Kịch bản tốt hơn: chuẩn hóa tài liệu rồi mới cho AI hỗ trợ CSKH
- Mua năng lực chuyển giao, đừng mua sự phụ thuộc
- Khung 5 bước kiểm tra Data Readiness cho SME
- Bước 1: Data Audit theo Use Case, không audit cho có
- Bước 2: Chuẩn hóa mức tối thiểu
- Bước 3: Thiết lập Data Governance gọn nhẹ
- Bước 4: Thiết kế lại Workflow và KPI trước ngày go-live
- Bước 5: Pilot hẹp, có vòng phản hồi
- Lời khuyên cho founder và CEO SME: bắt đầu từ gốc rễ, không từ slide demo
- Câu hỏi thường gặp
- SME chưa có Data Warehouse lớn có triển khai AI được không?
- Phân biệt dữ liệu nhiều với AI-ready data bằng cách nào?
- Khi AI trả lời sai, làm sao biết lỗi do model, prompt hay dữ liệu?
- SME nên tự xây đội AI hay thuê nhà cung cấp?
- ROI của AI nên đo bằng gì?
Cú sốc thực tế năm 2026: AI thất bại nhiều hơn vì doanh nghiệp đánh sai trọng tâm
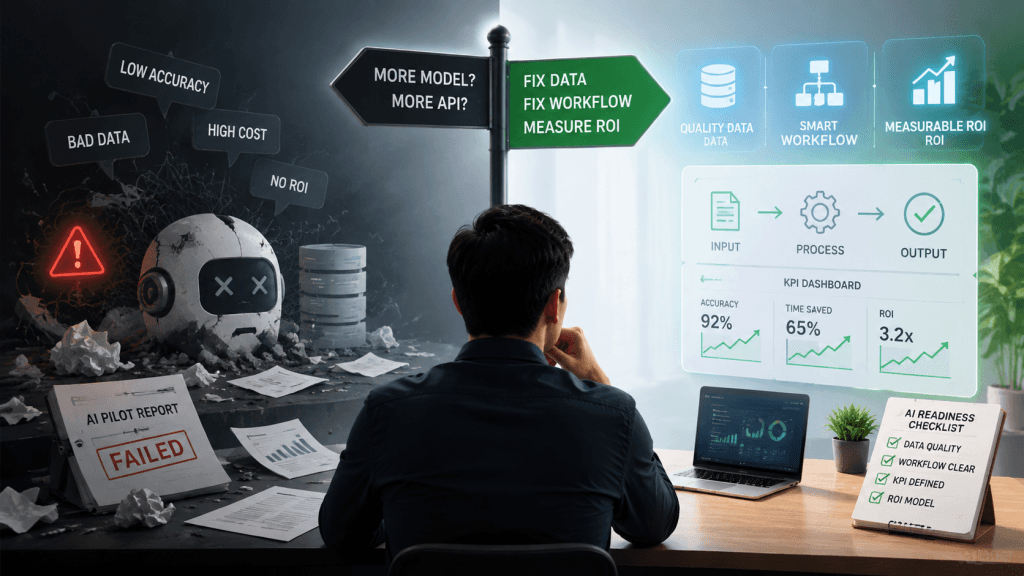
Nhiều CEO SME đang hỏi một câu sai: nên dùng GPT-4o, Claude 3.5 Sonnet hay Llama 3? Câu hỏi đó có thể cần trả lời, nhưng nó thường xuất hiện quá sớm. Khi doanh nghiệp chưa biết dữ liệu nào là nguồn sự thật, quy trình nào cần sửa, ai chịu trách nhiệm kiểm tra đầu ra, việc chọn model giống như tranh luận nên mua động cơ nào khi chiếc xe chưa có bánh.
Số liệu năm 2026 khá lạnh lùng. Theo S&P Global Market Intelligence và TechTarget, tỷ lệ dự án AI thất bại đã tăng từ 17% lên 42% trong một năm. Có 72% doanh nghiệp đứng trước nguy cơ dừng hoặc đóng hoàn toàn các AI pilot vì không đạt KPI kinh doanh thực tế. RAND Corporation, BCG và McKinsey cũng đưa ra một bức tranh cùng chiều: từ 70% đến hơn 80% sáng kiến AI doanh nghiệp không tạo ra giá trị đo lường được qua EBIT. MIT NANDA Initiative ghi nhận chỉ 5% pilot đạt mức tăng tốc doanh thu nhanh chóng.
Tôi không đọc các con số này theo kiểu “AI là bong bóng”. AI vẫn hữu ích, và model hiện tại mạnh hơn rất nhiều thứ doanh nghiệp từng có. Điểm đáng nói là thị trường đang thanh lọc những dự án khởi đầu bằng demo đẹp, hứa hẹn lớn, rồi né các câu hỏi vận hành khó chịu: dữ liệu này từ đâu ra, có ai cập nhật không, khi hai hệ thống trả về hai giá trị khác nhau thì tin cái nào, và nhân viên sẽ làm gì khi AI trả lời sai?
SME dễ mắc lỗi này hơn doanh nghiệp lớn vì áp lực phải làm nhanh là có thật. Một chủ doanh nghiệp thấy đối thủ tung chatbot, nghe tư vấn nói về AI Agent, rồi yêu cầu đội kỹ thuật “làm cái tương tự trong tháng này”. API được mua, giao diện được dựng, prompt được viết. Nhưng CRM vẫn có khách hàng trùng lặp, lịch sử trao đổi nằm trong Zalo, bảng giá nằm ở các file Excel khác nhau, nhân viên kho gọi điện xác nhận số lượng hàng. AI đi vào một hệ thống đã rối. Nó không làm hệ thống đó tự nhiên có kỷ luật.
Ảo tưởng sẵn sàng cho AI bắt đầu từ một bản demo
Cloudera gọi đây là AI readiness illusion: doanh nghiệp thấy mình đã sẵn sàng vì đã có dữ liệu, phần mềm và vài công cụ AI. Thực ra “có dữ liệu” khác hoàn toàn với “có dữ liệu dùng được”. Một thư mục chứa hàng nghìn file PDF không tự động thành knowledge base. Một CRM có nhiều bản ghi không tự động là CRM sạch. Một đội ngũ quen dùng Excel không tự nhiên có quy ước về phiên bản, chủ sở hữu dữ liệu, quyền sửa hay lịch sử thay đổi.
Gartner cảnh báo 85% dự án AI thất bại bắt nguồn từ dữ liệu kém hoặc thiếu dữ liệu liên quan. Trong năm 2026, 60% dự án không có nền tảng AI-ready data có nguy cơ bị khai tử, với chi phí lãng phí trung bình 7,2 triệu USD cho mỗi sáng kiến hỏng. SME Việt Nam có quy mô chi nhỏ hơn các tập đoàn trong những báo cáo này, nhưng logic thất bại không hề nhỏ hơn: tiền mất vào tool, thời gian mất vào tích hợp, niềm tin mất sau vài lần AI trả lời sai.
Vấn đề là nhiều đội ngũ vẫn coi AI như một lớp phủ lên công việc cũ. Họ muốn chatbot trả lời khách nhanh hơn nhưng chưa thống nhất chính sách đổi trả. Họ muốn dự báo nhu cầu nhưng mã hàng, đơn vị tính và dữ liệu tồn kho không khớp. Họ muốn AI Agent tạo báo cáo nhưng số doanh thu giữa Excel của kế toán và CRM của sales đã lệch nhau. Đây không phải lỗi model. Đây là doanh nghiệp đưa một người mới rất nhanh vào một căn phòng đầy giấy tờ lộn xộn, rồi trách người đó không tìm được câu trả lời.
Model đang là commodity, còn dữ liệu và Workflow mới là lợi thế
Tim Bond, Giám đốc Sản phẩm tại Adeptia, nói khá đúng: quyền truy cập vào các model có năng lực giờ đã là table stakes. Nói thẳng hơn, model giỏi không còn là lợi thế bền vững cho phần lớn SME. Hôm nay bạn gọi một API, đối thủ cũng có thể gọi API đó. Bạn mua một gói SaaS có chatbot, vài ngày sau họ cũng mua được. Chênh lệch không nằm ở việc ai nghe tên model mới sớm hơn.
Chênh lệch nằm ở dữ liệu vận hành riêng của doanh nghiệp và cách doanh nghiệp biến dữ liệu đó thành hành động. Một công ty có lịch sử mua hàng sạch, chính sách giá rõ, mô tả sản phẩm chuẩn, quy trình xử lý khiếu nại nhất quán và quyền truy cập được quản trị sẽ xây được hệ thống hỗ trợ bán hàng đáng tin hơn. Họ có thể dùng model tương tự đối thủ. Nhưng model nhận được ngữ cảnh tốt hơn, bị ràng buộc bởi quy trình rõ hơn và có người kiểm tra đúng chỗ.
Đây là lý do tôi không thích cách nhiều đơn vị bán giải pháp mở đầu bằng danh sách model. Nếu buổi tư vấn AI cho SME bắt đầu bằng “chúng tôi dùng model gì” thay vì “quy trình nào đang làm mất tiền, dữ liệu nào quyết định kết quả, KPI nào chứng minh hiệu quả”, tôi sẽ dè chừng. Model quan trọng, nhưng hiếm khi là nút thắt đầu tiên.
Bẫy Technology-First: mua công nghệ rồi mới đi tìm bài toán
Bẫy phổ biến nhất là Technology-First. Doanh nghiệp mua chatbot trước khi xác định chatbot phải giải quyết loại yêu cầu nào. Họ mua công cụ dự báo trước khi biết dữ liệu quá khứ có nhất quán hay không. Họ triển khai RAG trước khi phân loại tài liệu nào còn hiệu lực. Sau đó, dự án chết ở giai đoạn “người dùng không dùng”, và kết luận bị đổ cho AI.
Cách làm đúng nên đảo ngược: bắt đầu bằng một quyết định hoặc thao tác đang tốn thời gian, có tần suất đủ cao, có đầu vào xác định và có đầu ra đo được. Chẳng hạn, nhân viên chăm sóc khách hàng phải tra chính sách, kiểm tra tình trạng đơn và soạn phản hồi. Đây là một Workflow có thể bóc tách. Nhưng nếu mỗi câu trả lời phụ thuộc vào trí nhớ của một nhân viên lâu năm và chính sách thay đổi bằng tin nhắn nội bộ, chưa có AI nào cứu được. Việc đầu tiên là chuẩn hóa chính sách và nơi lưu trữ.
Bài viết Từ Excel đến n8n: Lộ trình automation thực dụng cho SME Việt đã nói kỹ về việc chọn Workflow và kiểm soát lỗi trước khi tự động hóa. Tôi xem AI là một lớp tăng năng lực cho automation, không phải giấy phép để bỏ qua các bước nền tảng của automation.
Nhiều dữ liệu không đồng nghĩa dữ liệu tốt
Một ngộ nhận khác là phải thu thập càng nhiều dữ liệu càng tốt. Thực tế, dữ liệu nhiều nhưng không rõ nguồn gốc, không có cấu trúc và không liên quan đến Use Case chỉ làm tăng chi phí tìm kiếm, làm sạch và kiểm chứng. RAG không biến một kho tài liệu vô tổ chức thành tri thức đáng tin. Nó chỉ tìm kiếm trong kho đó nhanh hơn.
Brandon Smith, Giám đốc Công nghệ tại Helios Technologies, diễn đạt đúng trọng tâm: các công ty thất bại không phải vì AI không hoạt động, mà vì họ chưa xây lớp nền bên dưới nó — nền tảng dữ liệu được quản trị chặt chẽ, truy vết được và có cấu trúc để model đứng trên đó. Công thức Garbage In, Garbage Out cũ như máy tính, nhưng với AI nó nguy hiểm hơn vì đầu ra nghe rất thuyết phục. Rác được nhân bản với tốc độ cao, trình bày bằng ngôn ngữ trôi chảy, nên người dùng dễ tin hơn.
Dữ liệu kém là kẻ hủy diệt thầm lặng của AI pilot
Khi nói “dữ liệu kém”, nhiều người chỉ nghĩ đến ô trống hay lỗi chính tả. Với AI, vấn đề rộng hơn. Một nguồn dữ liệu có thể sạch về mặt kỹ thuật nhưng vô dụng về mặt nghiệp vụ vì đã hết hiệu lực, không có ngữ cảnh hoặc thiếu quan hệ với dữ liệu khác. SME thường vướng ít nhất năm khuyết tật dưới đây.
- Rời rạc: thông tin khách hàng, đơn hàng, công nợ và phản hồi nằm ở các hệ thống hay file khác nhau, không có khóa liên kết đáng tin.
- Thiếu ngữ cảnh: một ghi chú có nội dung nhưng không ghi thời điểm, người tạo, trạng thái xử lý hay điều kiện áp dụng.
- Mâu thuẫn: cùng một chính sách giá, một mã sản phẩm hoặc một khách hàng có nhiều phiên bản khác nhau.
- Bẩn: bản ghi trùng, sai định dạng, thiếu trường quan trọng, dùng tên gọi tự do thay vì danh mục chuẩn.
- Rải rác và không có chủ sở hữu: dữ liệu tồn tại trong email, Zalo, ổ đĩa cá nhân hay máy tính của nhân viên, nhưng không ai chịu trách nhiệm duy trì.
Đây là các lỗi rất đời thường. Nhân viên sales ghi “Công ty An Phát”, kế toán ghi “An Phat Co.”, kho ghi “AP”. Con người có thể đoán chúng là một khách hàng. Máy không nên bị buộc phải đoán. Nếu AI Agent cần đối chiếu thông tin, nó phải biết ba bản ghi ấy có cùng một thực thể hay không. Nếu doanh nghiệp không có quy tắc, AI sẽ suy luận. Và suy luận trong vận hành là nơi rủi ro bắt đầu.
RAG và Fine-tuning không phải thuốc chữa dữ liệu mục
RAG có ích khi doanh nghiệp có tài liệu liên quan, được phân loại, còn hiệu lực và có thể truy xuất. Fine-tuning có ích trong một số nhu cầu chuyên biệt. Nhưng cả hai không thay thế việc làm sạch nguồn. Đưa một tập tài liệu lẫn lộn vào RAG rồi kỳ vọng chatbot chỉ trả lời đúng là một dạng cầu may có kỹ thuật.
Hãy nhìn RAG như một nhân viên thư viện cực nhanh. Nhân viên này có thể tìm sách trong vài giây. Nhưng nếu sách cũ và mới lẫn nhau, bìa không có ngày cập nhật, các quy định bị in ở ba nơi và một số trang bị thiếu, nhân viên thư viện không thể tự quyết tài liệu nào là chính sách hiện hành. Bạn cần tạo danh mục, gắn quyền sở hữu, ngày hiệu lực, phạm vi sử dụng và quy tắc cập nhật. Khi đó, RAG mới có thứ đáng để truy xuất.
Tương tự, Fine-tuning không thể sửa sự mơ hồ trong chính sách kinh doanh. Nó cũng không tạo ra chuỗi dữ liệu giao dịch chưa từng được lưu. Tôi thấy nhiều đội nhảy vào prompt engineering khi AI trả lời sai. Prompt cần chỉnh, dĩ nhiên. Nhưng nếu câu trả lời sai vì tài liệu nguồn sai hoặc thiếu, sửa prompt chỉ là sửa câu hỏi dành cho một tủ hồ sơ lộn xộn.
Hallucination thường là triệu chứng, không luôn là nguyên nhân
Khi AI “bịa”, đội triển khai hay quy hết cho hallucination của LLM. Cách phản ứng này tiện, vì nó biến lỗi thành thuộc tính khó tránh của công nghệ. Nhưng cần tách nguyên nhân. AI có thể trả lời sai vì model không biết; vì prompt không ép nó chỉ dùng nguồn được cung cấp; vì RAG lấy nhầm tài liệu; vì tài liệu có thông tin mâu thuẫn; hoặc vì người dùng hỏi một việc vượt phạm vi hệ thống.
Mỗi lỗi cần một cách sửa khác nhau. Nếu dữ liệu sai, sửa dữ liệu. Nếu truy xuất sai, xem lại cấu trúc tài liệu và cơ chế tìm kiếm. Nếu câu hỏi vượt phạm vi, thiết kế câu trả lời từ chối hoặc luồng chuyển người thật. Nếu model suy diễn, thêm ràng buộc và kiểm tra. Đổ tất cả vào “model chưa đủ thông minh” là cách nhanh nhất để chi thêm tiền mà không học được gì.
AI đáng tin không phải AI chưa từng sai. Đó là AI biết mình được phép trả lời việc gì, dựa trên nguồn nào, và chuyển cho người chịu trách nhiệm ở điểm nào.
Quy trình vận hành quyết định AI sinh lời hay thành gánh nặng
McKinsey cho thấy các tổ chức thu được lợi nhuận tài chính cao nhất từ AI có xác suất tái cấu trúc Workflow đầu-cuối trước khi chọn công cụ hay kỹ thuật mô hình hóa cao gấp 2 lần. Đây là phát hiện đáng chú ý vì nó chạm đúng sai lầm phổ biến: doanh nghiệp coi AI là dự án công nghệ, trong khi phần khó nhất thường là thay đổi cách công việc chạy qua các phòng ban.
Một Workflow đầu-cuối không phải chỉ là việc của một người. Nó gồm điểm khởi phát, dữ liệu đầu vào, các bước xử lý, điều kiện ngoại lệ, quyền phê duyệt, đầu ra và cách đo kết quả. Nếu không vẽ được luồng này, doanh nghiệp chưa đủ rõ để giao nó cho AI Agent hay automation.
Lấy một ví dụ minh họa về xử lý yêu cầu khách hàng. Tin nhắn vào, nhân viên phân loại, tra chính sách, kiểm tra đơn hàng, có thể cần xin duyệt, sau đó trả lời và ghi nhận kết quả. AI có thể hỗ trợ phân loại, tìm chính sách, soạn nháp và tóm tắt. Nhưng AI không nên tự hứa hoàn tiền nếu chính sách yêu cầu cấp quản lý phê duyệt. AI cũng không nên tự ghi đè trạng thái đơn hàng nếu nguồn dữ liệu chưa được xác định. Một hệ thống tốt sẽ biết điểm nào tự động, điểm nào có Human-in-the-loop và điểm nào cần dừng.
Tự động hóa quy trình rác chỉ làm rác chạy nhanh hơn
Câu này nghe sáo, nhưng nhiều dự án vẫn lặp lại đúng kịch bản đó. Doanh nghiệp tự động gửi báo giá trong khi bảng giá thiếu kiểm soát phiên bản. Họ tự động tạo ticket trong khi không có quy tắc phân loại. Họ cho AI tóm tắt cuộc gọi nhưng không xác định tóm tắt đó đi về đâu, ai hành động và kết quả có quay lại hệ thống không.
Trước khi tự động hóa, hãy hỏi bốn câu khó: bước nào thực sự tạo giá trị; bước nào chỉ tồn tại vì lịch sử; ngoại lệ nào xảy ra; ai có quyền quyết định khi ngoại lệ xuất hiện? Có khi kết quả tốt nhất của một dự án AI không phải là chatbot mới, mà là phát hiện quy trình đang có ba lần nhập liệu vô ích. Đó là kết quả đáng tiền, dù không hào nhoáng trong demo.
RACI và Human-in-the-loop không phải thủ tục giấy tờ
Với mỗi Workflow có AI, doanh nghiệp nên xác định tối thiểu ai chịu trách nhiệm thực hiện, ai phê duyệt, ai cần được tham vấn và ai cần được thông báo. Đó là logic RACI. Không cần biến SME thành một bộ máy quan liêu. Nhưng cần tránh tình trạng AI tạo đầu ra, nhân viên tưởng người khác đã kiểm tra, rồi không ai thực sự sở hữu quyết định.
Human-in-the-loop cũng cần đặt đúng chỗ. Nếu bắt con người kiểm tra mọi câu trả lời đơn giản, lợi ích năng suất sẽ biến mất. Nếu bỏ kiểm tra ở quyết định nhạy cảm, rủi ro tăng. Điểm kiểm tra nên nằm ở các hành động có tác động tài chính, pháp lý, quan hệ khách hàng hoặc thay đổi dữ liệu gốc. Những việc lặp lại, phạm vi hẹp và có quy tắc rõ có thể tự động nhiều hơn.
Các giao thức kết nối như MCP sẽ hữu ích khi hệ thống cần gọi nhiều công cụ và nguồn dữ liệu, nhưng kết nối được không đồng nghĩa quản trị được. Tôi đã viết thêm về phần này trong bài MCP là gì? và vì sao người làm automation nên quan tâm?. Công cụ kết nối giúp AI đi xa hơn; vì thế doanh nghiệp càng phải rõ nó được phép chạm vào đâu.
Khung 10/20/70: cách phân bổ lại tiền và sự chú ý
Một khung từ MIT và các chuyên gia được nhắc tới nhiều là 10/20/70: 10% cho thuật toán hoặc model, 20% cho nền tảng công nghệ và dữ liệu, 70% cho con người và quy trình. Tôi không xem đây là công thức kế toán phải áp đúng đến từng đồng. Giá trị của nó nằm ở việc đập vỡ tư duy ngược mà nhiều SME đang mang theo: dồn 80-90% tiền bạc và sự chú ý vào API hoặc tool, rồi hy vọng phần còn lại tự khớp.
10% cho model: chọn vừa vặn thay vì overkill
Model nên được chọn sau khi Use Case đã rõ. Nếu việc cần làm là phân loại email, trích xuất trường dữ liệu hay soạn nháp theo mẫu, đừng mặc định phải dùng giải pháp phức tạp nhất. Cần xem độ chính xác yêu cầu, chi phí vận hành, độ trễ, khả năng tích hợp và mức độ nhạy cảm của dữ liệu. Đó là quyết định kỹ thuật lành mạnh hơn việc chạy theo tên model đang được nhắc nhiều.
Việc model là commodity không có nghĩa model nào cũng như nhau. Nó có nghĩa lợi thế cạnh tranh của SME hiếm khi nằm ở model đơn lẻ. Đừng biến quyết định model thành tâm điểm chiến lược khi doanh nghiệp còn chưa có định nghĩa thống nhất về một đơn hàng hoàn tất hay một khách hàng tiềm năng đủ điều kiện.
20% cho dữ liệu và hạ tầng: xây đường ống tối thiểu nhưng thật
Phần này bao gồm xác định nguồn dữ liệu, làm sạch, cấu trúc hóa, phân quyền, theo dõi thay đổi và thiết lập Data Pipeline. Không nhất thiết phải khởi đầu bằng Data Warehouse lớn. SME cần một mức tối thiểu có thể vận hành: nguồn nào được xem là chuẩn, dữ liệu cập nhật ra sao, ai chịu trách nhiệm, AI được truy cập trường nào, và khi có lỗi thì quay về đâu.
Theo Integrate.io, các tổ chức có khả năng tích hợp dữ liệu mạnh đạt ROI tới 10.3x, trong khi các tổ chức có dữ liệu phân mảnh đạt 3.7x. Con số này không phải lời hứa ROI cho từng SME. Nó là tín hiệu rõ rằng tích hợp dữ liệu không phải phần việc phụ của dự án AI. Nó là nền móng của giá trị.
70% cho con người và quy trình: phần ít sexy nhưng quyết định sống chết
Con người ở đây không chỉ là đào tạo cách viết prompt. Đó là Data Literacy: nhân viên hiểu dữ liệu mình nhập dùng vào đâu, biết lỗi nào nguy hiểm, hiểu khi nào phải phản biện đầu ra AI. Đó cũng là quản trị thay đổi: ai mất việc gì, ai có thêm trách nhiệm gì, ai được khuyến khích dùng hệ thống mới, và phản hồi của họ quay lại đội triển khai bằng đường nào.
Tôi có quan điểm khá cứng về chuyện này: nếu nhân viên bị xem là người phải “tuân thủ AI” thay vì người hiểu rõ Workflow để cùng thiết kế AI, dự án thường sẽ bị phá ngầm. Họ sẽ quay lại Excel cũ, nhắn Zalo riêng, hoặc nhập dữ liệu cho có. Không phải vì họ chống công nghệ một cách vô lý, mà vì hệ thống mới không xử lý được các ngoại lệ mà họ gặp hằng ngày.
Hai kịch bản SME thường gặp và bài học thực dụng
Hãy xét hai tình huống minh họa, không phải case study của một doanh nghiệp cụ thể. Chúng phản ánh kiểu thất bại và cách đảo chiều khá phổ biến.
Kịch bản thất bại: chatbot và dự báo chạy trên các nguồn bị đứt
Một SME bán lẻ muốn làm chatbot để tư vấn khách và dự báo để hỗ trợ nhập hàng. Đội triển khai kết nối website, một phần CRM và vài file sản phẩm. Rất nhanh, chatbot trả lời các chương trình cũ vì tài liệu khuyến mãi chưa được gỡ. Nó không biết tồn kho thực tế vì kho cập nhật ở một bảng Excel riêng. Khi khách hỏi giá, AI chọn một trong nhiều bảng giá. Dự báo cũng đáng ngờ vì dữ liệu mã hàng bị thay đổi, đơn vị tính không nhất quán và các đợt thiếu hàng không được ghi chú.
Phản ứng sai là đổi model hoặc viết prompt dài hơn. Phản ứng đúng là tạm thu hẹp phạm vi, chỉ cho chatbot trả lời các câu hỏi dựa trên nguồn đã được xác nhận, hiển thị nguồn tham chiếu, và chuyển sang nhân viên khi đụng giá, tồn kho hay khuyến mãi. Song song, doanh nghiệp phải chọn một nguồn chuẩn cho sản phẩm, giá và tồn kho. Có thể việc này nghe chậm, nhưng nó nhanh hơn nhiều so với việc đốt tiền vào một chatbot làm khách mất niềm tin.
Kịch bản tốt hơn: chuẩn hóa tài liệu rồi mới cho AI hỗ trợ CSKH
Một SME dịch vụ bắt đầu từ luồng CSKH. Họ không vội cho AI tự trả lời. Trước hết, họ gom các chính sách đang dùng, loại bản trùng, gắn ngày hiệu lực, quy định người phụ trách cập nhật và xác định nhóm câu hỏi nào nhân viên được xử lý ngay. Sau đó, AI hỗ trợ tìm tài liệu liên quan, tóm tắt yêu cầu và soạn nháp. Nhân viên duyệt các trường hợp có ngoại lệ, đồng thời đánh dấu câu trả lời nào chưa tốt để đội vận hành cải thiện nguồn.
Điểm quan trọng là doanh nghiệp không “mua chatbot”. Họ sửa luồng xử lý yêu cầu và dùng AI ở các đoạn AI có lợi thế. KPI nên gắn với Workflow đó: thời gian xử lý, số lần phải hỏi lại, tỷ lệ yêu cầu được xử lý đúng phạm vi, hoặc khối lượng công việc nhân viên tiết kiệm được. Đừng đo dự án bằng số lượng câu hỏi chatbot đã trả lời. Một chatbot trả lời rất nhiều câu sai chỉ chứng minh nó hoạt động rất chăm.
Mua năng lực chuyển giao, đừng mua sự phụ thuộc
Thuê ngoài là hợp lý khi SME thiếu đội ngũ kỹ thuật. Nhưng hợp đồng triển khai cần có phần chuyển giao năng lực: tài liệu nguồn nằm ở đâu, Data Pipeline chạy thế nào, ai sửa dữ liệu, ai theo dõi lỗi, cách thay đổi Workflow và cách đo KPI. Nếu mọi thay đổi nhỏ đều phải gọi nhà cung cấp, doanh nghiệp không sở hữu hệ thống; họ đang thuê một chiếc hộp đen.
Điều này càng quan trọng khi chọn giải pháp open-weight hay phần mềm có giấy phép phức tạp. “Open” không tự động có nghĩa là miễn phí hay dễ vận hành. Nếu đang cân nhắc hướng đó, bài AI mở không miễn phí: Cuộc chiến giành quyền thu tiền ở lớp triển khai có thể giúp bạn nhìn rõ hơn chi phí nằm ngoài model.
Khung 5 bước kiểm tra Data Readiness cho SME
Không cần chờ dữ liệu hoàn hảo mới làm AI. Đó cũng là một cái cớ để trì hoãn. Mục tiêu là đạt mức Minimum Viable Data Quality cho một Use Case hẹp, rồi cải thiện liên tục. Tôi sẽ đi theo năm bước sau.
Bước 1: Data Audit theo Use Case, không audit cho có
Chọn một Use Case cụ thể, rồi liệt kê dữ liệu nó thực sự cần. Ví dụ, AI hỗ trợ CSKH cần chính sách hiện hành, thông tin đơn hàng, trạng thái xử lý và lịch sử liên quan. Với từng nguồn, hỏi: ai sở hữu, cập nhật khi nào, có bao nhiêu phiên bản, có trường nào thiếu, và hệ thống có quyền truy cập hợp lệ không? Đừng bắt đầu bằng việc lập một danh sách dữ liệu khổng lồ cho toàn công ty.
Bước 2: Chuẩn hóa mức tối thiểu
Xác định tên trường, định dạng, mã định danh, trạng thái và quy tắc xử lý bản ghi trùng. Chỉ chuẩn hóa những gì Use Case cần trước. Nếu chatbot cần chính sách đổi trả, tài liệu phải có ngày hiệu lực, phạm vi áp dụng và chủ sở hữu. Nếu AI cần đọc dữ liệu khách hàng, phải có cách nhận diện khách hàng nhất quán. Việc nhỏ, nhưng đây là chỗ dự án có thể đi từ demo sang vận hành.
Bước 3: Thiết lập Data Governance gọn nhẹ
Data Governance ở SME không cần một ban điều hành đông người. Nó cần câu trả lời rõ cho vài việc: dữ liệu nào là nguồn chuẩn; ai được sửa; ai phê duyệt thay đổi; dữ liệu nào AI không được đọc; khi phát hiện lỗi thì ai xử lý. Thêm lịch sử thay đổi nếu có thể. Khi AI trả lời sai, khả năng truy vết là thứ giúp đội ngũ sửa đúng chỗ thay vì tranh cãi cảm tính.
Bước 4: Thiết kế lại Workflow và KPI trước ngày go-live
Vẽ Workflow hiện tại, chỉ ra điểm nghẽn, thiết kế Workflow mới và gắn KPI vào nó. KPI phải liên quan đến giá trị kinh doanh, không phải độ phức tạp kỹ thuật. Câu hỏi cần trả lời là: thời gian xử lý có giảm không, lỗi có giảm không, năng suất có tăng không, vòng hoàn vốn có rõ không? Nếu không có cách đo trước khi triển khai, sau đó bạn chỉ còn cảm giác “hình như AI có ích”.
Bước 5: Pilot hẹp, có vòng phản hồi
Chọn một nhóm người dùng, một loại yêu cầu hoặc một tập tài liệu có kiểm soát. Đừng tung cho cả công ty ngay khi hệ thống chạy được. Theo dõi lỗi, ghi nhận câu hỏi ngoài phạm vi, xem người dùng có đi vòng qua hệ thống hay không, rồi sửa dữ liệu và Workflow. Pilot tốt không phải pilot không có lỗi. Nó là pilot tạo ra thông tin đủ rõ để biết nên mở rộng, sửa hay dừng.
Lời khuyên cho founder và CEO SME: bắt đầu từ gốc rễ, không từ slide demo
Nếu tôi là CEO SME chuẩn bị đầu tư AI, tôi sẽ không hỏi đội ngũ “chúng ta có chiến lược AI chưa?”. Tôi sẽ hỏi: ba Workflow nào đang làm mất thời gian hoặc tiền nhiều nhất? Dữ liệu nào quyết định các Workflow đó? Dữ liệu ấy ai sở hữu? Đầu ra nào có thể đo được trong một pilot hẹp? Những câu hỏi này ít hào hứng hơn chuyện AI Agent, nhưng chúng tách dự án có khả năng sống khỏi dự án chỉ đẹp trong buổi trình diễn.
Đừng giao AI hoàn toàn cho IT. IT cần thiết kế tích hợp, bảo mật và vận hành kỹ thuật. Nhưng chủ sở hữu bài toán phải là người chịu KPI nghiệp vụ. Sales phải sở hữu định nghĩa lead tốt. CSKH phải sở hữu chính sách và chất lượng phản hồi. Vận hành phải sở hữu quy tắc xử lý ngoại lệ. Khi mọi người coi AI là việc của “team công nghệ”, dữ liệu sẽ tiếp tục bẩn vì không ai thấy mình có trách nhiệm.
Cũng đừng chờ một kho dữ liệu hoàn hảo. Hãy bắt đầu nhỏ, nhưng chọn vấn đề thật. Làm sạch phần dữ liệu cần cho vấn đề đó. Tái thiết Workflow đủ để AI không bị đẩy vào vùng mơ hồ. Thiết kế Human-in-the-loop. Đo kết quả. Sau đó mới mở rộng. Đây là cách chậm hơn so với việc mua một gói chatbot trong tuần đầu, nhưng là cách có cơ hội tạo giá trị lâu hơn.
Thị trường AI năm 2026 không thiếu model. Nó thiếu doanh nghiệp chịu làm những việc không có hào quang: dọn dữ liệu, cắt bước thừa, thống nhất định nghĩa và kỷ luật vận hành. Theo tôi, SME làm được những việc đó sẽ có lợi thế rõ hơn SME chỉ sở hữu tool mới nhất. Vì tool có thể mua, còn dữ liệu sạch và Workflow chạy tốt phải được xây.
Câu hỏi thường gặp
SME chưa có Data Warehouse lớn có triển khai AI được không?
Có, nếu bắt đầu bằng Use Case hẹp và tạo được mức dữ liệu tối thiểu đáng tin cho Use Case đó. Data Warehouse lớn không phải giấy thông hành bắt buộc. Thứ cần có là nguồn dữ liệu rõ ràng, cấu trúc đủ dùng, quyền truy cập hợp lệ, người sở hữu dữ liệu và Workflow có thể đo. Đừng lấy việc chưa có hạ tầng lớn làm lý do mua tool vội hơn, nhưng cũng đừng dùng nó làm lý do không bắt đầu.
Phân biệt dữ liệu nhiều với AI-ready data bằng cách nào?
Dữ liệu nhiều là có nhiều file, bản ghi hoặc tài liệu. AI-ready data là dữ liệu liên quan đến một Use Case, có nguồn gốc rõ, có cấu trúc hoặc metadata cần thiết, còn hiệu lực, ít mâu thuẫn và có thể truy vết khi đầu ra AI gặp vấn đề. Nếu không biết bản ghi nào là đúng khi hai nguồn khác nhau, dữ liệu đó chưa sẵn sàng cho một quyết định tự động.
Khi AI trả lời sai, làm sao biết lỗi do model, prompt hay dữ liệu?
Hãy kiểm tra theo thứ tự: AI có được cung cấp nguồn đúng không; nguồn đó có chứa câu trả lời chính xác và còn hiệu lực không; cơ chế RAG có truy xuất đúng tài liệu không; prompt có giới hạn AI chỉ dùng nguồn đó không; và câu hỏi có nằm trong phạm vi thiết kế không. Chỉ sau khi loại trừ các lớp này mới nên kết luận model là nút thắt. Cách làm này biến lỗi thành dữ liệu để cải thiện, thay vì thành một cuộc tranh luận vô tận.
SME nên tự xây đội AI hay thuê nhà cung cấp?
Cả hai đều có thể hợp lý. Thuê ngoài phù hợp khi cần tốc độ hoặc thiếu năng lực kỹ thuật. Nhưng SME vẫn phải giữ quyền sở hữu Use Case, dữ liệu, KPI và quy trình vận hành. Hãy yêu cầu nhà cung cấp chuyển giao tài liệu, cách theo dõi lỗi, cách cập nhật dữ liệu và cách vận hành sau pilot. Nếu đội nội bộ không hiểu hệ thống sau khi nhà cung cấp rời đi, chi phí phụ thuộc sẽ xuất hiện rất nhanh.
ROI của AI nên đo bằng gì?
Đo theo KPI của Workflow: thời gian xử lý, khối lượng công việc hoàn thành, lỗi vận hành, số lần cần can thiệp, hay vòng hoàn vốn. Tránh đo bằng số prompt, số câu trả lời của chatbot hoặc số tính năng đã bật. Các chỉ số đó có thể hữu ích cho đội kỹ thuật, nhưng chúng không chứng minh AI tạo giá trị kinh doanh.
Nguồn tham khảo: Dữ liệu và quy trình quan trọng hơn AI model: Bài học triển khai AI thất bại cho SME
Bài viết là góc nhìn cá nhân của tác giả, mang tính tham khảo — không phải tin tức báo chí.
📬 Nhận bài viết mới — miễn phí
Đừng bỏ lỡ bài viết tiếp theo. Đăng ký để nhận trong inbox.

Tác giả
Cường Nguyễn — AI Thực Chiến
Tôi là Cường Nguyễn - Founder của AI Ops Solutions.
Tôi từng là Logistics Operations Manager và đồng sáng lập thương hiệu CATCA - #1 Shopee ngành Pet Care.
10 năm kinh nghiệm Logistics/E-commerce OperationsCo-founder CATCA - #1 Shopee ngành Pet CareMột trong 300+ n8n Verified Creator toàn cầuTư vấn Giải pháp chuyển đổi số bằng AI cho 3 SMEs/quý


