Bài viết
Bài viết cá nhân
Gemini 4 Neon đứng đầu LiveBench 2.0 với 87.4 điểm: Lợi thế nằm ở agent dài hạn và chi phí vận hành
👤 cuongnguyen📅 22/11/2026⏱ 5 phút đọc
Tin chính là gì?
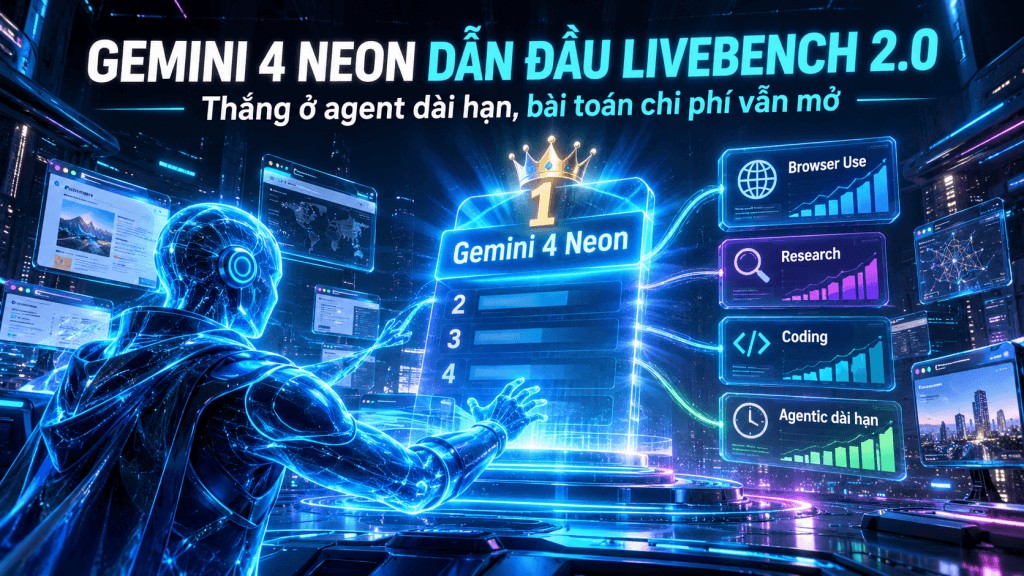
Gemini 4 Neon của Google đang dẫn đầu LiveBench 2.0 với 87.4 điểm, cao hơn 2.5 điểm so với Claude Fable 5.2 của Anthropic và GPT-6.2 Astra của OpenAI, cùng đạt 84.9. Theo phân tích từ FourWeekMBA, Neon thắng nhờ kết quả mạnh ở các bài test AI Agent làm việc đầu cuối, đặc biệt là Browser Use.
Neon đạt 95.6 điểm Browser Use và hòa Fable 5.2 ở hạng mục Research với 94.5 điểm. Astra lại dẫn đầu Coding trong ba model với 91.9 điểm; Fable 5.2 dẫn Agentic với 82.9 điểm và Design với 85.1 điểm.
Bức tranh chi phí cũng đáng nhìn kỹ. LiveBench ghi nhận chi phí mỗi tác vụ thành công của Astra là 1.941 USD, Neon là 2.654 USD, còn Fable 5.2 lên tới 9.850 USD. Neon dẫn điểm tổng nhưng không phải model rẻ nhất để vận hành.
Vì sao đáng chú ý?
LiveBench khác các benchmark hỏi-đáp đơn lẻ ở chỗ họ ưu tiên tác vụ có đích đến: sửa lỗi trong codebase lớn, dùng công cụ, điều hướng web, thu thập và xử lý thông tin. Bảng có bảy bộ đánh giá, trong đó năm bộ là agentic. Đây là kiểu bài kiểm tra gần với sản phẩm AI Agent mà đội kỹ thuật đang cố đưa vào quy trình thật.
Cách tính điểm cũng giải thích vì sao Neon vượt lên. Bộ đánh giá agentic dài hạn được tính gấp đôi; Coding và Design được nhân hệ số 1.5. Astra chỉ đạt 70.8 ở agentic dài hạn, thấp hơn Neon và Fable 5.2 khoảng 12 điểm. Một model code giỏi vẫn có thể thua khi phải lập kế hoạch nhiều bước, gọi tool, xử lý trạng thái và hoàn tất nhiệm vụ mà không đánh rơi mục tiêu giữa chừng.
Dù vậy, đừng biến LiveBench thành phán quyết cuối cùng. Trên Artificial Analysis, Fable 5.2 đạt 65 điểm, cao hơn Astra với 62; trên Arena text leaderboard, Google giữ ba vị trí đầu nhưng Gemini 4 Carbon mới dẫn đầu, còn Neon đứng thứ ba. Mỗi benchmark đang thưởng cho một kiểu năng lực khác nhau.

Tác động thực chiến
Đội xây AI Agent nên bỏ tư duy chọn model theo “ngôi vương” tổng quát. Nếu workflow chủ yếu thao tác trình duyệt, xác minh thông tin và hoàn thành chuỗi bước trên web, Neon là ứng viên cần thử đầu tiên vì điểm Browser Use 95.6. Nếu tác vụ tập trung vào coding, Astra có tín hiệu mạnh hơn với 91.9 điểm và chi phí mỗi tác vụ thành công thấp nhất trong ba model.
Fable 5.2 có thể phù hợp khi chất lượng Agentic và Design là ưu tiên, nhưng mức 9.850 USD/tác vụ thành công buộc doanh nghiệp phải chứng minh ROI trước khi mở rộng. Chênh lệch chi phí sẽ phình nhanh khi agent chạy hàng nghìn phiên, retry nhiều lần hoặc cần human review.
- Đừng đo token: đo chi phí trên một tác vụ hoàn tất đúng tiêu chuẩn.
- Đừng chỉ đo pass rate: theo dõi số lần gọi tool, retry, thời gian hoàn thành và tỷ lệ cần người can thiệp.
- Đừng tin benchmark mù quáng: LiveBench dùng một lần chạy cho mỗi bộ đánh giá, nên kết quả cần được kiểm tra lại trên dữ liệu nội bộ.
Cường Nguyễn nhận định
Điểm 87.4 của Neon là tín hiệu tốt cho Google, nhưng chưa đủ để tuyên bố họ đã giải bài toán AI Agent. Khoảng cách 2.5 điểm rất dễ bị diễn giải quá mức, nhất là khi bảng dựa trên một lần chạy cho mỗi bộ. Điều đáng giá hơn nằm ở sự tụt hậu của Astra tại agentic dài hạn: một agent thất bại ở bước 17 sau khi làm đúng 16 bước trước đó vẫn là thất bại hoàn toàn trong sản xuất.
Tôi đánh giá LiveBench hữu ích vì nó thưởng cho khả năng hoàn thành việc, thay vì thưởng cho câu trả lời nghe thuyết phục. Nhưng trọng số gấp đôi cho agentic dài hạn cũng khiến thứ hạng phản ánh triết lý thiết kế của benchmark, không phải chân lý phổ quát. Google thắng bài thi này; chưa chắc đã thắng workflow của doanh nghiệp bạn.
Khuyến nghị cụ thể cho engineer và founder: hãy lập một scorecard nội bộ gồm điểm agentic trên task thật, chi phí mỗi tác vụ thành công và tỷ lệ hoàn thành không cần người sửa. Chạy cùng một tập nhiệm vụ trên Neon, Astra và Fable 5.2 trước khi ký hợp đồng hoặc thay model mặc định. Đây là cách duy nhất biến benchmark thành quyết định kỹ thuật có trách nhiệm.
Câu hỏi thường gặp
LiveBench 2.0 đo những gì?
LiveBench có bảy bộ đánh giá; năm bộ kiểm tra tác vụ agentic, nơi model phải dùng công cụ để hoàn thành nhiệm vụ đầu cuối. Bộ agentic dài hạn được tính gấp đôi trong điểm tổng, còn Coding và Design được nhân hệ số 1.5.
Gemini 4 Neon có thực sự tốt hơn Claude Fable 5.2 và GPT-6.2 Astra không?
Trên LiveBench 2.0, Neon dẫn với 87.4 điểm so với 84.9 của hai model còn lại. Nhưng Fable 5.2 dẫn Astra trên Artificial Analysis, còn Neon đứng thứ ba trên Arena text leaderboard. “Tốt nhất” luôn phụ thuộc vào loại tác vụ và cách benchmark chấm điểm.
Vì sao phải xem chi phí mỗi tác vụ thành công?
Điểm benchmark không phản ánh giá để hoàn tất công việc. Theo số liệu được FourWeekMBA trích dẫn từ LiveBench, Astra tốn 1.941 USD, Neon 2.654 USD và Fable 5.2 tốn 9.850 USD cho mỗi tác vụ thành công. Với hệ thống chạy ở quy mô lớn, đây là biến số quyết định khả năng triển khai.
Nguồn tham khảo: FourWeekMBA
Tác giả: Cường Nguyễn — Founder AI Ops Solutions | Verified n8n Creator. Kết nối: Facebook · LinkedIn · YouTube · TikTok
Bài viết là góc nhìn cá nhân của tác giả, mang tính tham khảo — không phải tin tức báo chí.
📬 Nhận bài viết mới — miễn phí
Đừng bỏ lỡ bài viết tiếp theo. Đăng ký để nhận trong inbox.
Tác giả
Cường Nguyễn — AI Thực Chiến
Tôi là Cường Nguyễn - Founder của AI Ops Solutions.
Tôi từng là Logistics Operations Manager và đồng sáng lập thương hiệu CATCA - #1 Shopee ngành Pet Care.
10 năm kinh nghiệm Logistics/E-commerce OperationsCo-founder CATCA - #1 Shopee ngành Pet CareMột trong 300+ n8n Verified Creator toàn cầuTư vấn Giải pháp chuyển đổi số bằng AI cho 3 SMEs/quý


