Bài viết
Bài viết cá nhân
Gemini Decision 1: Google muốn thay LLM bằng “máy ra quyết định” cho agent
👤 cuongnguyen📅 12/11/2026⏱ 5 phút đọc
Tin chính là gì?
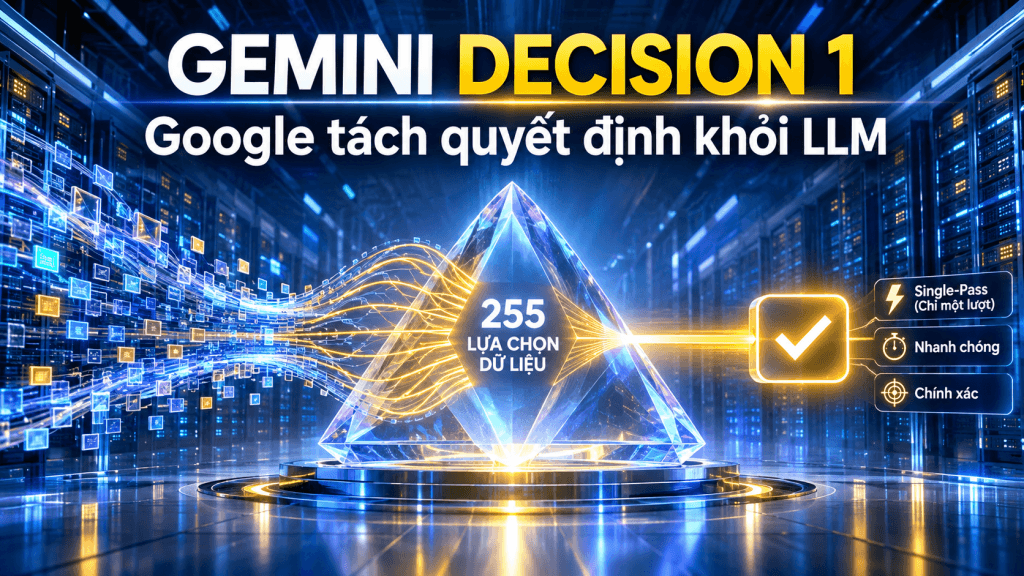
Theo bản tin của Latent Space AI News, Google đã công bố Gemini Decision 1 cùng Gemini Decisions API tại AI Engineer ngày 11/11/2026. Đây không phải LLM sinh câu trả lời token-by-token. Nó xử lý bài toán tập đóng: nhận một danh sách lựa chọn, chấm điểm và chọn đáp án trong một lượt.
Decision 1 hỗ trợ câu hỏi yes/no, trắc nghiệm tối đa 255 lựa chọn, chấm điểm theo rubric, và nhận text, ảnh, audio, video lẫn PDF. API xử lý tối đa 1.000 câu hỏi mỗi request, context window 256K, độ trễ end-to-end Google công bố là 150–250 ms. Mỗi kết quả đi kèm confidence score.
Google định giá 0,10 USD cho một triệu token đầu vào, miễn phí token đầu ra, và nói mức này rẻ hơn khoảng 5 lần Flash-Lite. Dự án xuất phát từ một prototype nội bộ của Google DeepMind; một nhóm nhỏ đã đưa nó ra thị trường sau khoảng sáu tuần.
Vì sao đáng chú ý?
Đây là tín hiệu rõ ràng rằng kiến trúc AI Agent đang rời xa tư duy “một LLM làm mọi việc”. Chọn tool, phân loại ticket, kiểm tra policy, trích xuất trạng thái log hay chấm điều kiện là các quyết định hữu hạn. Ép một mô hình sinh ngôn ngữ viết reasoning dài để trả lời các tác vụ này vừa tốn token, vừa tăng latency, vừa tạo thêm điểm hỏng.
Google công bố Decision 1 vượt Jev 1.14 ở 5/7 benchmark dùng chung; ví dụ đạt 92,2% trên JevBench, so với 90,0% của Jev. Nhưng đây chưa phải giấy chứng nhận chiến thắng. Kết quả từ Artificial Analysis cho bức tranh kém đẹp hơn: Decision Index là 66, ngang Elephant 9B và Jev 1.14, thấp hơn Drex Max v1.1 cùng GLiDE v1.2 khoảng 7 điểm.
Chi phí thực thi cũng không hoàn toàn khớp với câu chuyện giá token. Artificial Analysis ước tính 345 USD cho một triệu tác vụ, cao hơn Drex Max với 103 USD và Jev với 156 USD. Decision 1 mất trung bình 211 ms mỗi tác vụ, trong khi Jev là 92 ms. Trên AA-Paperclip, nó trả lời đúng hoàn toàn 33% tài liệu, thấp xa mức 63% của Drex Max.

Tác động thực chiến
Builder nên coi Decision 1 là một lớp routing chuyên dụng, không phải bộ não thay thế LLM lớn. Luồng hợp lý là để mô hình quyết định nhanh chọn tool, phân loại intent, chấm mức rủi ro hoặc trích xuất tín hiệu; chỉ đẩy các ca mơ hồ sang mô hình suy luận lớn để chẩn đoán và tạo câu trả lời.
Demo của Cloudflare cho thấy giá trị của cách tách lớp này: kiến trúc agent lai giảm từ 6 lời gọi LLM xuống 1, đồng thời hạ mức tiêu thụ từ khoảng 40K token xuống 1,8K token. Đây là đòn đánh trực tiếp vào chi phí vận hành và tail latency của agent production.
- Dùng Decision 1 cho tool selection, triage ticket, log classification và policy gate.
- Giữ LLM lớn cho chẩn đoán sâu, ngoại lệ khó và nội dung cần diễn đạt tự nhiên.
- Đo chi phí theo tác vụ hoàn chỉnh, thay vì bị hấp dẫn bởi bảng giá token đầu vào.
LangChain đã hỗ trợ ngay ngày đầu, giảm ma sát tích hợp. Tuy vậy, số liệu Google và Artificial Analysis chưa đồng thuận; đội kỹ thuật phải benchmark trên dữ liệu thật của mình trước khi thay đổi kiến trúc.
Cường Nguyễn nhận định
Google đang đi đúng hướng về kiến trúc: tách “quyết định” khỏi “sinh văn bản” thực tế hơn nhiều so với việc ném một LLM lớn vào mọi node của agent graph. Một agent tốt không cần suy luận dài dòng để biết ticket này thuộc nhóm nào hay tool nào cần gọi tiếp theo.
Nhưng Decision 1 chưa có quyền được gọi là lựa chọn mặc định. Google thắng JevBench, còn Artificial Analysis lại ghi nhận độ trễ kém Jev, chi phí mỗi tác vụ cao hơn Jev và Drex Max, cùng kết quả yếu trên AA-Paperclip. Sự lệch pha này cho thấy benchmark đang đo các dạng quyết định khác nhau; marketing benchmark không thay thế workload benchmark.
Khuyến nghị cụ thể: hãy lập bộ đánh giá nội bộ 200–500 ví dụ production đã gán nhãn, đo accuracy, p90 latency, calibration của confidence và chi phí mỗi tác vụ. So sánh Decision 1 với Jev cùng một LLM nhỏ đang dùng. Chỉ triển khai khi nó thắng rõ ở tác vụ hẹp, khối lượng lớn; đừng migration hàng loạt chỉ vì giá token nghe hấp dẫn.
Câu hỏi thường gặp
Gemini Decision 1 khác gì một LLM thông thường?
Google cho biết nó chấm điểm các lựa chọn trong một lượt thay vì sinh văn bản từng token. Nó phục vụ yes/no, trắc nghiệm tối đa 255 đáp án và rubric scoring, đồng thời trả confidence cho mỗi kết quả.
Giá và độ trễ của Gemini Decision 1 là bao nhiêu?
Google công bố giá 0,10 USD cho một triệu token đầu vào, miễn phí đầu ra, với độ trễ 150–250 ms. Artificial Analysis đo trung bình 211 ms mỗi tác vụ và 345 USD cho một triệu tác vụ trong bài đánh giá của họ.
Có nên chuyển hệ thống LLM hiện tại sang Decision 1 ngay không?
Không nên chuyển hàng loạt. Hãy thử trên tập dữ liệu nội bộ và so sánh accuracy, p90 latency, confidence calibration, chi phí mỗi tác vụ với stack hiện tại. Nó đáng thử nhất ở các tác vụ phân loại và routing có tập đáp án rõ ràng.
Nguồn tham khảo: Latent Space AI News
Tác giả: Cường Nguyễn — Founder AI Ops Solutions | Verified n8n Creator. Kết nối: Facebook · LinkedIn · YouTube · TikTok
Bài viết là góc nhìn cá nhân của tác giả, mang tính tham khảo — không phải tin tức báo chí.
📬 Nhận bài viết mới — miễn phí
Đừng bỏ lỡ bài viết tiếp theo. Đăng ký để nhận trong inbox.
Tác giả
Cường Nguyễn — AI Thực Chiến
Tôi là Cường Nguyễn - Founder của AI Ops Solutions.
Tôi từng là Logistics Operations Manager và đồng sáng lập thương hiệu CATCA - #1 Shopee ngành Pet Care.
10 năm kinh nghiệm Logistics/E-commerce OperationsCo-founder CATCA - #1 Shopee ngành Pet CareMột trong 300+ n8n Verified Creator toàn cầuTư vấn Giải pháp chuyển đổi số bằng AI cho 3 SMEs/quý


