Bài viết
Bài viết cá nhân
Intelligence Index v5: Benchmark riêng tư phơi bày khoảng cách thật của AI
👤 cuongnguyen📅 28/10/2026⏱ 5 phút đọc
Tin chính là gì?
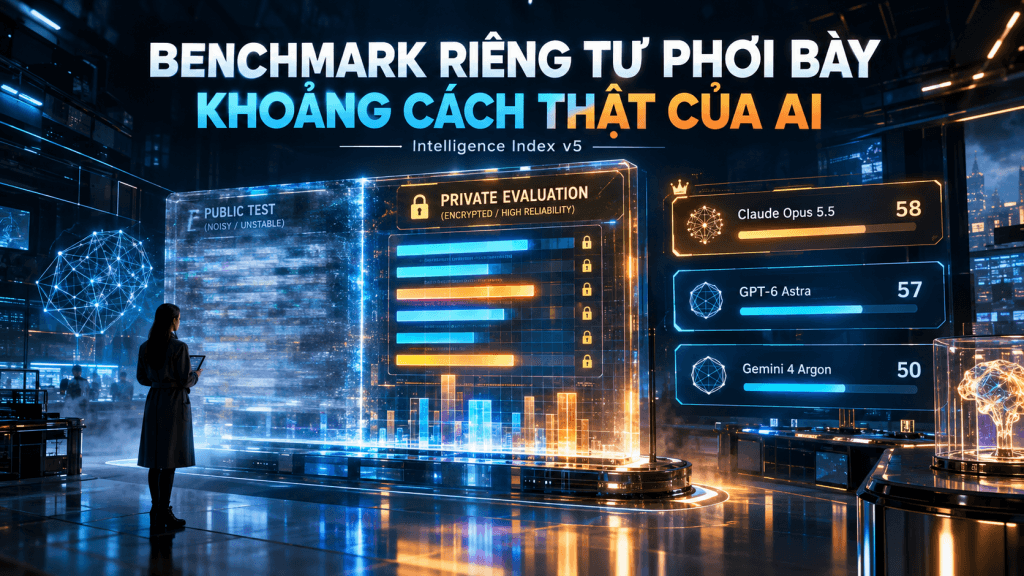
Artificial Analysis vừa phát hành Intelligence Index v5, đợt cập nhật lớn nhất từ v4 hồi tháng 1, theo bài công bố được OfficeChai dẫn lại. Thay đổi đáng giá nhất: lần đầu 60% chỉ số dựa trên bộ test riêng tư hoặc đáp án giữ kín. Mục tiêu rất rõ: giảm benchmark contamination, khi dữ liệu đánh giá công khai có thể đã bị các mô hình “học thuộc” qua dữ liệu web.
v5 đưa vào FrontierCode 2.0, chấm năng lực xử lý việc lập trình thực tế trong repo mã nguồn mở theo tiêu chí maintainer có merge pull request hay không, cùng Terminal-Bench-Science gồm 70 tác vụ nghiên cứu khoa học agentic trong terminal. Artificial Analysis cũng ra mắt Progress Index v1, theo dõi năng lực trên thang liên tục thay vì reset thành tích sau mỗi phiên bản benchmark.
Trên bảng tổng, Claude Opus 5.5 (max) dẫn đầu với 58 điểm, sát sau là GPT-6 Astra (max) với 57 điểm và GPT-6.1 Sol (max) với 55 điểm. Anthropic và OpenAI chiếm toàn bộ top 5; Gemini 4 Argon (high) đứng kế tiếp với 50 điểm.
Vì sao đáng chú ý?
Đây là cú chỉnh lại cách ngành AI tự chấm điểm mình. Một benchmark công khai, dùng lâu ngày, rất dễ biến thành bài kiểm tra trí nhớ. Điểm cao khi đó đo khả năng mô hình nhận ra câu hỏi hơn là khả năng giải quyết công việc mới. Việc v5 dùng phần lớn dữ liệu riêng tư khiến điểm tuyệt đối của nhiều model giảm so với v4.3.2, đồng thời kéo tụt thứ hạng của vài model từng có hiệu năng tốt. Đó là tín hiệu lành mạnh, không phải “benchmark khó vô lý”.
Kết quả cũng dập tắt câu chuyện về một nhà vô địch toàn năng. Claude Opus 5.5 dẫn 3 trong 9 đánh giá, còn 6 đánh giá khác chia cho 5 model. Ở FrontierCode 2.0, Opus 5.5 đạt 46%, trong khi GPT-6 Astra, GPT-6.1 Terra và Claude Sonnet 5.5 cùng đạt 42%. Sang Terminal-Bench-Science, GPT-6 Astra dẫn với 63%, vượt Opus 5.5 ở 59%.
Khoảng cách cũng đang mở rộng: model open weights tốt nhất chỉ đạt 32 điểm, kém đầu bảng 12 điểm, so với chênh lệch 3 điểm trước đó. Đây là lời cảnh báo cho đội ngũ đang mặc định rằng “mã mở sẽ bắt kịp nhanh ở mọi tác vụ”.

Tác động thực chiến
Đội ngũ kỹ thuật cần dừng chọn LLM bằng một bảng xếp hạng tổng. Hãy chọn theo loại công việc, mức effort và ngân sách. Nếu AI Agent phải sửa code trong repo thật, FrontierCode 2.0 đáng xem hơn một điểm coding chung chung. Nếu agent chạy phân tích qua terminal, GPT-6 Astra đang có lợi thế rõ ràng với 63% trên Terminal-Bench-Science.
- Workflow code: ưu tiên thử Claude Opus 5.5, GPT-6 Astra, GPT-6.1 Terra và Claude Sonnet 5.5 trên issue, test suite, code review của chính công ty.
- Workflow nghiên cứu: kiểm tra khả năng chạy lệnh, đọc kết quả trung gian và phục hồi lỗi; đừng suy diễn từ bài toán hỏi-đáp.
- Kiểm soát chi phí: nhóm top 10 chênh hơn 13 lần chi phí mỗi tác vụ. GPT-6.1 Terra ở mức 0,96 USD/tác vụ, còn Claude Fable 5.1 là 13,04 USD/tác vụ.
Chiến lược hợp lý là routing: dùng model rẻ cho phân loại, trích xuất và bản nháp; chỉ đẩy tác vụ có rủi ro cao sang model frontier. Một agent “thông minh” nhưng gọi model đắt cho mọi bước sẽ chết vì unit economics trước khi kịp chứng minh giá trị.
Cường Nguyễn nhận định
Intelligence Index v5 đáng khen vì đã tấn công đúng căn bệnh khó chịu nhất của ngành: benchmark bị biến thành sân khấu marketing. Nhưng 58 điểm của model dẫn đầu cũng cần được đọc đúng: frontier model vẫn thất bại ở một phần lớn bài kiểm tra khó, kể cả khi đã chạy ở cấu hình max. Đừng lấy leaderboard làm giấy phép để trao quyền tự động hóa không kiểm soát cho AI Agent.
Tôi đánh giá Progress Index v1 còn quan trọng hơn một lần đổi ngôi ở top đầu. Ngành cần thấy tốc độ tiến bộ thật qua thời gian, thay vì liên tục đổi đề để tạo cảm giác mọi model đều nhảy vọt. Khuyến nghị cụ thể cho engineer và founder: hãy lập một private eval gồm 30-50 tác vụ lấy từ ticket, repo, tài liệu và lỗi sản phẩm đã được ẩn đáp án; chấm cả tỷ lệ hoàn thành, chi phí và số lần cần con người can thiệp trước khi ký hợp đồng hay đổi kiến trúc model.
Câu hỏi thường gặp
Vì sao benchmark riêng tư đáng tin hơn benchmark công khai?
Đáp án giữ kín làm giảm khả năng dữ liệu câu hỏi đã xuất hiện trong quá trình huấn luyện hoặc bị tối ưu trực tiếp. Nó không xóa hoàn toàn sai lệch, nhưng đo tốt hơn năng lực xử lý bài toán chưa gặp.
Model đứng đầu Intelligence Index v5 có phù hợp với mọi sản phẩm?
Không. Claude Opus 5.5 dẫn bảng tổng, nhưng GPT-6 Astra dẫn Terminal-Bench-Science và CritPt v2. Quyết định triển khai phải dựa trên loại tác vụ, latency, chi phí và yêu cầu kiểm soát lỗi của hệ thống.
Open weights có còn là lựa chọn tốt cho doanh nghiệp?
Có, nếu doanh nghiệp ưu tiên kiểm soát hạ tầng, dữ liệu hoặc chi phí ở tác vụ vừa phải. Tuy vậy, khoảng cách 12 điểm với model dẫn đầu cho thấy không nên giả định chúng thay thế được frontier model trong workflow agentic phức tạp.
Nguồn tham khảo: OfficeChai
Tác giả: Cường Nguyễn — Founder AI Ops Solutions | Verified n8n Creator. Kết nối: Facebook · LinkedIn · YouTube · TikTok
Bài viết là góc nhìn cá nhân của tác giả, mang tính tham khảo — không phải tin tức báo chí.
📬 Nhận bài viết mới — miễn phí
Đừng bỏ lỡ bài viết tiếp theo. Đăng ký để nhận trong inbox.
Tác giả
Cường Nguyễn — AI Thực Chiến
Tôi là Cường Nguyễn - Founder của AI Ops Solutions.
Tôi từng là Logistics Operations Manager và đồng sáng lập thương hiệu CATCA - #1 Shopee ngành Pet Care.
10 năm kinh nghiệm Logistics/E-commerce OperationsCo-founder CATCA - #1 Shopee ngành Pet CareMột trong 300+ n8n Verified Creator toàn cầuTư vấn Giải pháp chuyển đổi số bằng AI cho 3 SMEs/quý


