Bài viết
Bài viết cá nhân
Muse Glimmer 30B: Agent AI cục bộ đã đủ dùng
👤 cuongnguyen📅 15/08/2026⏱ 5 phút đọc
Tin chính là gì?
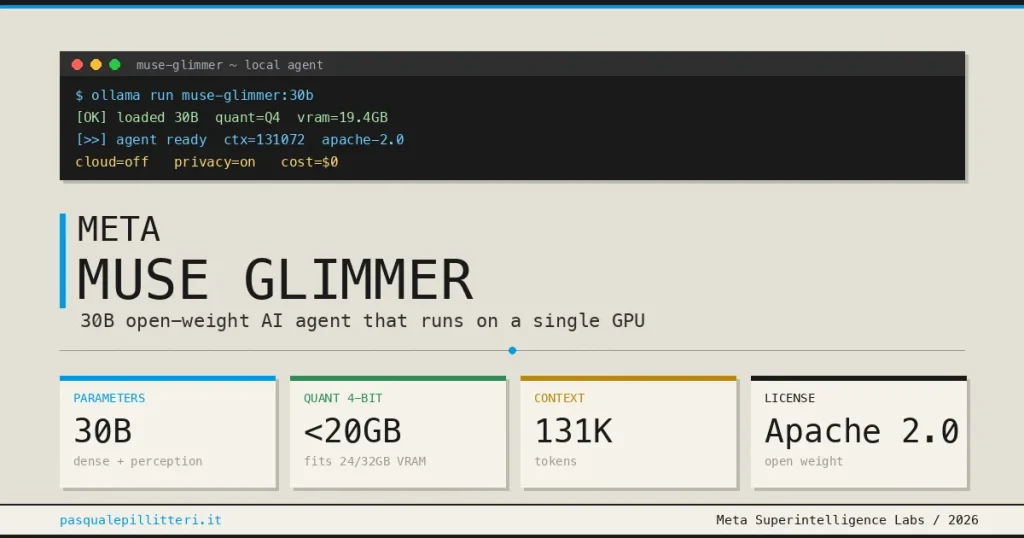
Theo thông tin phát hành trên Hugging Face, Meta vừa mở trọng số cho Muse Glimmer 30B, một mô hình AI Agent đa phương thức theo giấy phép Apache 2.0. Đây là bản distilled từ Muse Spark 1.2, mô hình đóng được Meta Superintelligence Labs phát hành ngày 5/8/2026.

Muse Glimmer có 30 tỷ tham số, cửa sổ ngữ cảnh 131.072 token và hỗ trợ hơn 100 ngôn ngữ. Điểm đáng tiền nằm ở perception encoder: mô hình có thể đọc văn bản, ảnh chụp màn hình, biểu đồ và tài liệu thay vì chỉ xử lý prompt chữ thuần túy.
Bản BF16 nặng 59,6 GB, nhưng bản lượng tử hóa 4-bit giảm xuống dưới 20 GB. Điều đó đưa model vào tầm chạy cục bộ trên một GPU consumer có 24GB hoặc 32GB VRAM, như RTX 4090, RTX 5090, hay máy Mac Apple Silicon dùng Unified Memory. Meta cũng kèm DFlash, mô hình drafter cho speculative decoding, để tăng tốc sinh nội dung tới 3 lần. Người dùng đã có đường triển khai qua Ollama 0.32.7 với GGUF và ExecuTorch cho CUDA hoặc Apple Silicon.
Vì sao đáng chú ý?
Thị trường LLM lâu nay bán một thói quen: dữ liệu đi lên cloud, token đi vào hóa đơn. Muse Glimmer đánh thẳng vào thói quen ấy. Một model 30B có năng lực coding, debug, DeepSearch QA và tool calling qua MCP mà chạy trên máy cá nhân sẽ làm yếu đi lợi thế của các API đóng ở nhóm tác vụ nội bộ.
Đây không phải tuyên bố rằng cloud AI sắp chết. Các model lớn nhất vẫn cần hạ tầng khổng lồ, còn vận hành local đòi hỏi người biết cài đặt, quantization và giám sát. Nhưng với nhóm việc cần dữ liệu kín, cloud-first là lựa chọn tiện hơn chứ không còn là lựa chọn mặc định.
Giấy phép Apache 2.0 mới là đòn chiến lược thật sự. Nó cho phép sửa đổi và thương mại hóa, mở đường cho các công ty xây AI Agent chuyên ngành mà không bị trói vào phí token hay điều khoản hạn chế của một nhà cung cấp model. Meta đang biến lớp model nền tảng thành hạ tầng phổ biến để đẩy cạnh tranh lên tầng ứng dụng, thiết bị và hệ sinh thái.
Tác động thực chiến
Với lập trình viên, Muse Glimmer phù hợp để đọc repository, refactor, hỗ trợ debug và gọi công cụ qua MCP ngay trên máy trạm. Mã nguồn, log lỗi, tài liệu kiến trúc hay tài liệu khách hàng không phải đi qua API bên thứ ba. Với ngân hàng và doanh nghiệp có dữ liệu nhạy cảm, đây là hướng triển khai đáng kiểm tra nghiêm túc: một AI Agent nội bộ có thể tra cứu tài liệu, hỗ trợ quy trình và làm LLM-as-a-judge mà giảm đáng kể rủi ro rò rỉ dữ liệu ra ngoài.
Chi phí cũng đổi bản chất. Thay vì hóa đơn biến động theo token, đội kỹ thuật đổi sang chi phí phần cứng, điện năng và vận hành. Điều này đặc biệt hợp lý khi workload lặp lại, khối lượng tài liệu lớn hoặc cần chạy liên tục. Ngược lại, đội ngũ ít năng lực hạ tầng sẽ không tự nhiên tiết kiệm tiền chỉ vì model mở: GPU, memory, monitoring và bảo mật endpoint vẫn phải trả giá.
Cần nhìn đúng giới hạn. Muse Glimmer được nhấn mạnh ở coding, document QA và tool calling; dữ liệu nghiên cứu cũng nêu hạn chế ở các tác vụ computer use phức tạp, nơi agent phải điều khiển chuột và giao diện màn hình nhiều bước. Đừng mua GPU chỉ để kỳ vọng một trợ lý tự vận hành mọi phần mềm như nhân viên thật.
Cường Nguyễn nhận định
Tôi đánh giá đây là nước đi rất mạnh của Meta, vì họ không chỉ ném thêm một model open-weight ra thị trường. Họ đưa cấu hình phần cứng phổ biến vào cuộc chơi AI Agent có năng lực làm việc thực tế. Mốc dưới 20 GB ở 4-bit khiến câu chuyện local AI rời khỏi phòng lab để đến máy trạm của lập trình viên và doanh nghiệp nhỏ.
Điểm tôi khen nhất là Apache 2.0. Một model mở nhưng bị hạn chế thương mại thường chỉ tạo tiếng vang cộng đồng; Apache 2.0 cho phép doanh nghiệp xây sản phẩm thật. Điểm cần chê là từ “agentic” rất dễ bị thổi phồng. Model biết gọi tool qua MCP không tự động biến thành quy trình đáng tin cậy. Agent tốt cần quyền truy cập tối thiểu, log đầy đủ, bộ đánh giá riêng và cơ chế con người phê duyệt ở các hành động rủi ro.
Khuyến nghị cụ thể: đội kỹ thuật Việt Nam nên dựng một pilot Ollama + Muse Glimmer trên máy có 24GB VRAM hoặc Mac Apple Silicon, chọn đúng một workflow kín như hỏi đáp tài liệu nội bộ hoặc review code, rồi đo chất lượng và thời gian xử lý trước khi tích hợp agent vào quy trình lớn. Đừng bắt đầu bằng chatbot chung chung; hãy bắt đầu bằng một công việc có dữ liệu riêng và tiêu chí thành công rõ ràng.
Câu hỏi thường gặp
Muse Glimmer 30B có dùng thương mại được không?
Có. Meta phát hành trọng số mở theo giấy phép Apache 2.0, một giấy phép cho phép sử dụng, sửa đổi và thương mại hóa. Doanh nghiệp vẫn cần tự kiểm tra yêu cầu bảo mật, tuân thủ và chất lượng đầu ra trước khi đưa vào vận hành.
Cần phần cứng nào để chạy Muse Glimmer cục bộ?
Bản BF16 có dung lượng 59,6 GB. Với quantization 4-bit, model dưới 20 GB và được định vị để chạy trên một GPU có 24GB hoặc 32GB VRAM, hay máy Mac Apple Silicon có Unified Memory phù hợp.
Muse Glimmer khác Muse Spark 1.2 ra sao?
Muse Glimmer là model 30B được distilled từ flagship đóng Muse Spark 1.2. Lợi thế của Glimmer là khả năng triển khai local và trọng số mở, còn Spark 1.2 là model đầu bảng mà Meta dùng làm nguồn chắt lọc.
Nguồn tham khảo: Meta ra mắt Muse Glimmer 30B: Agent AI chạy gọn trên 1 GPU
Bài viết là góc nhìn cá nhân của tác giả, mang tính tham khảo — không phải tin tức báo chí.
📬 Nhận bài viết mới — miễn phí
Đừng bỏ lỡ bài viết tiếp theo. Đăng ký để nhận trong inbox.

Tác giả
Cường Nguyễn — AI Thực Chiến
Tôi là Cường Nguyễn - Founder của AI Ops Solutions.
Tôi từng là Logistics Operations Manager và đồng sáng lập thương hiệu CATCA - #1 Shopee ngành Pet Care.
10 năm kinh nghiệm Logistics/E-commerce OperationsCo-founder CATCA - #1 Shopee ngành Pet CareMột trong 300+ n8n Verified Creator toàn cầuTư vấn Giải pháp chuyển đổi số bằng AI cho 3 SMEs/quý