Bài viết
Bài viết cá nhân
OpenAI đổi luật chơi AI: tốc độ và chi phí lên ngôi
👤 cuongnguyen📅 10/10/2026⏱ 6 phút đọc
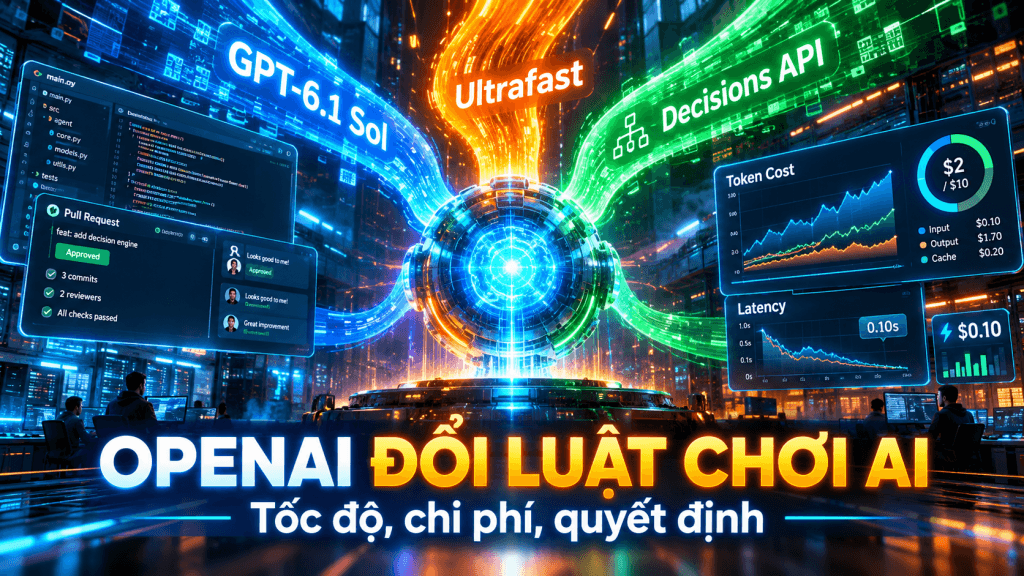
Theo phân tích của Forbes, OpenAI vừa tung ra một gói sản phẩm cho thấy cuộc đua AI đã rời xa câu hỏi “model nào thông minh nhất”. Tâm điểm là GPT-6.1 Sol, chế độ Ultrafast trong Codex và Decisions API chạy trên GPT-6 Luna. Thông điệp rất rõ: doanh nghiệp cần AI phản hồi nhanh, chi phí dự đoán được và đủ tốt cho từng quyết định cụ thể.
Tin chính là gì?
GPT-6.1 Sol được OpenAI định vị cho agentic coding và các tác vụ chuyên nghiệp, với năng lực gần mức GPT-6 Astra nhưng giá token tiêu chuẩn chỉ khoảng 1/5. Giá niêm yết là 2 USD/triệu token đầu vào và 10 USD/triệu token đầu ra, trong khi GPT-6 Astra là 10 USD và 50 USD.
Với các luồng công việc cần phản hồi tức thì, OpenAI bổ sung Ultrafast: tốc độ tạo token trong Codex nhanh hơn tới 8 lần so với Standard. Đổi lại, mức giá cao gấp 6 lần API chuẩn: 12 USD/triệu token input và 60 USD/triệu token output.
Mảnh ghép đáng chú ý nhất là Decisions API. API này nhận text và ảnh, rồi trả về dự đoán có cấu trúc như phân loại, điểm số hoặc ước lượng xác suất. OpenAI cho biết nó nhanh hơn tới 10 lần so với Responses API thông thường, có giá 0,10 USD/triệu token đầu vào và không tách phí token đầu ra.
Vì sao đáng chú ý?
OpenAI đang tách một thứ mà nhiều đội ngũ vẫn trộn lẫn: sinh nội dung và ra quyết định. Một AI Agent không cần model đắt tiền để trả lời mọi bước. Xác định ticket có cần escalation, chọn tool nào, chấm điểm pull request hay phát hiện webpage đổi nội dung là các bài toán dự đoán cấu trúc. Ép một LLM sinh văn bản dài xử lý chúng vừa chậm vừa đốt ngân sách.
Đây cũng là phản ứng trước áp lực giá. DeepSeek V4.1 Flash niêm yết 0,30 USD input và 1,20 USD output mỗi triệu token trong giờ cao điểm. Qwen3.8 Flash có giá từ 0,113 USD input và 0,382 USD output ở một số triển khai. Phía open-weight, Reflection AI đã công bố Beam: model MoE 501 tỷ tham số, kích hoạt 23 tỷ tham số mỗi request.
Cuộc chiến vì thế không còn là một bảng xếp hạng benchmark đơn lẻ. Nó là bài toán tối ưu đồng thời độ trễ, chi phí, tỷ lệ lỗi và mức kiểm soát hệ thống.

Tác động thực chiến
Đội kỹ thuật nên thiết kế agent theo kiến trúc định tuyến thay vì mặc định “một model xử lý tất cả”. Một pipeline hợp lý có thể gồm:
- Decisions API hoặc model rẻ cho phân loại, routing, chấm điểm rủi ro và chọn tool.
- GPT-6.1 Sol cho coding, tổng hợp thông tin và các bước cần lập luận nhiều vòng.
- Ultrafast chỉ cho điểm chạm nơi người dùng hoặc developer đang chờ trực tiếp.
- Batch hoặc background job cho tác vụ không nhạy độ trễ.
Dữ liệu thử nghiệm từ HubSpot đáng để tham khảo: trong Sidekick, Decisions API dùng cho phân loại pull request được OpenAI chia sẻ là nhanh hơn 6–15 lần, chi phí khoảng một nửa và false-positive bằng một nửa hệ thống agent hiện tại. Parallel Web Systems cũng báo cáo lọc webpage chất lượng thấp gần như hoàn hảo và đạt 88,8% area under precision-recall curve khi nhận diện thay đổi trang.
Nhưng đừng đọc các con số này như cam kết SLA. Đây là kết quả do nhà cung cấp hoặc đối tác chia sẻ. Production thực tế khác ở dữ liệu bẩn, retry, tool failure, context dài và chi phí quan sát hệ thống.
Cường Nguyễn nhận định
Đây là hướng đi đúng của OpenAI, nhưng cũng là lời cảnh tỉnh cho các startup đang khoe “AI Agent dùng model mạnh nhất”. Đó thường là dấu hiệu kiến trúc lười biếng. Lợi thế cạnh tranh không nằm ở việc mua nhiều token hơn đối thủ; nó nằm ở khả năng biết bước nào cần suy luận sâu, bước nào chỉ cần một quyết định xác suất rẻ và nhanh.
Tôi đánh giá Decisions API có giá trị thực dụng hơn nhiều màn trình diễn model mới, vì nó đánh thẳng vào chi phí vận hành agent. Tuy vậy, đội ngũ nào thay router hiện có bằng API mới chỉ vì tốc độ quảng cáo sẽ tự tạo rủi ro vendor lock-in và false-positive khó truy vết.
Khuyến nghị hành động: trong tuần này, hãy lập bảng cho ba luồng agent tốn tiền nhất: số lần gọi model, p95 latency, chi phí mỗi tác vụ hoàn tất và tỷ lệ lỗi nghiệp vụ. Sau đó tách riêng bước phân loại sang model rẻ hoặc Decisions API, chạy shadow mode trên dữ liệu thật và chỉ đưa vào production khi false-positive được đo rõ ràng.
Câu hỏi thường gặp
Ultrafast có đáng trả giá gấp 6 lần không?
Đáng khi đó là bước coding agent mà developer đang chờ để tiếp tục làm việc. Không đáng cho tác vụ batch chạy ban đêm hoặc quy trình không có người chờ, vì tốc độ tăng không chuyển hóa thành giá trị kinh doanh tương ứng.
Decisions API khác gì Responses API thông thường?
Decisions API trả về dự đoán có cấu trúc như nhãn phân loại, điểm số và xác suất; nó hợp với routing hay đánh giá điều kiện. OpenAI cho biết API này nhanh hơn tới 10 lần và giá 0,10 USD mỗi triệu token đầu vào. Responses API phù hợp hơn khi ứng dụng cần sinh nội dung hoặc hội thoại dài.
Vì sao phải theo dõi DeepSeek, Qwen và open-weight?
Vì mức giá của DeepSeek V4.1 Flash và Qwen3.8 Flash tạo áp lực trực tiếp lên biên lợi nhuận của mọi API đóng. Beam của Reflection AI cho thấy lựa chọn open-weight quy mô lớn cũng đang mở rộng. Ngay cả khi chưa phù hợp mọi tác vụ, chúng buộc đội ngũ phải benchmark thay vì mặc định chọn model đắt nhất.
Nguồn tham khảo: Forbes
Tác giả: Cường Nguyễn — Founder AI Ops Solutions | Verified n8n Creator. Kết nối: Facebook · LinkedIn · YouTube · TikTok
Bài viết là góc nhìn cá nhân của tác giả, mang tính tham khảo — không phải tin tức báo chí.
📬 Nhận bài viết mới — miễn phí
Đừng bỏ lỡ bài viết tiếp theo. Đăng ký để nhận trong inbox.
Tác giả
Cường Nguyễn — AI Thực Chiến
Tôi là Cường Nguyễn - Founder của AI Ops Solutions.
Tôi từng là Logistics Operations Manager và đồng sáng lập thương hiệu CATCA - #1 Shopee ngành Pet Care.
10 năm kinh nghiệm Logistics/E-commerce OperationsCo-founder CATCA - #1 Shopee ngành Pet CareMột trong 300+ n8n Verified Creator toàn cầuTư vấn Giải pháp chuyển đổi số bằng AI cho 3 SMEs/quý


