Bài viết
Bài viết cá nhân
RAG hay Fine-tuning: Khung quyết định AI doanh nghiệp
👤 cuongnguyen📅 11/08/2026⏱ 21 phút đọc
Trong bài viết này(36 mục)⌄
- Fine-tuning hay RAG: doanh nghiệp thực sự đang quyết định điều gì?
- Phân biệt bài toán đưa tri thức vào mô hình với bài toán thay đổi hành vi
- Vì sao chọn sai kiến trúc làm tăng chi phí dài hạn
- RAG và fine-tuning hoạt động như thế nào?
- RAG: truy xuất dữ liệu ngoài tại thời điểm truy vấn
- Fine-tuning: điều chỉnh trọng số bằng dữ liệu chuyên biệt
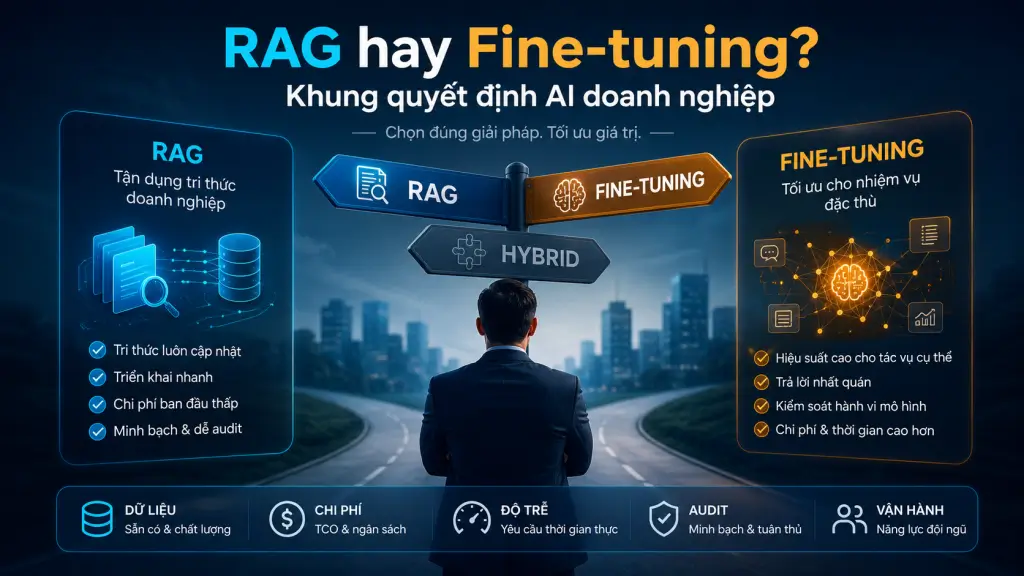
- So sánh RAG và fine-tuning trên các tiêu chí doanh nghiệp
- Độ mới của dữ liệu, khả năng cập nhật và độ chính xác sự kiện
- Khả năng truy xuất nguồn, audit và kiểm soát dữ liệu nhạy cảm
- Khi nào doanh nghiệp nên ưu tiên RAG?
- Dữ liệu thay đổi thường xuyên và cần câu trả lời có dẫn nguồn
- Kho tài liệu lớn, nhiều nguồn và hệ thống multi-tenant
- Khi nào fine-tuning là lựa chọn hợp lý?
- Chuẩn hóa giọng điệu, thuật ngữ và cấu trúc đầu ra
- Tác vụ ổn định, lưu lượng lớn và yêu cầu độ trễ thấp
- Prompt engineering đứng ở đâu trong quyết định kiến trúc?
- Khi prompt đủ để giải quyết yêu cầu về chỉ dẫn và định dạng
- Dấu hiệu cho thấy prompt đã đạt giới hạn
- So chi phí dài hạn: RAG có thực sự rẻ hơn fine-tuning?
- Cấu trúc chi phí của RAG
- Cấu trúc chi phí của fine-tuning
- Cách lập mô hình TCO theo lưu lượng và chu kỳ thay đổi
- Độ trễ, chất lượng và vận hành trong môi trường production
- Bộ chỉ số đánh giá cần đo
- Hybrid RAG + fine-tuning: lựa chọn thực tế cho doanh nghiệp trưởng thành
- Dùng RAG cho sự kiện và fine-tuning cho phong cách, hành vi
- Lộ trình từ RAG pilot đến fine-tuning có chọn lọc
- Khung ra quyết định và lộ trình triển khai 90 ngày
- Bộ câu hỏi quyết định theo dữ liệu, governance, latency và ngân sách
- Thiết kế pilot có nhóm đối chứng
- Phân công trách nhiệm giữa các đội ngũ
- Câu hỏi thường gặp
- RAG có tốt hơn fine-tuning trong mọi bài toán doanh nghiệp không?
- Doanh nghiệp nên fine-tune khi cần mô hình ghi nhớ tài liệu nội bộ hay không?
- Có thể bắt đầu bằng RAG rồi chuyển sang fine-tuning không?
- Chi phí nào thường bị bỏ sót khi so sánh RAG và fine-tuning?
Fine-tuning hay RAG: doanh nghiệp thực sự đang quyết định điều gì?
Cuộc tranh luận RAG hay fine-tuning thường bị rút gọn thành câu hỏi chọn một kỹ thuật “tốt hơn”. Đó là cách đặt vấn đề sai. Doanh nghiệp thực chất đang quyết định cách đưa tri thức vào ứng dụng AI, cách kiểm soát hành vi mô hình, và cách chịu trách nhiệm với câu trả lời được sinh ra trong môi trường production.
RAG phù hợp khi hệ thống cần tham chiếu dữ liệu bên ngoài tại thời điểm hỏi đáp; fine-tuning phù hợp khi tổ chức muốn điều chỉnh hành vi, giọng điệu, thuật ngữ hoặc cấu trúc đầu ra của mô hình. Một chatbot hỗ trợ khách hàng cần biết chính sách đổi trả mới nhất là bài toán tri thức cập nhật; một trợ lý luôn xuất JSON đúng schema là bài toán hành vi ổn định.
Phân biệt này đặc biệt quan trọng khi AI đã dịch chuyển từ thử nghiệm sang hạ tầng vận hành. Trong bối cảnh AI trở thành hạ tầng vận hành doanh nghiệp, quyết định kiến trúc không chỉ ảnh hưởng chất lượng demo mà còn chi phối chi phí dài hạn, khả năng kiểm toán và tốc độ thay đổi sản phẩm.
- Câu hỏi về tri thức: Dữ liệu cần dùng có thay đổi thường xuyên, phân tán hoặc cần dẫn nguồn hay không?
- Câu hỏi về hành vi: Mô hình có cần tuân thủ giọng thương hiệu, thuật ngữ ngành và định dạng đầu ra cố định hay không?
- Câu hỏi vận hành: Doanh nghiệp có đủ năng lực dữ liệu, ML Ops, đánh giá và giám sát để duy trì lựa chọn đó hay không?
Phân biệt bài toán đưa tri thức vào mô hình với bài toán thay đổi hành vi
Sai lầm phổ biến là fine-tune mô hình để “nhớ” toàn bộ tài liệu nội bộ. Khi tài liệu thay đổi, kiến thức đã nén vào trọng số mô hình nhanh chóng lỗi thời; khi cần giải thích câu trả lời đến từ đâu, hệ thống lại thiếu attribution. Ngược lại, dùng RAG để ép mô hình duy trì hàng trăm quy tắc định dạng có thể làm prompt dài, retrieval phức tạp và kết quả không nhất quán.
Điểm xuất phát hữu ích là lập bản đồ hai lớp. Lớp thứ nhất là sự thật có thể thay đổi: giá sản phẩm, tài liệu kỹ thuật, chính sách, hợp đồng, quy định và trạng thái đơn hàng. Lớp thứ hai là cách mô hình hành xử: ngôn ngữ, format, mức độ ngắn gọn, quy trình lập luận và cách gọi thực thể chuyên môn.
Vì sao chọn sai kiến trúc làm tăng chi phí dài hạn
Chọn sai không chỉ làm mô hình trả lời kém; nó tạo ra vòng lặp chi phí. Fine-tune cho dữ liệu biến động dẫn tới nhu cầu tái huấn luyện, kiểm thử phiên bản và quản lý rollback. Xây RAG cho yêu cầu chỉ cần prompt rõ ràng lại tạo thêm embedding, vector database, pipeline ingestion và điểm lỗi vận hành không cần thiết.
Nguyên tắc cốt lõi: dùng RAG để cung cấp sự thật cần cập nhật và dùng fine-tuning để định hình hành vi cần lặp lại. Không nên xem hai kỹ thuật là hai lựa chọn loại trừ nhau.
RAG và fine-tuning hoạt động như thế nào?
Để so sánh đúng RAG và fine-tuning, cần nhìn vào luồng xử lý thay vì chỉ nhìn câu trả lời cuối. RAG bổ sung ngữ cảnh cho mô hình mỗi khi có truy vấn, còn fine-tuning thay đổi cách mô hình phản hồi thông qua dữ liệu chuyên biệt trong quá trình huấn luyện.
RAG: truy xuất dữ liệu ngoài tại thời điểm truy vấn
Trong một pipeline Retrieval-Augmented Generation, truy vấn của người dùng được chuyển thành vector; hệ thống tìm các đoạn tài liệu liên quan trong vector database; sau đó các đoạn này được đưa vào prompt để mô hình sinh câu trả lời. Mô hình không cần được huấn luyện lại chỉ vì một chính sách hoặc tài liệu vừa thay đổi.
Điểm mạnh của RAG là có thể cập nhật tri thức bằng cách lập chỉ mục lại tài liệu, thay vì cập nhật trọng số. Hệ thống cũng có thể hiển thị nguồn tham chiếu cho câu trả lời, điều quan trọng với các luồng cần audit, kiểm tra pháp lý hoặc đối soát vận hành.
- Parsing: Trích xuất nội dung, cấu trúc và metadata từ PDF, web, CRM, wiki hoặc kho tài liệu.
- Chunking: Chia tài liệu thành các đoạn có kích thước và ngữ nghĩa phù hợp cho retrieval.
- Retrieval và ranking: Tìm, xếp hạng rồi đưa phần ngữ cảnh liên quan nhất vào mô hình.
Fine-tuning: điều chỉnh trọng số bằng dữ liệu chuyên biệt
Fine-tuning dùng tập dữ liệu đã làm sạch, thường có cấu trúc input-output hoặc nhãn, để điều chỉnh trọng số của mô hình. Đây là phương án phù hợp hơn cho các yêu cầu như giọng điệu thương hiệu, thuật ngữ chuyên ngành, JSON hoặc schema cố định, và một quy trình suy luận cần nhất quán.
Đổi lại, fine-tuning đòi hỏi chất lượng dữ liệu, quy trình đánh giá, chuyên môn ML và quản lý phiên bản mô hình. Doanh nghiệp không chỉ trả chi phí train; họ còn phải quản lý drift, A/B testing, tái huấn luyện và rủi ro dữ liệu huấn luyện không còn phản ánh thực tế.
So sánh RAG và fine-tuning trên các tiêu chí doanh nghiệp
Không có kiến trúc nào thắng trên mọi tiêu chí. RAG thường thắng về độ mới của dữ liệu và khả năng truy vết; fine-tuning thường có lợi thế khi cần hành vi ổn định và inference được tối ưu. Quyết định cần dựa trên đặc tính dữ liệu, không dựa trên sức hấp dẫn của một thuật ngữ kỹ thuật.
Độ mới của dữ liệu, khả năng cập nhật và độ chính xác sự kiện
Nếu tri thức thay đổi theo ngày, tuần hoặc theo các sự kiện vận hành, RAG là lựa chọn tự nhiên hơn. Cập nhật tài liệu và lập chỉ mục lại giúp hệ thống truy xuất phiên bản mới mà không phải tái huấn luyện. Tuy nhiên, RAG không tự động đúng: parsing kém, chunking sai, metadata thiếu hoặc retrieval lệch đều có thể đưa ngữ cảnh sai vào prompt.
Fine-tuning thích hợp với kiến thức và hành vi tương đối ổn định. Nhưng doanh nghiệp nên tránh dùng nó như một kho lưu trữ sự kiện. Mô hình có thể học được các mẫu từ dữ liệu, nhưng không cung cấp cơ chế mặc định để xác định nguồn tài liệu cụ thể hoặc đảm bảo một sự kiện đã được cập nhật.
Khả năng truy xuất nguồn, audit và kiểm soát dữ liệu nhạy cảm
Với ngành tài chính, pháp lý, y tế hoặc các quy trình nội bộ chịu kiểm soát, câu hỏi không dừng ở “mô hình trả lời đúng không” mà là “mô hình dựa vào đâu”. RAG tạo điều kiện gắn câu trả lời với tài liệu nguồn, metadata phiên bản và quyền truy cập. Điều này giúp đội ngũ kiểm tra evidence nhanh hơn.
Fine-tuning vẫn có vai trò trong các môi trường này, nhưng cần governance chặt chẽ đối với dữ liệu đưa vào train. Một mô hình đã fine-tune khó minh bạch hơn về từng nguồn sự kiện, trong khi RAG có thể áp dụng phân quyền retrieval theo người dùng hoặc tenant. Đây là khía cạnh liên quan trực tiếp tới chủ quyền dữ liệu và kiến trúc AI doanh nghiệp.
- Dữ liệu thay đổi nhanh: Ưu tiên RAG, quy trình index và kiểm thử retrieval.
- Quy tắc đầu ra lặp lại: Cân nhắc fine-tuning sau khi prompt đã được kiểm chứng.
- Yêu cầu nguồn chứng minh: Thiết kế RAG với citation, metadata và log truy xuất.
Khi nào doanh nghiệp nên ưu tiên RAG?
RAG là lựa chọn ưu tiên khi giá trị ứng dụng nằm ở việc dùng đúng dữ liệu doanh nghiệp tại thời điểm người dùng hỏi. Đây không đơn thuần là gắn chatbot vào một thư mục tài liệu; đó là bài toán thiết kế data pipeline, quyền truy cập, đánh giá retrieval và quan sát hệ thống.
Dữ liệu thay đổi thường xuyên và cần câu trả lời có dẫn nguồn
Các kho chính sách, catalog sản phẩm, hướng dẫn kỹ thuật, điều khoản hợp đồng, báo cáo vận hành và knowledge base đều là ứng viên RAG khi chúng liên tục thay đổi. Thay vì mong mô hình “ghi nhớ”, doanh nghiệp có thể buộc hệ thống trả lời dựa trên context đã truy xuất và đính kèm citation để người dùng kiểm chứng.
Ian Funnell, Data Engineering Advocate Lead tại Matillion, nhận định trong bài viết của hãng rằng RAG cung cấp cách nhanh và an toàn để kết nối dữ liệu doanh nghiệp với mô hình mạnh mà không phải huấn luyện lại. Đây là quan điểm của Funnell, không phải một thống kê độc lập; nhưng nó tóm tắt đúng lợi thế triển khai của RAG khi tri thức thường xuyên thay đổi.
“RAG gives you a fast, secure way to plug your enterprise data into powerful models without retraining them.” — Ian Funnell, Matillion.
Kho tài liệu lớn, nhiều nguồn và hệ thống multi-tenant
Contextual AI đưa ra ví dụ kho hỗ trợ kỹ thuật có 50.000 tài liệu sản phẩm. Trong tình huống này, fine-tune để đưa toàn bộ kho tài liệu vào mô hình không phải chiến lược hiệu quả; RAG chỉ truy xuất một số đoạn liên quan đến câu hỏi hiện tại. Đó là khác biệt giữa nén một kho kiến thức khổng lồ và tìm đúng bằng chứng khi cần.
RAG cũng phù hợp cho multi-tenant, nơi mỗi khách hàng chỉ được phép truy cập dữ liệu của mình. Retrieval có thể lọc theo tenant, vai trò, khu vực hoặc loại tài liệu trước khi ngữ cảnh đến mô hình. Tuy vậy, lớp phân quyền phải nằm trong pipeline dữ liệu, không thể chỉ kỳ vọng LLM tự tuân thủ quy tắc bảo mật.
- Knowledge base lớn: Chỉ truy xuất các chunk liên quan thay vì cố nhét toàn bộ tri thức vào trọng số.
- Nguồn dữ liệu đa dạng: Tập trung vào connector, chuẩn hóa metadata và đồng bộ thay đổi.
- Yêu cầu audit: Lưu truy vấn, tài liệu được truy xuất, phiên bản index và câu trả lời cuối.
Khi nào fine-tuning là lựa chọn hợp lý?
Fine-tuning không phải giải pháp lỗi thời trước RAG. Nó phù hợp khi doanh nghiệp đã hiểu rõ mẫu tác vụ lặp lại, có dữ liệu chất lượng và muốn mô hình thực hiện một cách phản hồi nhất quán. Giá trị của nó nằm ở chuẩn hóa hành vi, không nằm ở việc biến mô hình thành kho tài liệu tĩnh.
Chuẩn hóa giọng điệu, thuật ngữ và cấu trúc đầu ra
Một trợ lý viết nội dung cần bám sát giọng thương hiệu, một hệ thống xử lý hồ sơ cần xuất JSON hợp lệ, hoặc một copilot chuyên ngành cần dùng đúng thuật ngữ nội bộ là các tình huống phù hợp. Nếu prompt dài vẫn tạo ra lỗi format lặp lại, fine-tuning bằng các ví dụ đã được đánh giá có thể cải thiện tính nhất quán.
Điều kiện tiên quyết là dữ liệu không được chỉ “nhiều”, mà phải phản ánh đầu ra mong muốn. Tập dữ liệu huấn luyện cần được làm sạch, gắn nhãn và kiểm tra để tránh biến những lỗi cũ thành hành vi mặc định của mô hình. Đội ngũ cần duy trì benchmark để so sánh phiên bản mới với baseline trước khi phát hành.
Tác vụ ổn định, lưu lượng lớn và yêu cầu độ trễ thấp
Theo bảng so sánh của Matillion, RAG có độ trễ tham khảo khoảng 1–3 giây tùy kiến trúc retrieval, trong khi mô hình fine-tuned có thể phản hồi dưới một giây khi được tối ưu. Đây không phải cam kết hiệu năng cho mọi hệ thống; độ trễ thực tế còn phụ thuộc mô hình, hạ tầng, prompt, mạng, retrieval và lưu lượng.
Ở luồng có lưu lượng cao, một mô hình chuyên biệt có thể giúp giảm chi phí suy luận nếu nó thay thế được mô hình tổng quát lớn hơn. Nhưng lợi ích này chỉ có ý nghĩa sau khi doanh nghiệp tính đủ chi phí huấn luyện, vận hành ML Ops và chu kỳ tái huấn luyện. Không nên kết luận fine-tuning rẻ hơn chỉ từ latency.
- Đầu ra schema cố định: Fine-tuning phù hợp khi việc tuân thủ format là yêu cầu cốt lõi.
- Giọng thương hiệu: Mô hình có thể học phong cách phản hồi lặp lại từ tập ví dụ chất lượng.
- Luồng ổn định: Cần benchmark lưu lượng, chi phí inference và độ trễ trước khi đầu tư train.

Prompt engineering đứng ở đâu trong quyết định kiến trúc?
Trước khi xây RAG hoặc fine-tune, doanh nghiệp nên xem prompt engineering là baseline. Nhiều yêu cầu về vai trò, tone, cấu trúc đơn giản, few-shot examples và hướng dẫn an toàn có thể được xử lý bằng system prompt tốt. Điều này giúp tránh đầu tư hạ tầng trước khi hiểu chính xác vấn đề.
Khi prompt đủ để giải quyết yêu cầu về chỉ dẫn và định dạng
Prompt phù hợp khi thông tin cần thiết đã nằm trong hội thoại, quy tắc không quá dài, dữ liệu không cần cập nhật từ kho lớn và sai lệch định dạng có thể được kiểm tra ở lớp ứng dụng. Một validator JSON, schema validation hoặc hậu xử lý có thể giải quyết nhiều lỗi mà không cần fine-tuning ngay từ đầu.
Dấu hiệu cho thấy prompt đã đạt giới hạn
Prompt bắt đầu chạm giới hạn khi phải nhét quá nhiều tài liệu vào context, khi người dùng cần câu trả lời dựa vào dữ liệu mới nhất, hoặc khi mô hình liên tục không tuân thủ format dù chỉ dẫn đã rõ. Khi đó, hãy xác định lỗi thuộc về thiếu tri thức hay thiếu hành vi ổn định: lỗi đầu cần RAG, lỗi sau mới là ứng viên fine-tuning.
- Prompt trước: Xây baseline đơn giản với bộ câu hỏi đại diện và tiêu chí đánh giá rõ ràng.
- RAG khi thiếu sự thật: Dùng retrieval nếu câu trả lời phụ thuộc vào kho dữ liệu ngoài.
- Fine-tuning khi thiếu tính nhất quán: Chỉ train sau khi đã chứng minh prompt và validator không đủ.
So chi phí dài hạn: RAG có thực sự rẻ hơn fine-tuning?
Không có cơ sở để khẳng định RAG luôn rẻ hơn hoặc fine-tuning luôn đắt hơn. RAG thường có chi phí khởi đầu thấp hơn vì không cần train, nhưng phát sinh chi phí ingestion, embedding, vector storage, retrieval, reranking và bảo trì pipeline. Fine-tuning có chi phí đầu tư đầu kỳ lớn hơn, song có thể hợp lý ở các luồng ổn định và lưu lượng lớn.
Cấu trúc chi phí của RAG
Chi phí RAG bắt đầu từ kết nối và chuẩn hóa dữ liệu. Matillion mô tả nền tảng có hơn 100 connector, minh họa rằng RAG doanh nghiệp là bài toán tích hợp dữ liệu chứ không chỉ chọn LLM. Sau đó là chi phí embedding, lưu trữ vector, tìm kiếm, xếp hạng, quan sát pipeline và index lại khi tài liệu thay đổi.
Cấu trúc chi phí của fine-tuning
Fine-tuning yêu cầu dữ liệu đã làm sạch, compute để huấn luyện, năng lực ML Ops, quản lý phiên bản, A/B testing và tái huấn luyện. Chi phí nhân sự và đánh giá thường bị xem nhẹ, dù chúng quyết định mô hình có thực sự an toàn để triển khai hay không. Một bộ dữ liệu sai hoặc benchmark nghèo có thể biến chi phí train thành nợ kỹ thuật.
Cách lập mô hình TCO theo lưu lượng và chu kỳ thay đổi
Thay vì dự báo bằng một con số tổng quát, doanh nghiệp nên lập mô hình TCO theo từng use case. Tách chi phí triển khai ban đầu, dữ liệu, inference, lưu trữ, retrieval, nhân sự, đánh giá, bảo trì, tái huấn luyện và rủi ro từ câu trả lời không thể kiểm chứng. Vì các nguồn nghiên cứu được tham chiếu không cung cấp case study ROI được kiểm toán độc lập, mọi business case cần dựa trên dữ liệu vận hành nội bộ.
- Đầu vào TCO: Lưu lượng truy vấn, số nguồn dữ liệu, chu kỳ cập nhật, yêu cầu latency và mức rủi ro.
- RAG: Đo embedding, index, storage, retrieval, reranking, LLM context và chi phí observability.
- Fine-tuning: Đo chuẩn bị dữ liệu, train, đánh giá, deployment, versioning, rollback và retraining.
Chi phí đúng không phải chi phí demo thấp nhất; đó là tổng chi phí để hệ thống duy trì chất lượng, cập nhật và kiểm soát trong toàn bộ vòng đời.
Độ trễ, chất lượng và vận hành trong môi trường production
RAG là pipeline nhiều bước nên độ trễ không chỉ nằm ở LLM. Nó bao gồm tạo embedding cho query, tìm vector, áp dụng filter quyền truy cập, reranking, dựng context và generation. Fine-tuning có thể đơn giản hơn ở thời điểm inference, nhưng vẫn cần giám sát chất lượng và quản trị phiên bản sau phát hành.
Bộ chỉ số đánh giá cần đo
Với RAG, đội ngũ nên đánh giá retrieval có tìm đúng đoạn tài liệu không, câu trả lời có liên quan không và citation có thực sự hỗ trợ kết luận không. Với fine-tuning, cần đánh giá độ tuân thủ schema, thuật ngữ, tone và tỷ lệ lỗi trên các tập dữ liệu chưa thấy. Cả hai đều cần theo dõi answer relevance, attribution, lỗi an toàn và drift.
Đánh giá không nên chỉ thực hiện trước khi go-live. Dữ liệu nguồn thay đổi, hành vi người dùng đổi và mô hình nền tảng có thể được nâng cấp. Một hệ thống production cần logging có chủ đích để truy ngược từ câu trả lời về prompt, tài liệu truy xuất, cấu hình pipeline hoặc phiên bản mô hình.
- Retrieval accuracy: Đo khả năng hệ thống tìm được bằng chứng phù hợp cho truy vấn.
- Answer relevance: Đo mức câu trả lời đáp ứng đúng ý định người dùng.
- Attribution: Kiểm tra nguồn dẫn có liên quan, đủ ngữ cảnh và không bị gán sai.
- Drift: Theo dõi suy giảm chất lượng do dữ liệu, tác vụ hoặc mô hình thay đổi.
Hybrid RAG + fine-tuning: lựa chọn thực tế cho doanh nghiệp trưởng thành
Kiến trúc trưởng thành thường là hybrid: RAG cung cấp sự thật mới nhất, còn fine-tuning hoặc các cơ chế kiểm soát đầu ra định hình cách mô hình sử dụng sự thật đó. Cách tiếp cận này tránh việc nhét tri thức biến động vào trọng số, đồng thời giảm sự phụ thuộc vào những prompt dài và mong manh cho các hành vi lặp lại.
Dùng RAG cho sự kiện và fine-tuning cho phong cách, hành vi
Ví dụ, trợ lý hỗ trợ khách hàng có thể dùng RAG để lấy chính sách bảo hành và thông số sản phẩm mới nhất; phần fine-tuning được dùng để bảo đảm giọng trả lời, cách phân loại yêu cầu và JSON trả về cho CRM luôn nhất quán. Với phân tích tài liệu pháp lý, RAG truy xuất điều khoản liên quan, trong khi lớp hành vi hướng dẫn mô hình không kết luận vượt quá bằng chứng và luôn nêu nguồn tham chiếu.
Lộ trình từ RAG pilot đến fine-tuning có chọn lọc
Databricks khuyến nghị một hướng đi thực dụng: bắt đầu bằng RAG để kiểm chứng giá trị và thu thập truy vấn thực tế, sau đó fine-tune có chọn lọc cho luồng có lưu lượng cao, latency quan trọng hoặc yêu cầu định dạng ổn định. Dữ liệu từ pilot là đầu vào tốt hơn cho fine-tuning vì nó phản ánh tình huống thật, không chỉ là giả định của nhóm dự án.
- Giai đoạn pilot: Xây RAG hẹp, có nguồn dữ liệu xác định và bộ câu hỏi đánh giá đại diện.
- Giai đoạn quan sát: Phân loại lỗi retrieval, lỗi hành vi, lỗi dữ liệu và yêu cầu chưa rõ.
- Giai đoạn tối ưu: Fine-tune hoặc thêm validator cho các pattern ổn định, có giá trị cao.
Khung ra quyết định và lộ trình triển khai 90 ngày
Một lộ trình 90 ngày không phải lời hứa rằng mọi doanh nghiệp sẽ production hóa hoàn toàn trong thời gian đó. Nó là cách chia nhỏ rủi ro: xác định use case, kiểm kê dữ liệu, xây baseline, đánh giá có đối chứng và quyết định mở rộng dựa trên bằng chứng. Trọng tâm phải là độ tin cậy và khả năng vận hành, không phải số lượng tính năng demo.
Bộ câu hỏi quyết định theo dữ liệu, governance, latency và ngân sách
Hãy hỏi: dữ liệu đổi với tần suất nào; người dùng có cần xem nguồn không; dữ liệu có cần phân quyền theo tenant không; output có schema bắt buộc không; độ trễ mục tiêu là gì; đội ngũ có năng lực data engineering và ML Ops đến đâu. Câu trả lời sẽ cho biết doanh nghiệp cần RAG, fine-tuning, prompt cải tiến hay hybrid.
Thiết kế pilot có nhóm đối chứng
Pilot nên chọn một luồng giới hạn, chẳng hạn hỏi đáp trên một kho tài liệu đã được quản trị, và thiết lập baseline prompt-only. Sau đó so sánh với RAG trên cùng tập câu hỏi, đo retrieval, relevance, attribution, latency và chi phí. Nếu fine-tuning được thử nghiệm, cần đánh giá trên tập test tách biệt và có tiêu chí dừng, rollback hoặc mở rộng rõ ràng.
Phân công trách nhiệm giữa các đội ngũ
Data engineering chịu trách nhiệm ingestion, chất lượng dữ liệu, metadata và đồng bộ nguồn. ML engineering chịu trách nhiệm mô hình, evaluation, fine-tuning và guardrail. DevOps chịu trách nhiệm triển khai, quan sát, quyền truy cập, độ tin cậy và tối ưu hạ tầng. Khi ba lớp này tách rời, RAG dễ trở thành chatbot không có dữ liệu sạch; fine-tuning dễ trở thành model không thể duy trì.
- Ngày 1–30: Chọn use case, kiểm kê nguồn, thiết kế benchmark và baseline prompt-only.
- Ngày 31–60: Xây RAG pilot, cấu hình metadata, quyền truy cập, logging và đánh giá retrieval.
- Ngày 61–90: So sánh chất lượng, chi phí, latency; quyết định tối ưu retrieval, fine-tune chọn lọc hoặc mở rộng.
Câu hỏi thường gặp
RAG có tốt hơn fine-tuning trong mọi bài toán doanh nghiệp không?
Không. RAG tốt hơn khi cần tri thức mới, dữ liệu lớn, citation và audit. Fine-tuning phù hợp hơn khi cần hành vi ổn định như tone thương hiệu, thuật ngữ chuyên môn hoặc schema đầu ra. Nhiều ứng dụng tốt nhất dùng hybrid: RAG cho dữ liệu và fine-tuning cho hành vi.
Doanh nghiệp nên fine-tune khi cần mô hình ghi nhớ tài liệu nội bộ hay không?
Thông thường không nên fine-tune chỉ để mô hình ghi nhớ hàng loạt tài liệu nội bộ, đặc biệt khi tài liệu thay đổi. Cách này làm kiến thức trở nên lỗi thời và khó truy vết nguồn. RAG phù hợp hơn vì có thể cập nhật index và đưa đúng tài liệu liên quan vào context tại thời điểm truy vấn.
Có thể bắt đầu bằng RAG rồi chuyển sang fine-tuning không?
Có, và đây là lộ trình thực dụng. Bắt đầu với RAG pilot giúp doanh nghiệp kiểm chứng giá trị, hiểu truy vấn thật và thu thập dữ liệu lỗi. Sau đó, các luồng ổn định có lưu lượng cao, cần latency thấp hoặc cần format nghiêm ngặt có thể được fine-tune có chọn lọc.
Chi phí nào thường bị bỏ sót khi so sánh RAG và fine-tuning?
Với RAG, các khoản thường bị quên là làm sạch dữ liệu, embedding, vector database, index lại, reranking, observability và kiểm thử retrieval. Với fine-tuning, các khoản hay bị bỏ sót là gắn nhãn dữ liệu, đánh giá, phiên bản mô hình, A/B testing, rollback, nhân sự ML Ops và tái huấn luyện khi yêu cầu thay đổi.
Nguồn tham khảo: Fine-tuning hay RAG? Khung quyết định và bài toán chi phí dài hạn cho doanh nghiệp
Bài viết là góc nhìn cá nhân của tác giả, mang tính tham khảo — không phải tin tức báo chí.
📬 Nhận bài viết mới — miễn phí
Đừng bỏ lỡ bài viết tiếp theo. Đăng ký để nhận trong inbox.

Tác giả
Cường Nguyễn — AI Thực Chiến
Tôi là Cường Nguyễn - Founder của AI Ops Solutions.
Tôi từng là Logistics Operations Manager và đồng sáng lập thương hiệu CATCA - #1 Shopee ngành Pet Care.
10 năm kinh nghiệm Logistics/E-commerce OperationsCo-founder CATCA - #1 Shopee ngành Pet CareMột trong 300+ n8n Verified Creator toàn cầuTư vấn Giải pháp chuyển đổi số bằng AI cho 3 SMEs/quý


