Bài viết
Bài viết cá nhân
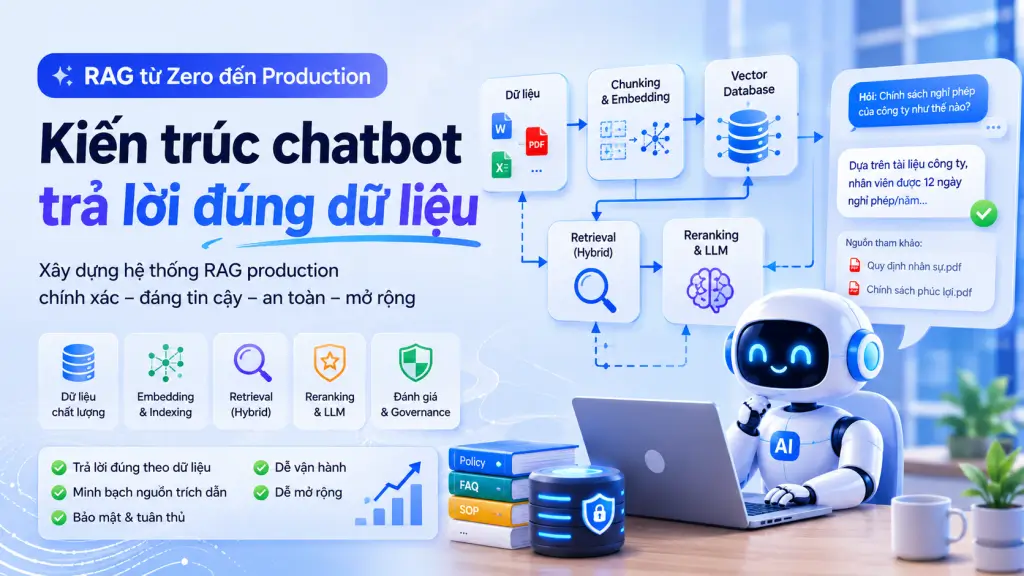
RAG từ Zero đến Production: Kiến trúc chatbot trả lời đúng dữ liệu
👤 cuongnguyen📅 11/08/2026⏱ 18 phút đọc
Trong bài viết này(26 mục)⌄
- RAG là gì và vì sao chatbot doanh nghiệp trả lời sai?
- RAG architecture: từ câu hỏi người dùng đến câu trả lời có citation
- Phân biệt lỗi retrieval, lỗi context và lỗi generation
- Thiết kế bài toán và dữ liệu trước khi chọn công nghệ
- Xây metadata như một hợp đồng dữ liệu
- Hai pipeline cốt lõi: indexing offline và query online
- Indexing pipeline: ingest, parse, chunk, embed và lưu trữ
- Query pipeline: rewrite, retrieve, rerank, assemble và generate
- Chunking: khâu quyết định chất lượng truy xuất
- Fixed-size, sentence-aware và recursive chunking
- Semantic, hierarchical và small-to-large chunking
- Embedding: biến dữ liệu doanh nghiệp thành không gian tìm kiếm
- Embedding consistency, versioning và kế hoạch re-index
- Vector database: chọn pgvector, Pinecone, Qdrant, Weaviate hay Milvus?
- Hybrid retrieval và reranking: từ tìm được đến tìm đúng
- BM25, dense retrieval, RRF, cross-encoder và MMR
- Context assembly và cơ chế chống hallucination
- Đánh giá RAG trước và sau khi đưa vào production
- Bảo mật, multi-tenancy và governance cho dữ liệu doanh nghiệp
- Lộ trình triển khai RAG từ Zero đến Production
- Câu hỏi thường gặp
- RAG có luôn chính xác hơn fine-tuning không và khi nào nên kết hợp cả hai?
- Nên chọn chunk size và overlap bao nhiêu cho tài liệu tiếng Việt?
- Khi nào doanh nghiệp cần hybrid search và reranking?
- pgvector có đủ cho chatbot nội bộ hay phải dùng Pinecone, Qdrant hoặc Weaviate?
- Làm gì khi chatbot không tìm thấy dữ liệu hoặc trả lời ngoài phạm vi?
RAG là gì và vì sao chatbot doanh nghiệp trả lời sai?
RAG, viết tắt của Retrieval-Augmented Generation, là kiến trúc cho phép chatbot truy xuất thông tin từ kho tri thức doanh nghiệp trước khi gửi ngữ cảnh cho mô hình ngôn ngữ lớn tạo câu trả lời. Thay vì yêu cầu LLM “nhớ” mọi chính sách, hướng dẫn kỹ thuật, quy định nội bộ hoặc tài liệu sản phẩm, RAG biến dữ liệu hiện hành thành bằng chứng có thể tìm kiếm, lọc và trích dẫn.
Điểm khác biệt lớn nhất giữa một prototype RAG và một hệ thống production RAG không nằm ở một lệnh gọi API LLM. Nó nằm ở chất lượng dữ liệu nguồn, chiến lược chunking, mô hình embedding, khả năng retrieval, reranking, kiểm soát quyền truy cập, đánh giá và observability. Nếu một khâu sai, chatbot vẫn có thể đưa ra câu trả lời nghe mạch lạc nhưng không có cơ sở trong tài liệu doanh nghiệp.
- Lỗi retrieval: Hệ thống không tìm được tài liệu liên quan, hoặc bỏ sót đúng đoạn chứa câu trả lời.
- Lỗi context: Đoạn đúng đã được tìm thấy nhưng bị cắt sai, xếp sai thứ tự hoặc bị chôn giữa một context quá dài.
- Lỗi generation: Mô hình diễn giải quá mức, suy luận ngoài bằng chứng hoặc tạo claim không tồn tại trong context.
Nguyên tắc cốt lõi: chatbot doanh nghiệp không cần cố trả lời mọi câu hỏi; nó cần biết lúc nào có đủ bằng chứng truy xuất để trả lời và lúc nào phải fallback.
RAG architecture: từ câu hỏi người dùng đến câu trả lời có citation
Một luồng RAG trưởng thành thường bắt đầu bằng query rewrite để làm rõ ý định, sau đó chạy hybrid retrieval trên vector index và keyword index. Các ứng viên được rerank, ghép thành context có tiêu đề, ngày cập nhật và nguồn; cuối cùng LLM tạo câu trả lời kèm citation. Citation không chỉ là phần giao diện: nó là cơ chế buộc hệ thống gắn từng kết luận với tài liệu có thể kiểm chứng.
Phân biệt lỗi retrieval, lỗi context và lỗi generation
Khi người dùng báo chatbot sai, đội ngũ không nên mặc định thay model hoặc viết prompt dài hơn. Hãy kiểm tra theo chuỗi: tài liệu có tồn tại hay không, chunk đúng có vào top-k không, reranker có đẩy nó xuống không, context có còn đủ nghĩa không và câu trả lời có bám sát nguồn được cung cấp không. Chẩn đoán theo tầng giúp tránh tối ưu nhầm vị trí.
- Không có tài liệu: Trả lời từ chối có hướng dẫn hoặc chuyển tuyến người phụ trách.
- Có tài liệu nhưng không tìm thấy: Xem lại metadata, embedding, chunking và hybrid retrieval.
- Tìm thấy nhưng trả lời sai: Kiểm tra context assembly, prompt grounding và citation enforcement.
Thiết kế bài toán và dữ liệu trước khi chọn công nghệ
Một dự án RAG production nên bắt đầu bằng câu hỏi nghiệp vụ thay vì danh sách công cụ. Doanh nghiệp cần xác định chatbot trả lời cho ai, thuộc phạm vi nào, được phép dùng nguồn nào và thế nào là một câu trả lời đúng dữ liệu. Các use case như tra cứu chính sách nhân sự, hướng dẫn kỹ thuật, hỗ trợ sản phẩm và tìm kiếm tri thức nội bộ có mức rủi ro, độ mới dữ liệu và yêu cầu quyền truy cập khác nhau.
Trước khi ingest, tài liệu phải được làm sạch để loại menu, header, footer, số trang, boilerplate, disclaimer lặp lại và lỗi mã hóa. Những thành phần này tưởng như vô hại nhưng có thể làm nhiễu embedding, tạo chunk không có giá trị và khiến retriever trả về các đoạn lặp. Chất lượng đầu vào là nền tảng của chất lượng retrieval và faithfulness ở đầu ra.
- Phạm vi câu hỏi: Xác định chủ đề in-scope, nhóm người dùng, ngôn ngữ và điều kiện cần fallback.
- Nguồn dữ liệu: Liệt kê wiki, PDF, cơ sở tri thức, ticket, tài liệu kỹ thuật và hệ thống có quyền truy cập.
- Tiêu chí thành công: Định nghĩa retrieval hit rate, mức groundedness, latency và chất lượng citation.
Xây metadata như một hợp đồng dữ liệu
Mỗi chunk nên mang theo document ID, tiêu đề, nguồn, tác giả, ngày cập nhật, danh mục, tenant ID và thông tin quyền truy cập. Metadata không phải chi tiết phụ trợ; nó là điều kiện để lọc theo thời gian, chủ đề và quyền người dùng ngay tại thời điểm truy vấn. Không thể vá access control đáng tin cậy chỉ ở bước prompt sau khi dữ liệu đã được retrieve.

Hai pipeline cốt lõi: indexing offline và query online
Kiến trúc đáng tin cậy tách indexing pipeline và query pipeline. Pipeline offline chịu trách nhiệm biến dữ liệu thô thành chỉ mục có thể truy xuất; pipeline online tối ưu việc trả lời câu hỏi trong giới hạn latency. Tách hai luồng giúp đội ngũ thay đổi chunking, embedding hoặc quy tắc làm sạch mà không biến mỗi truy vấn thành một tác vụ xử lý tài liệu nặng.
Indexing pipeline: ingest, parse, chunk, embed và lưu trữ
Luồng offline thường gồm ingest, parse định dạng, làm sạch, chuẩn hóa, gắn metadata, chunking, tạo embedding và ghi vào vector database. Mỗi lần index cần lưu phiên bản parser, chunking strategy, embedding model và timestamp. Khi thay đổi mô hình embedding, doanh nghiệp cần re-index toàn bộ corpus; trộn vector từ nhiều không gian biểu diễn sẽ khiến ranking thiếu nhất quán.
- Ingest có kiểm soát: Ghi nhận nguồn, thời điểm lấy dữ liệu và trạng thái xử lý của từng tài liệu.
- Idempotency: Có thể chạy lại pipeline mà không tạo bản sao chunk hoặc vector trùng lặp.
- Freshness: Tài liệu động có thể cần refresh hàng ngày, còn use case real-time có thể cần cập nhật hàng giờ.
Query pipeline: rewrite, retrieve, rerank, assemble và generate
Luồng online nhận câu hỏi, xác định ngữ cảnh người dùng, áp metadata filter, thực hiện dense retrieval kết hợp BM25, rồi hợp nhất kết quả. Một cấu hình thực tế có thể lấy top 20 ứng viên từ hybrid retrieval, dùng cross-encoder rerank và rút xuống top 5 chunk cho generation. Sau đó context được sắp xếp để LLM ưu tiên bằng chứng quan trọng và xuất citation.
Chunking: khâu quyết định chất lượng truy xuất
Chunking là quyết định có tính hệ thống vì chunk quá nhỏ dễ mất điều kiện và ngữ nghĩa, còn chunk quá lớn làm retrieval kém chính xác và tốn context. Không tồn tại một cấu hình đúng cho mọi corpus. Một số hệ thống production sử dụng khoảng 400–512 token với overlap 10–20%, trong khi một pipeline khác dùng khoảng 2.800 ký tự và overlap 350 ký tự. Đây là điểm xuất phát để kiểm thử, không phải chuẩn cố định.
Fixed-size, sentence-aware và recursive chunking
Fixed-size chunking dễ triển khai nhưng có nguy cơ cắt giữa bảng, câu hoặc quy trình. Sentence-aware chunking giữ ranh giới câu, còn recursive chunking cố gắng chia theo heading, đoạn, câu và ký tự theo thứ tự ưu tiên. Với tài liệu tiếng Việt, cần đặc biệt kiểm tra heading, danh sách, bảng biểu và các cụm thuật ngữ vì chúng thường mang điều kiện quan trọng của chính sách hoặc hướng dẫn.
- Fixed-size: Phù hợp làm baseline nhanh nhưng cần quan sát tình trạng cắt nghĩa.
- Recursive: Hợp lý cho tài liệu có cấu trúc heading và đoạn rõ ràng.
- Page-level: Hữu ích khi ngữ nghĩa bám chặt theo trang, nhưng có thể quá lớn cho retrieval.
Semantic, hierarchical và small-to-large chunking
Semantic chunking chia tại điểm chuyển chủ đề thay vì dựa hoàn toàn vào độ dài. Hierarchical chunking bảo tồn quan hệ giữa tài liệu, mục và đoạn. Chiến lược small-to-large đặc biệt đáng chú ý: dùng chunk nhỏ khoảng 300–500 ký tự để truy xuất chính xác, nhưng trả về chunk cha khoảng 2.000–3.000 ký tự cho LLM để giữ đủ ngữ cảnh. Cách này giải quyết trực tiếp đánh đổi giữa recall cấp đoạn và khả năng giải thích ở cấp phần.
Không đoán chunk size: hãy kiểm thử trên câu hỏi thật, tài liệu thật và tiêu chí retrieval thật của doanh nghiệp.
Embedding: biến dữ liệu doanh nghiệp thành không gian tìm kiếm
Embedding quyết định cách câu hỏi và tài liệu được biểu diễn trong không gian vector. Một model có thể mạnh ở tiếng Anh nhưng chưa chắc phù hợp với corpus tiếng Việt, tài liệu pháp lý, tài chính hoặc thuật ngữ kỹ thuật. Vì vậy, chọn embedding model là bài toán benchmark nội bộ dựa trên câu hỏi đại diện, không phải chỉ dựa vào bảng xếp hạng công khai.
Ví dụ, text-embedding-3-large có 3.072 chiều, còn text-embedding-3-small có 1.536 chiều. Trong case study nội bộ MyQRGuide của Nexios với 200 câu hỏi, việc chuyển từ text-embedding-ada-002 sang text-embedding-3-large nâng tỷ lệ relevant source trong top 5 từ 61% lên 83%. Đây là kết quả của một pipeline cụ thể, không phải benchmark phổ quát cho mọi doanh nghiệp.
- Ngôn ngữ và domain: Đo trực tiếp hiệu quả trên tài liệu và truy vấn của tổ chức.
- Dimension và lưu trữ: Vector nhiều chiều có thể tăng chi phí index, RAM và truy vấn.
- Phiên bản model: Lưu embedding model version với từng vector để kiểm soát re-index.
Embedding consistency, versioning và kế hoạch re-index
Khi đổi embedding model, toàn bộ corpus cần được nhúng lại để đảm bảo embedding consistency. Đội ngũ cần quản lý index version, kế hoạch backfill, kiểm thử song song và rollback. Một số báo cáo nêu Voyage-3-large có kết quả tốt hơn các model khác trên miền được đánh giá, nhưng mọi chênh lệch về độ chính xác và chi phí cần được xác minh bằng corpus riêng trước khi đưa thành quyết định kiến trúc.
Vector database: chọn pgvector, Pinecone, Qdrant, Weaviate hay Milvus?
Không có vector database tốt nhất tuyệt đối. Lựa chọn phụ thuộc vào quy mô vector, độ phức tạp của metadata filtering, yêu cầu data residency, năng lực vận hành và ngân sách. pgvector phù hợp khi đội ngũ đã vận hành PostgreSQL; Pinecone phù hợp với nhu cầu managed và giảm zero-ops; Qdrant nổi bật ở filtering cùng sparse+dense retrieval; Weaviate hỗ trợ hybrid và multi-modal; Milvus thường được cân nhắc cho quy mô rất lớn.
- pgvector: Phù hợp với hệ sinh thái PostgreSQL và use case chatbot nội bộ có quy mô phù hợp.
- Pinecone: Giảm gánh nặng vận hành cho đội ngũ ưu tiên dịch vụ managed.
- Qdrant và Weaviate: Đáng cân nhắc khi hybrid search, payload filtering hoặc multi-modal là yêu cầu trọng tâm.
- Milvus: Phù hợp để đánh giá cho triển khai có tham vọng quy mô hàng tỷ vector.
Các con số về scale, latency và giá luôn phụ thuộc vào cấu hình, loại index, region, metadata filter, số replica và thời điểm đánh giá. Vì vậy, doanh nghiệp nên chạy benchmark với query distribution thực tế, không coi thông số marketing là cam kết hiệu năng.
Hybrid retrieval và reranking: từ tìm được đến tìm đúng
Pure vector search có thể hiểu tốt ý nghĩa gần nhau nhưng dễ bỏ sót mã sản phẩm, tên riêng, acronym, thuật ngữ hiếm và truy vấn exact-match. Hybrid retrieval kết hợp dense vector với BM25 để tận dụng semantic similarity lẫn keyword matching. Đây là lớp quan trọng với chatbot doanh nghiệp vì dữ liệu thường chứa SKU, mã lỗi, phiên bản phần mềm, số hợp đồng và tên quy trình.
DataStorage báo cáo hybrid retrieval đạt MRR 66,4% so với 56,7% của semantic-only trong bối cảnh được nguồn đánh giá. Nexios cũng ghi nhận hybrid retrieval cải thiện recall@5 khoảng 15 điểm phần trăm so với vector-only trong pipeline của họ. Hai kết quả xuất phát từ bối cảnh khác nhau, vì thế không nên gộp thành một benchmark chung hoặc dùng để hứa hẹn hiệu quả cho mọi corpus.
BM25, dense retrieval, RRF, cross-encoder và MMR
Một pipeline thường chạy BM25 và dense retrieval song song, rồi dùng Reciprocal Rank Fusion để hợp nhất theo thứ hạng; một giá trị k phổ biến được nêu là 60. Sau đó reranker cross-encoder đánh giá trực tiếp cặp query-document để tối ưu precision. Các nguồn cho biết reranking có thể cải thiện precision khoảng 10–30% nhưng có thể thêm 50–100 ms cho 50 candidates.
- Hybrid retrieval: Tối ưu recall, tức tăng khả năng đoạn đúng xuất hiện trong tập ứng viên.
- Cross-encoder reranking: Tối ưu precision, tức đưa đoạn phù hợp nhất lên đầu danh sách.
- MMR: Giảm các chunk gần như trùng lặp để context đa dạng hơn.
Context assembly và cơ chế chống hallucination
RAG không tự động loại bỏ hallucination nếu context nghèo, quá dài hoặc lẫn nhiều đoạn mâu thuẫn. Hiện tượng lost in the middle cho thấy mô hình có thể sử dụng thông tin nằm giữa context kém hiệu quả hơn phần đầu và phần cuối. Context assembly cần ưu tiên bằng chứng mạnh, giảm trùng lặp, giữ tiêu đề và ngày cập nhật, đồng thời tôn trọng giới hạn context của LLM.
Hệ thống nên có confidence threshold và fallback thay vì ép chatbot trả lời. Nexios từng dùng ngưỡng cosine similarity 0,45 làm giá trị khởi đầu, rồi hiệu chỉnh theo phân bố score của câu hỏi in-scope và out-of-scope. Trong case study của họ, fallback rate giảm từ khoảng 28% xuống 12% sau sáu tuần nhờ phân tích truy vấn thất bại và bổ sung nội dung; đây không phải chuẩn chung.
- Groundedness check: Kiểm tra claim đầu ra có được hỗ trợ bởi context hay không.
- Citation enforcement: Buộc câu trả lời gắn với document title, section hoặc nguồn cụ thể.
- Fallback an toàn: Nêu rõ không tìm thấy dữ liệu đủ tin cậy và hướng người dùng đến bước tiếp theo.
Guardrail tốt nhất không phải là prompt từ chối dài hơn, mà là kết hợp retrieval chính xác, ngưỡng tự tin và bằng chứng có thể kiểm tra.
Đánh giá RAG trước và sau khi đưa vào production
Đánh giá RAG phải tách retrieval quality khỏi generation quality. Nếu chunk đúng không nằm trong tập truy xuất, việc thay prompt hoặc thay LLM ít có tác dụng. Một golden set khoảng 50–100 câu hỏi là điểm khởi đầu hữu ích để đội ngũ chạy regression test khi thay đổi parser, chunking, embedding, index hoặc prompt.
Các chỉ số như context precision, context recall, faithfulness và answer relevancy trong RAGAS giúp nhận diện tầng hỏng. Một khuyến nghị là nếu faithfulness dưới 0,9, đội ngũ nên sửa retrieval và context trước khi chỉ chỉnh generation. Tuy nhiên, ngưỡng chấp nhận phải phản ánh mức rủi ro của từng use case, nhất là các câu trả lời liên quan pháp lý, tài chính hoặc chính sách nhân sự.
- Retrieval hit rate: Đo tỷ lệ câu hỏi có bằng chứng đúng xuất hiện ở top-k.
- Fallback rate: Cho biết phạm vi tri thức và chất lượng route của hệ thống.
- P50/P95/P99 latency: Phân rã theo retrieval, reranking, LLM và các dịch vụ phụ trợ.
- Freshness và drift: Theo dõi độ mới tài liệu, embedding drift và query distribution shift.
Bảo mật, multi-tenancy và governance cho dữ liệu doanh nghiệp
RAG cho doanh nghiệp là bài toán governance trước khi là bài toán chatbot. Access control phải được truyền từ hệ thống nguồn vào chunk và vector index để một người dùng không thể retrieve tài liệu ngoài quyền của họ. Metadata filter cần thực thi ở ingestion lẫn query time; chỉ giấu thông tin trong câu trả lời cuối là quá muộn.
Trong môi trường multi-tenant, mỗi chunk cần có tenant ID và truy vấn phải filter tenant một cách bắt buộc. Khi yêu cầu cô lập cao, doanh nghiệp có thể cân nhắc index tách biệt. Cần duy trì audit trail cho phiên bản tài liệu, thời điểm index, truy vấn, nguồn được retrieve và citation được hiển thị để phục vụ điều tra lỗi, tuân thủ và cải tiến chất lượng.
- Data residency: Xác định nơi dữ liệu, vector, log và backup được lưu trữ.
- Dữ liệu nhạy cảm: Áp dụng phân loại dữ liệu, tối thiểu hóa nội dung index và chính sách retention.
- Versioned index: Có khả năng rollback khi parser, embedding hoặc chunking mới gây suy giảm.
Lộ trình triển khai RAG từ Zero đến Production
Giai đoạn MVP nên giới hạn corpus, đối tượng người dùng và loại câu hỏi. Doanh nghiệp có thể bắt đầu với pgvector hoặc vector database managed, retrieval đơn giản, citation cơ bản và golden set tối thiểu. Mục tiêu không phải chứng minh chatbot “biết tất cả”, mà tìm ra các failure mode có giá trị: tài liệu thiếu, parse lỗi, chunk sai, query mơ hồ hay quyền truy cập bị mô hình hóa chưa đúng.
Khi chuyển sang production, kiến trúc cần bổ sung hybrid search, reranking, metadata filtering, observability, CI/CD cho pipeline index và kế hoạch disaster recovery. Cache có thể giảm chi phí embedding khoảng 40–60% trong ứng dụng có truy vấn lặp lại theo nguồn được dẫn; quantization được ghi nhận có thể giảm nhu cầu lưu trữ 4–8 lần với suy giảm độ chính xác nhỏ tùy bối cảnh. Những kỹ thuật này cần được xác nhận bằng benchmark riêng.
- MVP: Corpus nhỏ, nguồn rõ ràng, citation, fallback và bộ test có nhãn.
- Scale-up: Hybrid retrieval, reranking, refresh pipeline, monitoring và kiểm soát chi phí.
- Production: Access control end-to-end, audit trail, index versioning, backup và quy trình rollback.
RAG phù hợp để xử lý facts thay đổi, còn fine-tuning phù hợp hơn cho behavior, tone, format và domain vocabulary. Hai kỹ thuật không loại trừ nhau: doanh nghiệp có thể fine-tune để chatbot tuân thủ phong cách và quy trình, đồng thời dùng RAG để đưa vào các sự thật có nguồn, mới và được kiểm soát quyền.
Câu hỏi thường gặp
RAG có luôn chính xác hơn fine-tuning không và khi nào nên kết hợp cả hai?
RAG không tự động chính xác hơn nếu dữ liệu bẩn, retrieval yếu hoặc context bị lắp ghép sai. Nó phù hợp khi tri thức là facts thay đổi, cần citation hoặc cần kiểm soát quyền truy cập. Fine-tuning phù hợp hơn để điều chỉnh hành vi, giọng điệu, định dạng và vốn từ domain. Kết hợp hai phương pháp hợp lý khi cần một chatbot cư xử nhất quán nhưng vẫn phải trả lời từ dữ liệu doanh nghiệp hiện hành.
Nên chọn chunk size và overlap bao nhiêu cho tài liệu tiếng Việt?
Không có con số cố định cho chunk size hoặc overlap. Các mốc như 400–512 token với overlap 10–20%, hoặc khoảng 2.800 ký tự với overlap 350 ký tự, chỉ là baseline. Hãy thử nghiệm trên golden set tiếng Việt của doanh nghiệp, đặc biệt với bảng biểu, văn bản pháp lý, heading lồng nhau và thuật ngữ kỹ thuật. Nếu câu trả lời thiếu điều kiện, chunk có thể quá nhỏ; nếu retrieval trả về đoạn mơ hồ, chunk có thể quá lớn.
Khi nào doanh nghiệp cần hybrid search và reranking?
Doanh nghiệp nên ưu tiên hybrid retrieval khi corpus chứa mã sản phẩm, tên riêng, acronym, mã lỗi, số hợp đồng hoặc truy vấn exact-match. Dense search giúp bắt ngữ nghĩa, còn BM25 giúp giữ tín hiệu từ khóa. Reranking phù hợp khi tập ứng viên có nhiều đoạn gần nghĩa và sai khác nhỏ; đổi lại, hệ thống phải chấp nhận chi phí latency bổ sung, được nguồn ước tính khoảng 50–100 ms cho 50 candidates.
pgvector có đủ cho chatbot nội bộ hay phải dùng Pinecone, Qdrant hoặc Weaviate?
pgvector có thể hoàn toàn phù hợp cho chatbot nội bộ, nhất là khi đội ngũ đã vận hành PostgreSQL và yêu cầu deployment không quá phức tạp. Lựa chọn chuyển sang Pinecone, Qdrant, Weaviate hoặc Milvus nên dựa trên filtering, scale, hybrid capabilities, data residency, ngân sách và năng lực vận hành. Không nên chọn theo tên công cụ; hãy benchmark trên corpus, metadata filter và tải truy vấn thực tế.
Làm gì khi chatbot không tìm thấy dữ liệu hoặc trả lời ngoài phạm vi?
Thiết kế fallback là bắt buộc. Khi score không đạt ngưỡng, metadata filter loại hết tài liệu hoặc groundedness check phát hiện claim không có bằng chứng, chatbot nên nói rõ giới hạn thay vì suy đoán. Sau đó, log truy vấn thất bại, phân loại nguyên nhân thành thiếu nội dung, lỗi parse, chunking, retrieval, quyền truy cập hoặc câu hỏi ngoài phạm vi. Vòng phản hồi này là cách thực tế nhất để giảm fallback rate mà không đánh đổi tính trung thực.
Nguồn tham khảo: RAG từ Zero đến Production: Kiến trúc xây chatbot doanh nghiệp trả lời đúng dữ liệu
Bài viết là góc nhìn cá nhân của tác giả, mang tính tham khảo — không phải tin tức báo chí.
📬 Nhận bài viết mới — miễn phí
Đừng bỏ lỡ bài viết tiếp theo. Đăng ký để nhận trong inbox.

Tác giả
Cường Nguyễn — AI Thực Chiến
Tôi là Cường Nguyễn - Founder của AI Ops Solutions.
Tôi từng là Logistics Operations Manager và đồng sáng lập thương hiệu CATCA - #1 Shopee ngành Pet Care.
10 năm kinh nghiệm Logistics/E-commerce OperationsCo-founder CATCA - #1 Shopee ngành Pet CareMột trong 300+ n8n Verified Creator toàn cầuTư vấn Giải pháp chuyển đổi số bằng AI cho 3 SMEs/quý


