Bài viết
Bài viết cá nhân
Bức tường dữ liệu 2026: AI sẽ học gì khi đã ăn gần hết web?
👤 cuongnguyen📅 31/08/2026⏱ 20 phút đọc
Trong bài viết này(22 mục)⌄
- 1. Cơn khát dữ liệu 2026: AI đang chạm bức tường 300 nghìn tỷ token
- 2. “AI ăn AI” và bẫy Model Collapse
- Vấn đề không phải synthetic data tồn tại, mà là vòng lặp học đệ quy không được kiểm soát
- 3. Synthetic Data có nhiều loại, và việc gom chúng vào một rổ là sai
- Dữ liệu verifiable khác hẳn văn bản tự do
- 4. Human anchor: dữ liệu thật phải là mỏ neo của Hybrid Datasets
- Đừng thay thế dữ liệu người bằng synthetic data; hãy dùng synthetic data để mở rộng phần người chưa phủ được
- 5. Dữ liệu độc quyền đang là lợi thế thật hơn nhiều model độc quyền
- 6. Data provenance và Data Nutrition Labels: phần nhàm chán cứu dự án AI
- Không biết dữ liệu đến từ đâu thì không thể giải thích model học gì
- 7. Lộ trình 6 bước để dùng Synthetic Data mà không tự phá model
- Bước 1: Chọn một quyết định cụ thể, không chọn khẩu hiệu AI
- Bước 2: Lập bản đồ human anchor
- Bước 3: Phân loại tác vụ theo khả năng kiểm định
- Bước 4: Sinh dữ liệu cho edge cases, không sinh hàng loạt vì thích số lớn
- Bước 5: Lọc, chấm và so sánh với dữ liệu thực
- Bước 6: Đóng vòng governance sau khi deploy
- Câu hỏi thường gặp
- Model Collapse là gì, và có khắc phục hoàn toàn được không?
- Synthetic Data có tự động an toàn về bản quyền và quyền riêng tư không?
- Doanh nghiệp vừa và nhỏ có cần tự huấn luyện model để tạo Synthetic Data không?
- Khi nào nên dùng RAG thay vì fine-tuning với dữ liệu nội bộ?
1. Cơn khát dữ liệu 2026: AI đang chạm bức tường 300 nghìn tỷ token
Ngành AI hay nói về GPU, chip, điện và các model lớn hơn. Tôi nghĩ cuộc chiến khó chịu nhất năm 2026 lại nằm ở thứ ít hào nhoáng hơn: dữ liệu con người thật.
Các ước tính được Epoch AI dẫn lại đặt kho văn bản công khai chất lượng cao do con người tạo ra ở mức khoảng 300 nghìn tỷ token hiệu dụng, với biên độ rất rộng từ 100 đến 1.000 nghìn tỷ token. Điểm quan trọng nằm ở chữ “hiệu dụng”. Không phải mọi trang web crawl được đều hữu ích để huấn luyện frontier model. Một kho token đầy spam SEO, nội dung sao chép, forum rác, bản dịch máy lỗi và văn bản AI tái chế không phải mỏ vàng. Nó là rác có định dạng.
Dự báo của Epoch AI cho rằng các frontier models có thể khai thác cạn phần dữ liệu văn bản công khai chất lượng cao này trong giai đoạn 2026–2032. “Cạn” không có nghĩa Internet hết chữ. Internet sẽ tiếp tục phình ra từng ngày. Ý nghĩa thực tế là phần văn bản mới, đa dạng, do con người viết, có thể dùng để tăng chất lượng pretraining sẽ không tăng cùng tốc độ với nhu cầu compute của các lab AI.
Đây là Data Wall. Nó không phải một bức tường bê tông khiến model dừng phát triển vào một buổi sáng. Nó giống một mỏ đã khai thác phần quặng giàu nhất. Vẫn còn đất đá, vẫn còn tài nguyên, nhưng chi phí sàng lọc cao hơn và chất lượng đầu vào thấp hơn.
Điều này giải thích vì sao cuộc nói chuyện về dữ liệu đang đổi giọng. Vài năm trước, nhiều đội AI nghĩ bài toán là thu thập càng nhiều càng tốt. Năm 2026, câu hỏi đáng tiền hơn là: dữ liệu nào thực sự giữ được tín hiệu, được phép dùng, có truy xuất được nguồn gốc, và có giúp model học một năng lực mới hay chỉ làm nó nhắc lại thứ đã biết?
Overtraining cũng cần được hiểu cho đúng. Một model có thể nhìn cùng dữ liệu nhiều lần, hoặc dùng token có chất lượng giảm dần để tiếp tục đẩy quy mô huấn luyện. Nhưng lặp dữ liệu không tự nhiên tạo ra kinh nghiệm mới. Nếu input không bổ sung thông tin, model có thể học thuộc sâu hơn những mẫu đã thấy, thay vì mở rộng hiểu biết. Với LLM, đây là vấn đề rất thật vì tiếng nói phổ biến trên web vốn đã lấn át tiếng nói hiếm.
Data Wall không nói AI hết dữ liệu. Nó nói dữ liệu tốt, có quyền sử dụng rõ ràng và có đủ độ đa dạng mới là tài sản khan hiếm.
Tôi không xem đây là lý do để bi quan về AI. Tôi xem nó là lúc ngành phải bỏ tư duy “đổ thêm token vào máy”. Nhiều doanh nghiệp Việt Nam vẫn mua API rồi hy vọng model tự hiểu quy trình nội bộ. Đó là một ảo tưởng đắt tiền. Bài viết về dữ liệu và quy trình quan trọng hơn AI model tôi từng viết có một ý vẫn đúng: model là hàng hóa hóa rất nhanh; dữ liệu sạch, có ngữ cảnh và gắn với Workflow thật mới khó sao chép.
2. “AI ăn AI” và bẫy Model Collapse
Vấn đề không phải synthetic data tồn tại, mà là vòng lặp học đệ quy không được kiểm soát
Khi dữ liệu người viết khan hơn, Synthetic Data là phản ứng gần như tất yếu. Model tạo câu hỏi, câu trả lời, dữ liệu hướng dẫn, code, ví dụ reasoning hoặc các biến thể ngôn ngữ; model đời sau lại học trên số dữ liệu đó. Chuỗi này nghe hiệu quả. Nó cũng rất dễ hỏng.
Nghiên cứu được thảo luận trên Nature về Model Collapse mô tả một trực giác đơn giản: khi model học lặp đi lặp lại từ output của model trước, các chi tiết ít gặp trong phân phối dữ liệu có xu hướng biến mất trước. Đây là phần tail distribution, hay “đuôi dài”.
Hãy hình dung một tập văn bản có nhiều cách viết không phổ biến, nhiều tình huống lạ, giọng địa phương, ngoại lệ pháp lý, bệnh hiếm, giao dịch bất thường, lỗi vận hành hiếm gặp. Model thường sinh ra mẫu trung bình có xác suất cao hơn: cách diễn đạt an toàn, ví dụ quen thuộc, câu trả lời mượt nhưng tiêu chuẩn hóa. Một vòng huấn luyện có thể chưa thấy hậu quả lớn. Qua nhiều vòng, các mẫu hiếm bị giảm tỷ trọng hoặc mất hẳn. Model nhìn gọn gàng hơn, nhưng nghèo đi.
Đó là lý do thuật ngữ “AI Autophagy” nghe khá chua chát: hệ thống tự ăn output của mình đến khi dinh dưỡng cạn. Có người gọi đùa là Habsburg AI, ám chỉ sự lai cận huyết: model được sinh ra từ một dòng dữ liệu ngày càng hẹp, rồi mang chính các giới hạn ấy sang thế hệ kế tiếp.
Sai lầm phổ biến là nghĩ Model Collapse chỉ là chuyện model bịa nhiều hơn. Nó sâu hơn thế. Model có thể vẫn viết văn trôi chảy, vẫn trả lời benchmark tốt và vẫn tạo demo đẹp. Nhưng nó mất khả năng nhận diện những gì không nằm trong mẫu trung bình. Một hệ thống hỗ trợ tín dụng có thể xử lý hồ sơ phổ thông rất ổn nhưng lúng túng ở nhóm khách hàng ít xuất hiện. Một trợ lý y tế có thể nắm triệu chứng quen thuộc nhưng làm mờ các tổ hợp hiếm. Một model pháp lý có thể tổng hợp án lệ phổ biến mà bỏ qua ngoại lệ quyết định vụ việc.
Fairness Collapse là mặt khó chịu hơn. Nếu dữ liệu gốc vốn có thiên kiến, synthetic data do model tạo ra dễ lặp lại các thiên kiến đó ở quy mô lớn. Các nhóm đại diện ít trong dữ liệu ban đầu thường nằm ở tail distribution. Khi tail bị bào mòn, fairness không chỉ đứng yên mà có thể xấu đi. Nói cách khác, model không cần “cố ý phân biệt” để gây hại. Chỉ cần pipeline tối ưu cho output dễ dự đoán, đa số sẽ ngày càng nuốt thiểu số.
Tôi đặc biệt dè chừng các đội nói rằng họ dùng LLM để tạo “vô hạn” dữ liệu đào tạo. Vô hạn về số lượng không đồng nghĩa vô hạn về thông tin. Bạn có thể nhân bản một cuốn sách thành một triệu bản; thư viện trông lớn hơn, kiến thức không tăng thêm.
3. Synthetic Data có nhiều loại, và việc gom chúng vào một rổ là sai
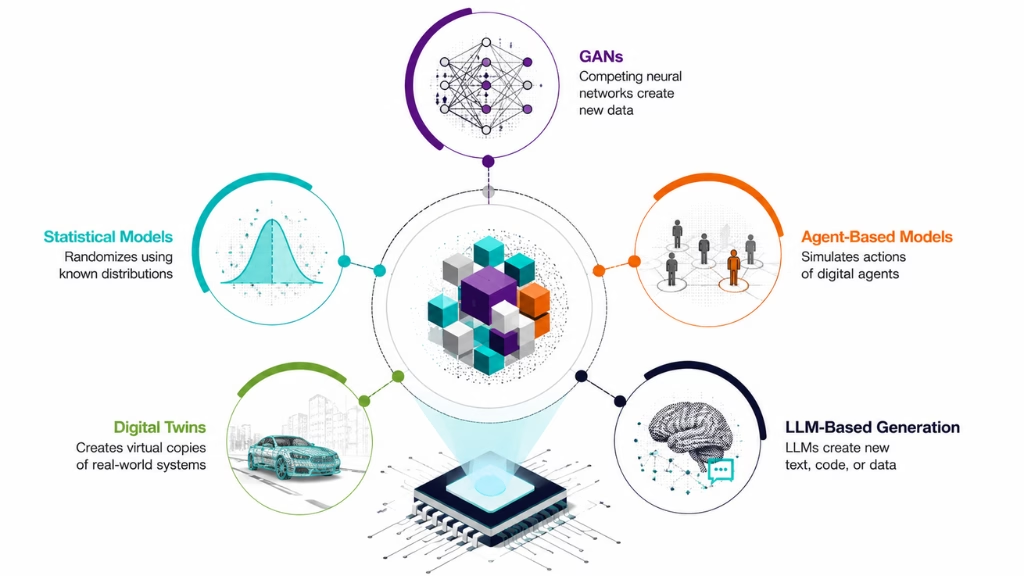
Tranh luận về Synthetic Data thường bị kéo về hai cực: hoặc thần thánh hóa, hoặc gọi nó là dữ liệu giả rồi gạt bỏ. Cả hai đều lười suy nghĩ. Giá trị của synthetic data phụ thuộc vào câu hỏi: dữ liệu đó được sinh ra để làm gì, có cách nào kiểm tra đúng sai không, và nó có giữ liên hệ với dữ liệu thực hay không?
Dữ liệu verifiable khác hẳn văn bản tự do
Code và toán là ví dụ dễ hiểu nhất. Nếu model sinh một đoạn code, compiler có thể kiểm tra code có chạy hay không. Nếu có test suite tốt, hệ thống còn kiểm tra được hành vi có đúng yêu cầu không. Với bài toán hình thức, formal verifier có thể xác minh một mệnh đề hoặc chứng minh theo luật rõ ràng. Synthetic data ở đây có một lợi thế lớn: output không chỉ được model khác chấm bằng cảm giác ngôn ngữ.
Đó là khác biệt giữa “một model nói câu trả lời này hay” và “hệ thống độc lập xác minh câu trả lời này thỏa điều kiện”. Trong loại công việc thứ hai, synthetic data có thể mở rộng tập bài tập, phủ các biến thể khó, tạo curriculum learning từ dễ đến khó và loại bớt output lỗi trước khi nó chui vào training set.
Các hướng như IBM LAB hay Nvidia Nemotron-4 thường được nhắc tới vì tư duy này: tạo dữ liệu có giám sát, có chọn lọc và có cơ chế đánh giá thay vì ném toàn bộ văn bản model sinh ra vào pipeline. Điều đáng học không phải tên framework. Điều đáng học là nguyên tắc: generator và judge không được là một hộp đen tự khen chính mình.
Ngược lại, văn bản open-ended khó xác minh hơn rất nhiều. Hãy lấy ví dụ “viết tư vấn nhân sự cho một tranh chấp nội bộ”. Câu trả lời có thể ngữ pháp hoàn hảo, lịch sự, hợp lý bề ngoài mà vẫn sai về chính sách công ty, ngữ cảnh địa phương hoặc nghĩa vụ pháp lý. Không có compiler nào bắt được lỗi đó. LLM-as-a-judge có ích để lọc thô, nhưng nó không biến đánh giá chủ quan thành sự thật.
Tôi sẽ chia Synthetic Data thành bốn nhóm thực dụng:
- Verifiable synthetic data: code, toán, logic, cấu trúc dữ liệu hoặc tác vụ có quy tắc kiểm tra độc lập.
- Simulation data: dữ liệu sinh từ mô phỏng với giả định vật lý, quy tắc nghiệp vụ hoặc môi trường được định nghĩa rõ.
- Augmentation data: biến thể có kiểm soát của dữ liệu thật, nhằm phủ cách diễn đạt, format hoặc trường hợp biên.
- Open-ended generated text: văn bản tự do do model tạo, giá rẻ nhất để sản xuất hàng loạt và nguy hiểm nhất nếu dùng thiếu kiểm định.
Nhóm cuối không vô dụng. Nó hữu ích cho prototyping, tạo bộ nháp annotation, sinh câu hỏi để reviewer đánh giá, hoặc mô phỏng hội thoại để test sản phẩm. Nhưng dùng nó làm nguồn tri thức gốc cho model sản xuất là nơi nhiều đội tự lừa mình.
Một benchmark đẹp cũng chưa đủ. Benchmark có thể bị contamination, có thể đo năng lực quá hẹp, hoặc có thể thưởng cho cách trả lời giống mẫu. Hãy hỏi một câu thực dụng hơn: synthetic data này có làm model xử lý tốt hơn các failure mode mà dữ liệu thật từng ghi nhận không? Nếu không trả lời được, pipeline đang sản xuất token chứ không sản xuất giá trị.
4. Human anchor: dữ liệu thật phải là mỏ neo của Hybrid Datasets
Đừng thay thế dữ liệu người bằng synthetic data; hãy dùng synthetic data để mở rộng phần người chưa phủ được
Giải pháp hợp lý nhất không phải dừng dùng Synthetic Data. Nó là kiến trúc Hybrid Datasets: giữ dữ liệu thực của con người làm human anchor, rồi dùng synthetic data đã kiểm định để bổ sung có chủ đích.
“Mỏ neo” nghĩa là gì? Nó nghĩa là model luôn có một phần dữ liệu gốc phản ánh ngôn ngữ, hành vi, ngoại lệ và mâu thuẫn thật của thế giới. Phần dữ liệu này giữ phân phối không bị trượt hoàn toàn về output trung bình của model. Synthetic data không được phép thay thế neo; nó được dùng như dây kéo căng phạm vi bao phủ.
Ví dụ trong chăm sóc khách hàng, dữ liệu thật có thể là ticket đã được xử lý, transcript có consent, taxonomy lỗi sản phẩm và kết quả resolution. Từ đây, đội dữ liệu có thể tạo các biến thể synthetic cho edge cases: khách hàng mô tả lỗi bằng cách vòng vo, nhiều lỗi cùng lúc, format đơn hàng bất thường, hoặc ngôn ngữ pha trộn. Nhưng mỗi biến thể phải quay về một sự thật gốc: chính sách nào áp dụng, trạng thái đơn hàng nào có thật, và câu trả lời nào được phép.
Trong tài chính, mục tiêu có thể là kiểm tra các pattern hiếm thay vì làm giả một kho giao dịch khổng lồ rồi tin rằng nó đại diện thực tế. Trong y tế, dữ liệu hiếm có giá trị lớn nhưng rủi ro sai cũng lớn. Việc mô phỏng có thể giúp huấn luyện Workflow hoặc kiểm thử, song không cho phép đội ngũ bỏ qua validation chuyên môn. Trong xe tự hành, dữ liệu mô phỏng có thể tạo edge case khó thu thập; nhưng mô phỏng chỉ tốt khi các giả định của nó bị kiểm tra liên tục bằng quan sát thực.
Công thức mà tôi tin dùng là: dữ liệu thật định nghĩa vấn đề, dữ liệu synthetic mở rộng biến thể, và evaluation thực quyết định dữ liệu synthetic có được giữ lại hay không. Thứ tự này quan trọng. Đảo ngược nó là bạn để generator tự vẽ đề bài rồi tự chấm bài.
Human anchor không phải một thư mục dữ liệu lịch sử. Nó là cơ chế buộc hệ thống quay về thực tế mỗi khi synthetic pipeline bắt đầu tự tin quá mức.
Ở cấp sản phẩm, Hybrid Datasets cũng gắn chặt với cách triển khai. Nếu dữ liệu nội bộ nhạy cảm, chạy local có thể là lựa chọn đúng cho một số workload, nhưng không mặc định rẻ hay đơn giản hơn Cloud API. Tôi đã phân tích kỹ phần chi phí, GPU và MLOps trong bài chạy AI local 2026: khi nào đáng, khi nào không. Data strategy và deployment strategy phải được thiết kế cùng nhau, không phải ký API xong mới bàn chuyện dữ liệu.
5. Dữ liệu độc quyền đang là lợi thế thật hơn nhiều model độc quyền
Web-scraping diện rộng từng là cách nhanh để các lab tích lũy corpus. Data Wall, tranh chấp bản quyền và yêu cầu tuân thủ đang làm mô hình đó khó sống hơn. Giá trị đang dịch chuyển sang quan hệ đối tác với nhà xuất bản, viện nghiên cứu, kho dữ liệu chuyên ngành và dữ liệu doanh nghiệp có quyền sử dụng rõ ràng.
Dữ liệu private không tự động tốt. Một kho CRM đầy trường trống, ghi chú mâu thuẫn, dữ liệu cá nhân lộ thiên và quy trình không chuẩn hóa sẽ chỉ tạo một phiên bản nội bộ của web rác. Nhưng private data có một lợi thế mà corpus công khai hiếm có: nó gắn với hành động và kết quả thật.
Một doanh nghiệp logistics biết chuyến nào bị trễ, nguyên nhân được xác nhận, SLA nào bị vi phạm và cách nhân viên xử lý sau đó. Một hãng bảo hiểm biết hồ sơ nào bị trả lại, điều kiện nào làm tăng rủi ro và quyết định nào bị khiếu nại. Một công ty SaaS biết ticket nào dẫn tới churn. Đây là loại dữ liệu giúp model hiểu domain nếu được quản trị tốt. Nó không thể mua trọn gói như một API.
Tôi cho rằng nhiều doanh nghiệp đang đánh giá sai tài sản này. Họ coi dữ liệu vận hành là thứ để báo cáo BI; đối thủ coi nó là nguồn huấn luyện, retrieval và evaluation cho AI. Khoảng cách cạnh tranh sẽ không nằm ở việc bên nào dùng model có nhiều tham số hơn. Nó nằm ở việc bên nào có feedback loop tốt hơn giữa hành động AI và kết quả kinh doanh.
Tất nhiên, private data kéo theo câu hỏi khó: ai sở hữu, ai được cấp quyền, retention bao lâu, có dữ liệu cá nhân nào nằm trong đó, và có được dùng để train hay chỉ được dùng cho RAG? Đừng dùng chữ “nội bộ” như một lá bùa miễn tuân thủ. Dữ liệu của khách hàng nằm trong hệ thống của bạn vẫn là dữ liệu của khách hàng theo nghĩa quyền riêng tư và nghĩa vụ bảo vệ.
Vấn đề này còn có tuổi thọ dài. Nếu doanh nghiệp lưu dữ liệu nhạy cảm hôm nay, rủi ro giải mã trong tương lai vẫn tồn tại. Đó là lý do tư duy quản trị dữ liệu cần đi cùng kế hoạch bảo vệ dài hạn, tương tự luận điểm trong bài về mật mã hậu lượng tử cho doanh nghiệp.
6. Data provenance và Data Nutrition Labels: phần nhàm chán cứu dự án AI
Không biết dữ liệu đến từ đâu thì không thể giải thích model học gì
Data provenance nghe giống việc giấy tờ mà kỹ sư muốn né. Nhưng khi AI bắt đầu chạm vào quyết định vận hành, đây là thứ phân biệt một demo vui với một hệ thống có thể chịu kiểm toán.
Một Data Nutrition Label tốt không cần giả vờ chính xác tuyệt đối. Nó cần trả lời rõ những điều cơ bản: dữ liệu sinh từ đâu, do ai sở hữu hoặc cấp quyền, được thu thập khi nào, có dữ liệu do người tạo hay do model tạo, đã qua biến đổi nào, đại diện nhóm nào, thiếu nhóm nào, ai phê duyệt và được phép dùng cho mục đích nào.
Với synthetic data, nhãn phải ghi thêm generator, model version, prompt hoặc template, seed khi có, rule kiểm định, tỷ lệ bị loại, tiêu chí lọc và mối liên hệ với dữ liệu gốc. Nếu một record synthetic sinh từ một tình huống thật đã de-identify, pipeline cần có khả năng chứng minh nó đã qua các bước nào. Không có dòng đời dữ liệu này, đội ngũ không thể điều tra khi model đưa ra output nguy hiểm.
EU AI Act và các động thái quản lý như từ FTC đang đẩy doanh nghiệp về phía minh bạch hơn trong cách dùng dữ liệu và mô tả năng lực AI. Tôi không khuyên ai đọc luật rồi tự phong luật sư. Điều tôi khuyên là đừng đợi legal hỏi mới bắt đầu lập inventory dữ liệu. Đến lúc đó, bạn thường phát hiện không ai biết model fine-tune bằng bản export nào, ai copy nó ra ngoài, hay synthetic set nào đã trộn vào tập huấn luyện.
ISO/IEEE hay bất kỳ bộ tiêu chuẩn nào cũng không cứu được một quy trình giả vờ tuân thủ. Giá trị của governance nằm ở khả năng dừng một dataset đáng ngờ trước khi nó đi vào production. Nếu review chỉ là checkbox sau khi model đã học, đó không phải governance. Đó là viết biên bản sau tai nạn.
7. Lộ trình 6 bước để dùng Synthetic Data mà không tự phá model
Tôi sẽ không khuyên SME tự xây một nhà máy dữ liệu tổng hợp hoành tráng. Đa số không cần, và nhiều đội sẽ chết vì vận hành trước khi hưởng lợi từ model. Hãy bắt đầu từ failure mode thật và đi theo sáu bước sau.
Bước 1: Chọn một quyết định cụ thể, không chọn khẩu hiệu AI
Đừng mở dự án với câu “chúng ta cần Synthetic Data”. Hãy mở bằng một tác vụ: phân loại ticket sai, phát hiện hồ sơ thiếu thông tin, hỗ trợ QA code, hay kiểm thử luồng chatbot. Xác định failure mode hiện tại và cách đo lỗi. Nếu chưa có baseline từ dữ liệu thật, chưa có lý do chính đáng để sinh dữ liệu mới.
Bước 2: Lập bản đồ human anchor
Liệt kê dữ liệu thật nào có quyền sử dụng, nguồn nào có consent hoặc hợp đồng, dữ liệu nào bị hạn chế và dữ liệu nào cần de-identify. Chọn tập đại diện cho hành vi thực, bao gồm cả trường hợp hiếm mà tổ chức từng gặp. Đừng chỉ lấy các case đã xử lý đẹp; chính những case xấu mới nói model có ích ở đâu.
Bước 3: Phân loại tác vụ theo khả năng kiểm định
Với code, cấu trúc, rule engine hoặc output có điều kiện rõ, ưu tiên verifier, test suite, compiler và formal checks. Với ngôn ngữ tự do, dùng chuyên gia domain, rubric và mẫu kiểm thử thực. Đừng áp cùng một pipeline cho mọi loại dữ liệu. Một unit test không thay thế được reviewer pháp lý; reviewer pháp lý cũng không nên ngồi chấm từng lỗi dấu ngoặc của code.
Bước 4: Sinh dữ liệu cho edge cases, không sinh hàng loạt vì thích số lớn
Xác định vùng coverage còn trống: cách diễn đạt hiếm, input lỗi định dạng, tổ hợp điều kiện bất thường hoặc tình huống phản công. Sinh các biến thể có mục tiêu. Mỗi record nên có lý do tồn tại: nó kiểm tra giả thuyết nào, bù lỗ hổng nào, và sẽ bị loại nếu fail điều kiện nào.
Bước 5: Lọc, chấm và so sánh với dữ liệu thực
Đây là chỗ tốn công nhưng không thể cắt. Lọc duplicate, kiểm tra leakage, đối chiếu rule, kiểm tra bias theo nhóm dữ liệu mà bạn theo dõi và đánh giá bằng holdout thật. Nếu synthetic set làm benchmark nội bộ tăng nhưng làm kết quả trên case thực giảm, hãy tin case thực. Bạn không xây AI để thắng kỳ thi do chính mình ra đề.
Bước 6: Đóng vòng governance sau khi deploy
Log output, ghi nhận override của con người, lưu failure report và định kỳ kiểm tra drift. Dữ liệu từ production có thể quay lại làm human anchor sau khi được xem xét quyền sử dụng và chất lượng. Synthetic data cũng cần versioning, rollback và retirement. Một dataset không phải tài sản bất tử; nó có thể cũ, lệch hoặc nhiễm lỗi theo thời gian.
Quan điểm của tôi khá rõ: Synthetic Data đáng đầu tư khi nó giúp đội ngũ kiểm soát edge cases, tăng coverage có kiểm chứng hoặc bảo vệ dữ liệu nhạy cảm trong môi trường test. Nó không đáng đầu tư nếu mục tiêu duy nhất là có nhiều token hơn để báo cáo. Càng gần quyết định có hậu quả thật, tiêu chuẩn kiểm định càng phải cao.
Câu hỏi thường gặp
Model Collapse là gì, và có khắc phục hoàn toàn được không?
Model Collapse là hiện tượng chất lượng và độ đa dạng của model suy giảm khi các thế hệ sau học đệ quy từ output của các thế hệ trước. Phần tail distribution thường mất trước, khiến model thiên về câu trả lời phổ biến và dự đoán an toàn. Không có một nút “chữa hoàn toàn”. Cách giảm rủi ro là giữ dữ liệu người thật làm human anchor, giới hạn tỷ lệ và mục đích dùng synthetic data, kiểm định độc lập và đánh giá thường xuyên trên dữ liệu thực.
Synthetic Data có tự động an toàn về bản quyền và quyền riêng tư không?
Không. Dữ liệu tổng hợp có thể hỗ trợ giảm rủi ro lộ thông tin khi được thiết kế đúng, nhưng nhãn “synthetic” không tự xóa nghĩa vụ pháp lý. Bạn vẫn cần biết dữ liệu gốc đến từ đâu, có quyền dùng cho mục đích nào, quá trình sinh có thể tái tạo thông tin nhạy cảm hay không và hệ thống lưu dữ liệu bao lâu. Data provenance phải có từ đầu, không phải thêm vào lúc audit.
Doanh nghiệp vừa và nhỏ có cần tự huấn luyện model để tạo Synthetic Data không?
Thường là không. SME nên bắt đầu bằng model hoặc framework sẵn có, kết hợp dữ liệu domain nội bộ đã được làm sạch và một Workflow kiểm định gọn. Giá trị nằm ở rubric, test case, quy tắc loại bỏ và feedback từ người vận hành. Tự train từ đầu đòi hỏi dữ liệu, compute và MLOps mà phần lớn doanh nghiệp chưa cần.
Khi nào nên dùng RAG thay vì fine-tuning với dữ liệu nội bộ?
Nếu tri thức thay đổi thường xuyên, cần dẫn nguồn hoặc cần kiểm soát tài liệu nào được phép trả lời, RAG thường là điểm bắt đầu hợp lý. Fine-tuning hữu ích hơn khi bạn cần định hình hành vi, format, phong cách hoặc một pattern tác vụ lặp lại. Dù chọn cách nào, dữ liệu nguồn vẫn phải có provenance. RAG không biến tài liệu cũ, sai hoặc không được cấp quyền thành tri thức đáng tin.
Nguồn tham khảo: Bức Tường Dữ Liệu 2026: Cơn Khát Token Con Người, Cạm Bẫy Model Collapse và Lời Giải Synthetic Data
Bài viết là góc nhìn cá nhân của tác giả, mang tính tham khảo — không phải tin tức báo chí.
📬 Nhận bài viết mới — miễn phí
Đừng bỏ lỡ bài viết tiếp theo. Đăng ký để nhận trong inbox.

Tác giả
Cường Nguyễn — AI Thực Chiến
Tôi là Cường Nguyễn - Founder của AI Ops Solutions.
Tôi từng là Logistics Operations Manager và đồng sáng lập thương hiệu CATCA - #1 Shopee ngành Pet Care.
10 năm kinh nghiệm Logistics/E-commerce OperationsCo-founder CATCA - #1 Shopee ngành Pet CareMột trong 300+ n8n Verified Creator toàn cầuTư vấn Giải pháp chuyển đổi số bằng AI cho 3 SMEs/quý


