Bài viết
Bài viết cá nhân
Harness Engineering là gì? Làm sao để tối ưu cho người dùng AI?
👤 cuongnguyen📅 27/08/2026⏱ 21 phút đọc
Trong bài viết này(29 mục)⌄
- Prompt tốt không cứu được một hệ thống AI yếu
- Từ Prompt Engineering tới Harness Engineering
- Model là não, Harness là môi trường hành động
- Tám mảnh ghép của một Harness dùng được trong production
- 1. System Prompt và ngữ cảnh nền tảng có cấu trúc
- 2. Tooling và quyền gọi API
- 3. Dynamic Code Execution
- 4. Sandbox cách ly
- 5. Persistent Storage và file system
- 6. Memory và Context Compaction
- 7. Guardrails và Human-in-the-loop
- 8. Observability và feedback loops
- Guides và Sensors: hai nửa của kiểm soát
- Ba lớp chất lượng: code sạch, kiến trúc đúng và hành vi đúng
- Tối ưu Harness cho người dùng AI: ít ma sát, nhiều bằng chứng
- Shift-left chất lượng
- Thiết kế quyền theo tác vụ
- Đặt điểm phê duyệt đúng chỗ
- Trả kết quả kèm bằng chứng
- Kiểm soát latency và token
- Những bẫy dễ làm Harness phản tác dụng
- Harness Engineering và bài toán Agent Sprawl
- Harness sẽ đi về đâu?
- Câu hỏi thường gặp
- Harness Engineering khác gì LangChain hoặc LlamaIndex?
- Doanh nghiệp nhỏ có cần xây Harness riêng không?
- LLM mạnh hơn có khiến Harness Engineering hết cần thiết?
- Đo Harness Coverage bằng cách nào?
- Khi nào nên dùng Human-in-the-loop?
Prompt tốt không cứu được một hệ thống AI yếu
Nhiều đội xây AI vẫn mắc cùng một ảo tưởng: chọn model mạnh hơn, viết System Prompt dài hơn, thêm vài tài liệu vào RAG, rồi kỳ vọng AI Agent sẽ xử lý công việc như một nhân viên giỏi. Cách làm này có thể tạo ra một buổi demo đẹp. Nhưng khi đưa vào luồng làm việc thật, Agent rất nhanh lộ ra vấn đề: quên yêu cầu ở đầu cuộc hội thoại, gọi sai API, sửa một lỗi rồi tạo thêm hai lỗi khác, trả lời tự tin về thứ nó chưa kiểm tra, hoặc mắc kẹt trong một vòng retry vô nghĩa.
Đó là lý do khái niệm Harness Engineering được nhắc tới nhiều hơn trong giai đoạn 2026. Nó không phải một tên mới cho Prompt Engineering. Nó là sự thay đổi trọng tâm: thay vì chỉ hỏi “viết gì để model trả lời đúng?”, ta phải hỏi “xây môi trường nào để model có thể hành động, bị kiểm tra, tự sửa và biết lúc nào phải dừng?”.
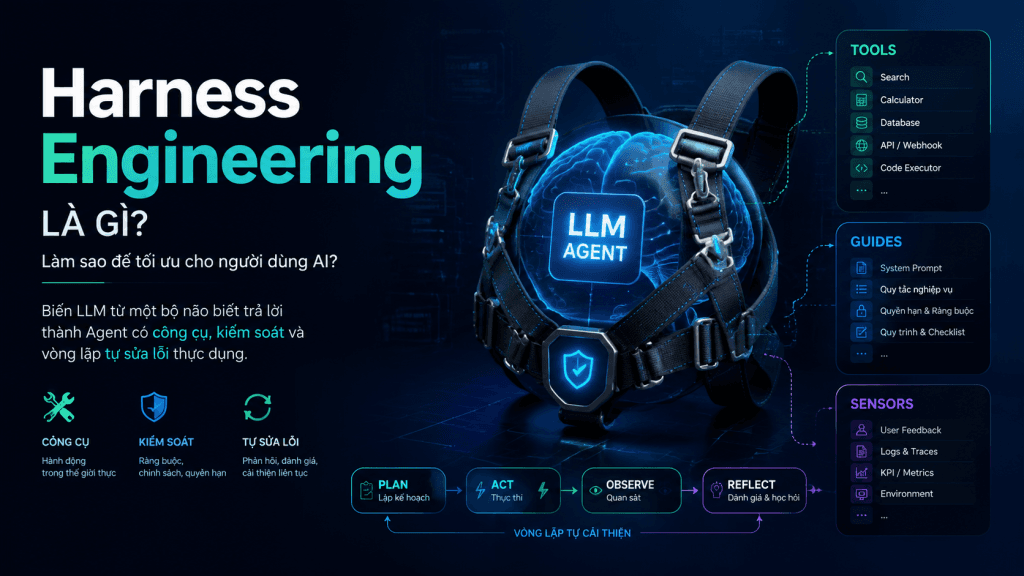
Công thức ngắn nhất là: Agent = Model + Harness. Model là năng lực suy luận xác suất. Harness là lớp phần mềm bao quanh model: công cụ, API, bộ nhớ, file system, sandbox, giới hạn quyền, kiểm thử, cơ chế phê duyệt và các tín hiệu phản hồi. Nếu bỏ Harness, ta có một bộ não giỏi ngôn ngữ nhưng bị thả vào căn phòng không bản đồ, không tay chân và không hàng rào an toàn.
Tôi nghĩ đây là cách nhìn thực tế hơn về AI Agent. Nhiều người đang tranh luận GPT-5, Claude 3.7/Sonnet hay Llama-4 mạnh hơn. Câu hỏi đó có ích, nhưng chưa đủ. Với một tác vụ có quy trình rõ ràng, một model tầm trung chạy trong Harness tốt có thể hữu ích hơn model tối tân được giao một prompt mơ hồ, quyền truy cập quá rộng và không có kiểm tra đầu ra.
Với người dùng AI cuối cùng, Harness Engineering không phải thuật ngữ kiến trúc xa vời. Nó quyết định một Agent có trả lời “tôi đã xong” sau khi chỉ mới viết code hay không; có thực sự chạy test trước khi đưa kết quả không; có nhắc bạn phê duyệt trước khi gửi dữ liệu ra ngoài không; có giữ được mạch công việc sau nhiều bước hay không.
Prompt Engineering vẫn cần. Context Engineering vẫn cần, nhất là khi bạn xây RAG production cho dữ liệu doanh nghiệp. Nhưng cả hai chỉ là một phần của Harness. Một hệ thống AI đáng tin cậy cần thiết kế luồng hành động, không chỉ thiết kế câu hỏi.
Từ Prompt Engineering tới Harness Engineering
Prompt Engineering tập trung vào cách diễn đạt yêu cầu để LLM trả lời tốt hơn. Nó hữu ích ở mức cá nhân: đặt vai trò, chỉ định định dạng, đưa ví dụ, yêu cầu model kiểm tra lại. Khi nhiệm vụ đơn giản và chỉ có một lượt tương tác, prompt tốt thường đem lại khác biệt thấy ngay.
Sau đó, đội ngũ xây sản phẩm nhận ra model không thể chỉ sống bằng prompt. Nó cần dữ liệu đúng ở đúng thời điểm. Context Engineering xuất hiện để giải quyết việc chọn, nén, sắp xếp và đưa ngữ cảnh vào model. RAG, retrieval, memory và context compaction nằm trong hướng này.
Vấn đề là Agent thực tế còn phải làm nhiều việc hơn đọc và viết. Nó có thể cần tra cứu tài liệu, gọi API, mở file, viết code, chạy code, kiểm tra kết quả, cập nhật trạng thái rồi báo cáo cho người dùng. Mỗi hành động đều có khả năng sai. Context tốt không tự biến một API call thất bại thành thành công. Prompt rõ không ngăn Agent xóa nhầm file. Model mạnh cũng không tự biết kiến trúc module của codebase nếu hệ thống không cung cấp hướng dẫn và công cụ kiểm tra.
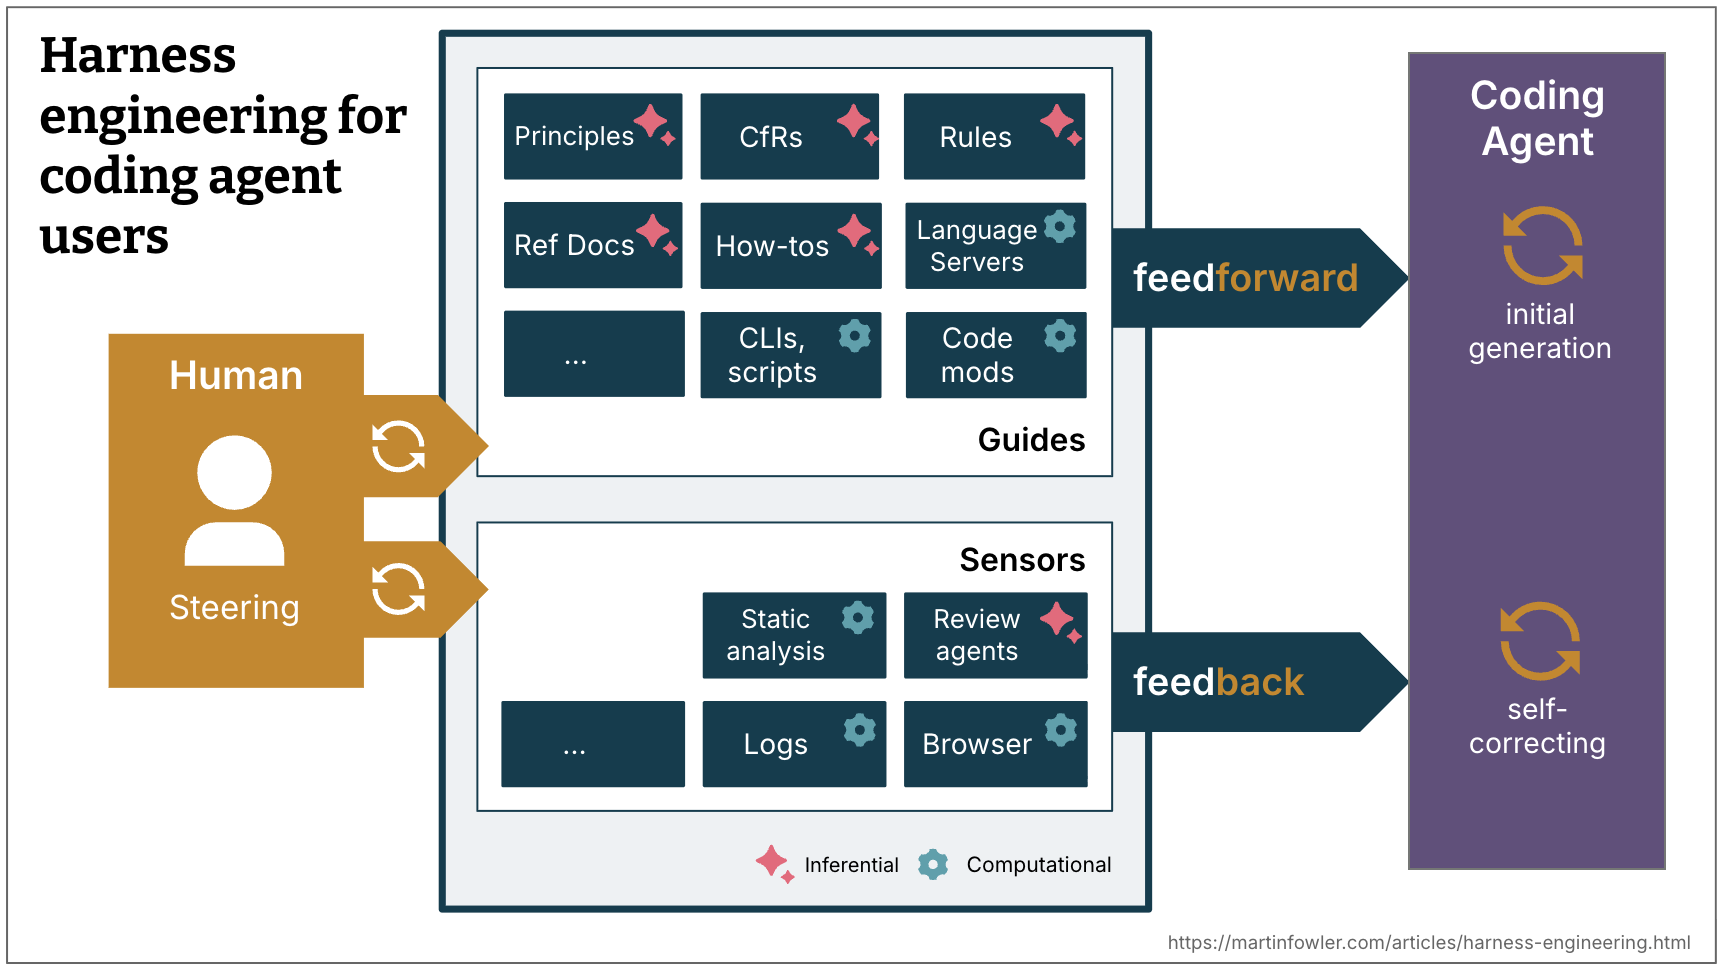
Harness Engineering xử lý phần còn thiếu ấy. Theo cách phân tích của Birgitta Böckeler, Distinguished Engineer tại Thoughtworks, Harness là software scaffolding bao quanh LLM và thiết kế này cần hai loại cơ chế điều phối: Guides và Sensors. Guides định hướng trước khi Agent hành động. Sensors kiểm tra sau khi Agent đã làm một việc và tạo phản hồi để Agent sửa lỗi.
Đây là điểm nhiều người hiểu sai. Họ xem Agent như chatbot có thêm tool. Tôi xem chatbot gắn tool chỉ mới là nguyên liệu thô. Agent chỉ đáng tin khi nó vận hành bên trong một chuỗi giới hạn, quan sát và phản hồi được thiết kế có chủ đích.
Model là não, Harness là môi trường hành động
Ẩn dụ “Model là não, Harness là cơ thể và môi trường” khá chính xác nếu ta không đẩy nó quá xa. LLM nhận input, suy luận theo xác suất và tạo output. Nó không mặc định có trí nhớ bền vững, quyền truy cập dữ liệu hay năng lực xác minh điều mình vừa nói. Các khả năng đó phải do hệ thống cấp cho nó.
Trong một Harness cấp production, model có thể nhận được danh sách tool và quy tắc dùng tool. Nó có thể được cho phép đọc một thư mục nhưng không được phép ghi vào thư mục khác. Nó có thể chạy code trong sandbox cách ly. Nó có thể được đưa kết quả từ unit test, linter hoặc type checker sau mỗi thay đổi. Nó có thể phải xin xác nhận của con người trước một hành động nhạy cảm.
Khi đó, Agent không còn chỉ “trả lời”. Nó đi qua chu trình mở rộng: Reason → Act → Observe → Self-correct. Agent suy luận kế hoạch, thực hiện hành động, quan sát kết quả từ môi trường rồi quyết định sửa, tiếp tục hoặc dừng. Chất lượng của chu trình này phụ thuộc nhiều vào chất lượng quan sát. Nếu tool trả về lỗi khó hiểu, nếu test không đại diện cho yêu cầu, nếu ngữ cảnh bị nhiễu, Agent sẽ học từ tín hiệu xấu.
Đây cũng là nguồn gốc của khoảng cách niềm tin giữa người dùng và LLM. Người dùng không cần Agent nói hay. Họ cần biết Agent đã làm gì, kiểm tra gì, cái gì còn chưa chắc và lúc nào họ cần can thiệp. Một Agent trả lời rất trôi chảy nhưng không cho thấy bằng chứng thường nguy hiểm hơn một Agent nói “tôi chưa đủ dữ liệu để thực hiện bước này”.
Tôi thích những hệ thống dám hiển thị ranh giới của mình. Một Agent nên phân biệt rõ: thông tin lấy từ nguồn nào, hành động nào đã thực thi, kết quả nào đã qua kiểm tra xác định, và phần nào chỉ là nhận định của LLM. Điều này nghe bớt hào nhoáng hơn một màn demo tự động hoàn toàn, nhưng nó là nền tảng để người dùng giao việc thật.
Tám mảnh ghép của một Harness dùng được trong production
Không tồn tại một Harness chuẩn phù hợp mọi sản phẩm. Agent hỗ trợ lập trình và Agent xử lý hồ sơ doanh nghiệp có rủi ro khác nhau. Dù vậy, một Harness đủ nghiêm túc thường phải trả lời được tám câu hỏi kỹ thuật sau.
1. System Prompt và ngữ cảnh nền tảng có cấu trúc
System Prompt vẫn là luật nền của Agent: mục tiêu, giới hạn, format đầu ra, quy tắc bảo mật và nguyên tắc dừng. Nhưng đừng nhồi mọi thứ vào một prompt khổng lồ. Các quy tắc bền vững nên được tách thành cấu trúc rõ: hướng dẫn dự án, API specs, quy ước đặt tên, kiến trúc module và chính sách quyền truy cập.
Với coding agent, file như AGENTS.md có giá trị hơn một đoạn nhắc chung chung kiểu “hãy viết code sạch”. Nó nói cho Agent biết repo này tổ chức ra sao, lệnh nào để chạy test, khu vực nào không được sửa và tiêu chuẩn nào cần thỏa. Đây là Guide có thể kiểm tra, cập nhật và phiên bản hóa.
2. Tooling và quyền gọi API
Tool không phải càng nhiều càng tốt. Mỗi tool mới thêm một nhánh quyết định, một kiểu lỗi và một phần mô tả mà model phải hiểu. Tool Overload làm Agent phân tâm, gọi sai công cụ hoặc bỏ qua công cụ quan trọng.
Hãy cung cấp tool theo nhiệm vụ. Một Agent tra cứu kiến thức không cần quyền deploy. Một Agent hỗ trợ khách hàng không nên tự ý ghi dữ liệu nhạy cảm. Mô tả tool cần cụ thể về input, output, lỗi và điều kiện dùng. API mơ hồ tạo ra Agent mơ hồ.
3. Dynamic Code Execution
Khả năng viết và thực thi code động cho Agent một cách để tự kiểm tra thay vì đoán. Nó có thể xử lý dữ liệu, tạo artefact hoặc chạy kiểm thử. Nhưng đây cũng là khu vực cần kiểm soát mạnh nhất vì code có thể truy cập tài nguyên ngoài ý muốn nếu môi trường quá rộng.
4. Sandbox cách ly
Sandbox là nơi Agent chạy hành động có rủi ro trong phạm vi giới hạn. Người dùng không nên trả giá cho một thử nghiệm sai của Agent bằng việc file thật bị thay đổi hoặc dữ liệu bị gửi đi. Tách môi trường thử nghiệm khỏi tài nguyên quan trọng là quyết định kiến trúc cơ bản, không phải tính năng bổ sung cho đẹp.
5. Persistent Storage và file system
Nhiều công việc nhiều bước cần artefact tồn tại qua các lượt: file trung gian, kế hoạch, kết quả test, báo cáo hoặc trạng thái nhiệm vụ. Nếu Agent phải nhớ tất cả bằng token trong context window, hệ thống sớm gặp giới hạn. File system bền vững giúp tách dữ liệu công việc khỏi hội thoại.
6. Memory và Context Compaction
Context rot là sự suy thoái chất lượng khi quá nhiều lịch sử, tài liệu và kết quả cũ dồn vào context. LLM không tự động phân biệt phần nào còn liên quan. Context Compaction cần giữ quyết định quan trọng, trạng thái hiện tại, lỗi chưa xử lý và các ràng buộc; đồng thời bỏ bớt phần lặp hoặc đã hết giá trị.
Đây là chỗ tôi thấy nhiều sản phẩm làm qua loa. Họ gọi nó là “memory”, nhưng thật ra chỉ lưu toàn bộ chat history. Đó không phải trí nhớ hữu ích. Trí nhớ hữu ích phải phục vụ một quyết định tiếp theo.
7. Guardrails và Human-in-the-loop
Guardrails xác định hành động nào Agent được tự làm, hành động nào cần xác nhận và hành động nào bị cấm. Human-in-the-loop không có nghĩa bắt người dùng duyệt từng bước. Nếu làm vậy, Agent chỉ tạo thêm việc. Điểm phê duyệt nên đặt ở các quyết định khó đảo ngược, nhạy cảm hoặc có tác động lớn.
8. Observability và feedback loops
Cuối cùng, bạn phải biết Agent đã làm gì để sửa hệ thống. Log tool call, trạng thái nhiệm vụ, kết quả kiểm tra, lý do dừng và các retry là nguyên liệu để phát hiện Harness có điểm yếu ở đâu. Nếu không quan sát được hành trình của Agent, việc tối ưu chỉ là đoán mò.
Guides và Sensors: hai nửa của kiểm soát
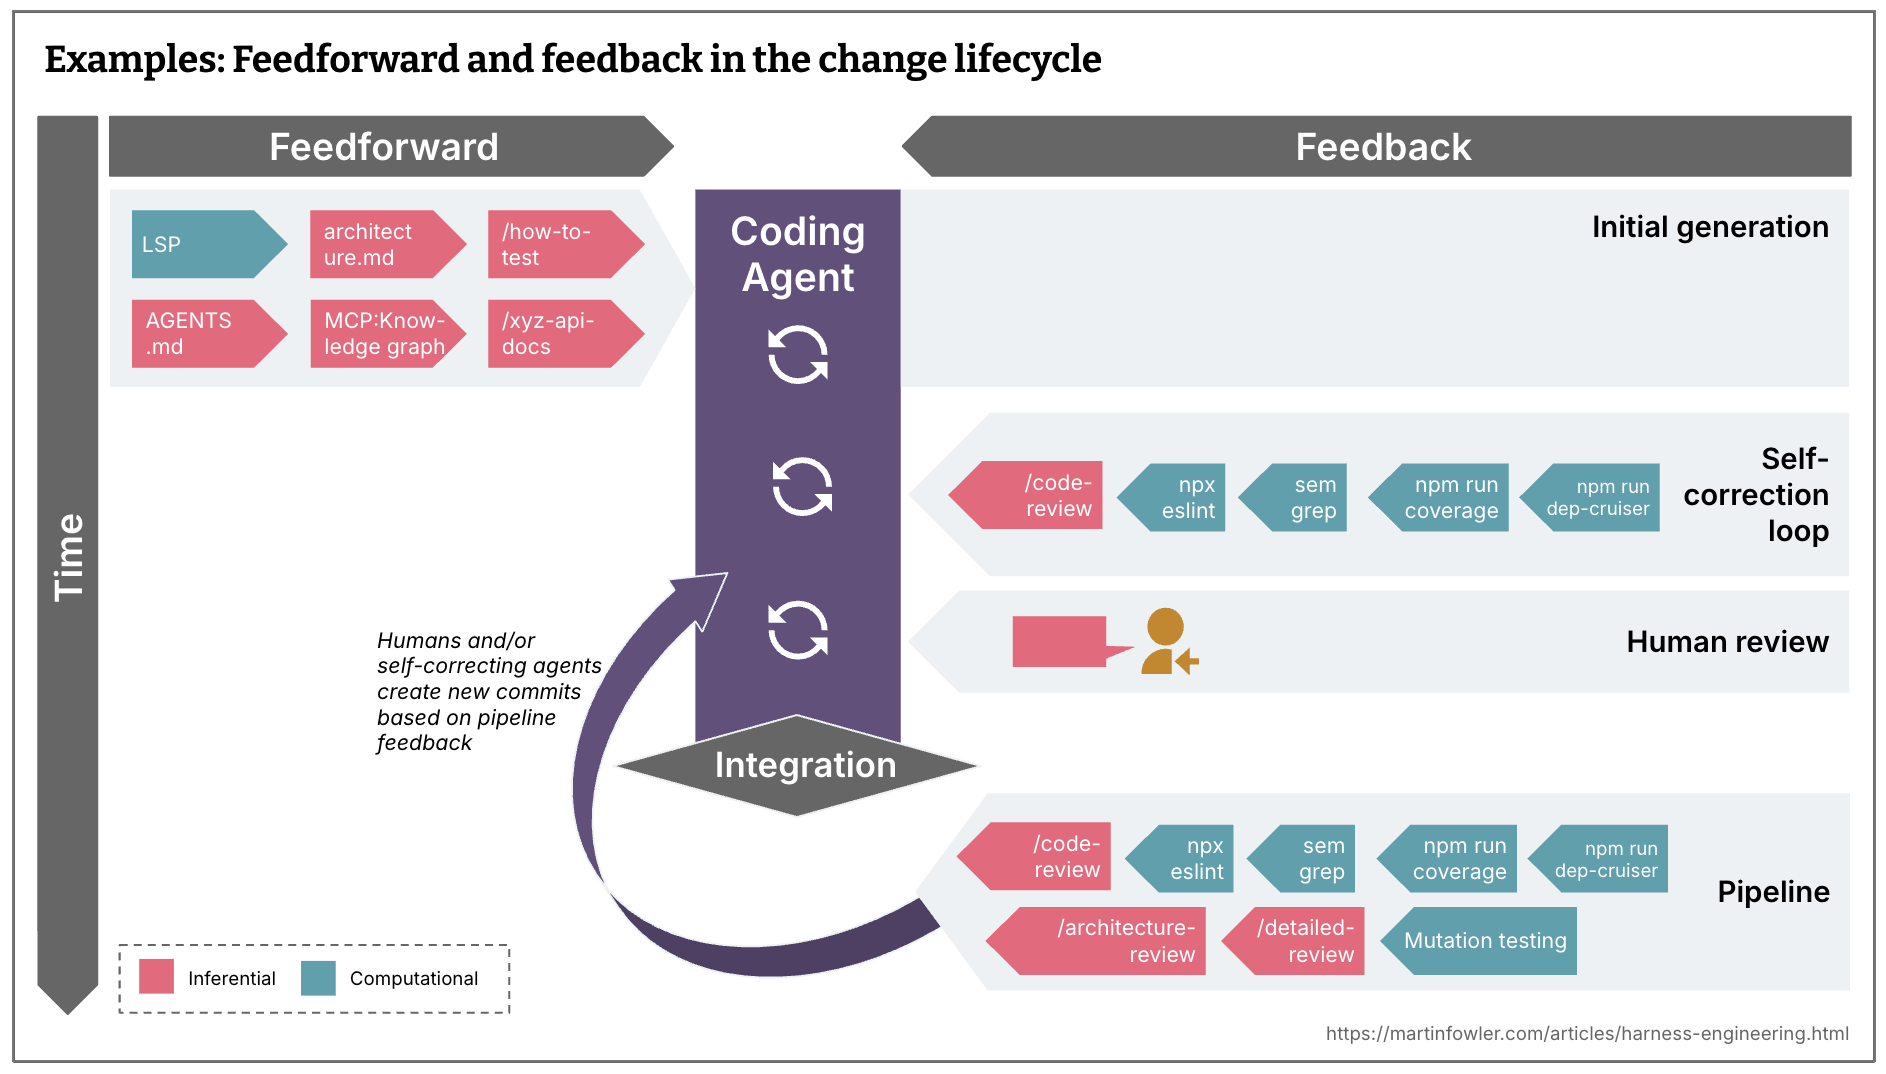
Guides là feedforward controls: chúng định hình hành vi trước khi hành động diễn ra. AGENTS.md, API specs, kiến trúc module, Language Server Protocols, danh sách tool được phép dùng và tiêu chuẩn đầu ra đều thuộc nhóm này. Mục tiêu của Guide là tăng cơ hội Agent làm đúng ngay từ đầu.
Sensors là feedback controls: chúng quan sát kết quả sau hành động và trả tín hiệu về cho Agent. Ví dụ quen thuộc gồm linter, compiler, type checker, unit test, kiểm tra kiến trúc và phản hồi từ reviewer. Sensor không “dạy” Agent trước; nó nói cho Agent biết hành động vừa rồi có đạt yêu cầu không.
Khác biệt này quan trọng vì nhiều đội chỉ đầu tư một phía. Họ viết rất nhiều hướng dẫn nhưng không có cách kiểm chứng. Agent làm sai thì vẫn tự tin hoàn thành. Hoặc họ xây một rừng test nhưng hướng dẫn quá kém, khiến Agent phải thử sai liên tục, tốn token và thời gian.
Guide tốt làm giảm số lỗi cần sửa. Sensor tốt ngăn lỗi lọt ra người dùng. Một Harness tử tế cần cả hai.
Sensors lại chia thành hai loại. Computational controls dùng công cụ xác định, nhanh ở mức mili-giây: linter, type checker, unit test, compiler hay ArchUnit. Chúng rất hợp để kiểm tra điều có thể quy thành quy tắc rõ ràng. Code có compile không? Kiểu dữ liệu có khớp không? Module có vi phạm boundary không?
Inferential controls dựa vào đánh giá ngữ nghĩa, chẳng hạn LLM-as-a-judge hoặc AI code reviewer. Chúng hữu ích khi câu hỏi không có một đáp án máy móc: giải thích này có dễ hiểu không, output có bám yêu cầu không, thay đổi này có hợp lý về mặt thiết kế không.
Đừng dùng LLM-as-a-judge để thay thế type checker. Đó là một sai lầm đắt đỏ. Kiểm tra xác định nên dùng công cụ xác định. LLM phù hợp hơn cho vùng mơ hồ về ngữ nghĩa, nơi việc viết rule cứng khó hoặc không đáng công.
Databricks đưa ra một minh họa khá đáng chú ý: với GPT-5.5 kết hợp OfficeQA Pro Agent Harness, hiệu suất xử lý tài liệu doanh nghiệp phức tạp tăng từ 36.10% lên 52.63%, với lỗi giảm gần 50%, không cần tái huấn luyện model cơ sở. Con số này không có nghĩa cứ bọc Harness là mọi bài toán sẽ tăng tương tự. Nó chỉ chỉ ra một điều quan trọng: cải thiện hệ thống bao quanh model có thể tạo chênh lệch lớn mà không đổi bộ não nền.
Ba lớp chất lượng: code sạch, kiến trúc đúng và hành vi đúng
Với Agent viết phần mềm, “test pass” chưa đủ để kết luận an toàn. Harness nên nhìn chất lượng theo ít nhất ba chiều: Maintainability, Architecture Fitness và Behaviour.
Maintainability liên quan tới độ sạch và khả năng bảo trì của code. Linter, formatter, type checker và quy ước code là Sensor phù hợp. Đây là lớp tương đối dễ tự động hóa vì nhiều tiêu chuẩn có thể biểu diễn thành rule rõ ràng.
Architecture Fitness kiểm tra thay đổi có làm lệch ranh giới kiến trúc hay phá các yêu cầu hệ thống không. Một feature chạy được nhưng đặt business logic sai module vẫn là nợ kỹ thuật. Architecture Fitness Harness dùng các ràng buộc kiến trúc và kiểm tra như ArchUnit để bảo vệ boundary đã thống nhất.
Behaviour là lớp khó nhất: phần mềm có thực hiện đúng điều người dùng cần không? Unit test có thể bắt một phần, nhưng AI-generated test suite không thể là bằng chứng tuyệt đối. Agent có thể viết test theo đúng giả định sai mà nó dùng khi viết code. Khi test và implementation cùng có chung lỗi hiểu yêu cầu, tất cả đều xanh nhưng sản phẩm vẫn sai.
Vì vậy, Behaviour Harness cần liên kết với acceptance criteria, ví dụ đầu vào-đầu ra, quy tắc nghiệp vụ và khi cần là đánh giá của con người. Đây cũng là lý do giao việc cho coding agent khác hẳn bảo nó “tự chạy test rồi merge”. Nếu bạn quan tâm chuyện developer chuyển từ viết code sang điều phối agent, bài viết về Claude Code và vai trò điều phối Agent sẽ cho thêm góc nhìn thực chiến.
Tối ưu Harness cho người dùng AI: ít ma sát, nhiều bằng chứng
Mục tiêu cuối không phải dựng một cỗ máy kiểm soát phức tạp để đội kỹ thuật tự hào. Mục tiêu là người dùng nhận kết quả đúng hơn, nhanh hơn và biết rõ lúc nào cần tin, lúc nào cần xem lại.
Shift-left chất lượng
Hãy đưa kiểm soát về sớm nhất có thể. Nếu Agent biết rõ API spec, module boundary và lệnh test trước khi sửa code, nó ít phải quay lại hơn. Nếu form giao việc buộc người dùng chọn dữ liệu được phép truy cập, Agent ít có cơ hội vượt rào hơn. Mỗi lỗi bắt được trước một tool call thường rẻ hơn lỗi phát hiện ở cuối chuỗi.
Thiết kế quyền theo tác vụ
Đừng cấp toàn quyền vì tiện. Hãy bắt đầu bằng quyền tối thiểu cần cho nhiệm vụ. Agent đọc tài liệu, Agent tạo bản nháp và Agent thực thi thay đổi thật phải là các mức khác nhau. Khi nhu cầu tăng, bạn mở rộng có điều kiện. Cách làm này giúp giảm rủi ro và khiến hành vi Agent dễ giải thích hơn.
Đặt điểm phê duyệt đúng chỗ
Người dùng ghét phải bấm duyệt 15 lần để hoàn thành một việc đơn giản. Họ cũng không muốn phát hiện hậu quả sau khi Agent đã hành động. Điểm cân bằng là phê duyệt ở lúc Agent chuẩn bị thực hiện thay đổi khó đảo ngược, gửi dữ liệu, tác động hệ thống quan trọng hoặc khi Sensor phát hiện mức độ không chắc chắn cao.
Trả kết quả kèm bằng chứng
Thay vì chỉ nói “đã xử lý xong”, Agent nên cho người dùng thấy: dữ liệu nào đã dùng, tool nào đã chạy, kiểm tra nào đã pass, thay đổi nào đã tạo và điểm nào cần họ xác nhận. Không cần đổ cả log kỹ thuật lên màn hình chính. Nhưng hệ thống phải mở được đường dẫn kiểm tra cho người muốn xem.
Kiểm soát latency và token
Self-correction có cái giá của nó. Mỗi vòng quan sát và retry tiêu thụ thời gian lẫn token. Do đó Sensor cần ngắn, rõ, có khả năng hành động. Một thông báo kiểu “có lỗi” khiến Agent đoán. Một kết quả nêu file, dòng, rule và hướng sửa giúp Agent sửa nhanh hơn.
Harness cũng cần giới hạn retry. Agent không nên tự sửa mãi khi tín hiệu mâu thuẫn hoặc khi nó không có năng lực cần thiết. Sau một ngưỡng xác định, nó phải dừng, lưu lại trạng thái và chuyển cho con người. Đây không phải thất bại; đây là hành vi an toàn.
Những bẫy dễ làm Harness phản tác dụng
Context rot là bẫy đầu tiên. Đội ngũ hay giải quyết thiếu thông tin bằng cách nhét thêm tài liệu và lịch sử chat vào context. Hệ quả là model phải lọc qua một đống nội dung, chi phí tăng và trọng tâm bị loãng. Hãy chọn ngữ cảnh theo bước hiện tại, lưu trạng thái bền vững bên ngoài model, rồi compaction phần cần giữ.
Tool Overload là bẫy thứ hai. Một menu tool quá dài làm model khó chọn. Công cụ gần giống nhau càng nguy hiểm vì Agent có thể gọi cái sai với lý do nghe vẫn hợp lý. Tôi ưu tiên vài tool sắc nét, mô tả rõ và quyền hạn hẹp hơn một “siêu Agent” ôm mọi tích hợp.
Contradictory Sensors tạo bẫy thứ ba. Một Sensor yêu cầu tối giản thay đổi, Sensor khác bắt buộc đạt tiêu chuẩn mà chỉ có thể thỏa khi tái cấu trúc lớn. Nếu Harness không chỉ rõ ưu tiên, Agent có thể dao động hoặc retry vô tận. Mọi hệ thống kiểm soát cần thứ tự ưu tiên và điều kiện dừng.
Bẫy cuối là tin vào AI-generated test suite quá sớm. Agent giỏi tạo test không đồng nghĩa test đó đại diện cho hành vi đúng. Hãy dùng test do Agent tạo như một thành phần của feedback loop, rồi neo nó vào yêu cầu, ví dụ thật và review ở những phần rủi ro.
Harness Engineering và bài toán Agent Sprawl
Các tổ chức như OpenAI, Anthropic, Databricks và Stripe đang chuẩn hóa Harness Engineering để đối mặt với context rot, architecture drift và agent sprawl. Agent sprawl xảy ra khi mỗi nhóm tự dựng một Agent với prompt, tool, dữ liệu và chính sách riêng. Lúc đầu tốc độ có vẻ tốt. Sau đó doanh nghiệp có một tập hợp Agent không có chuẩn chung về quyền truy cập, logging, kiểm tra hay cách xử lý lỗi.
Vấn đề này không chỉ dành cho công ty lớn. Một đội nhỏ cũng gặp nó khi có chatbot hỗ trợ nội bộ, Agent viết code, Agent phân tích tài liệu và nhiều automation lẻ. Nếu mỗi thứ giữ memory, API key và rule riêng, chi phí bảo trì sẽ phình ra trước cả khi bạn nhận thấy.
Hướng hợp lý là chuẩn hóa các năng lực dùng chung: sandbox, quản lý tool, cơ chế xác thực, logging, guardrails, memory policy và Sensors cơ bản. Sau đó mỗi Agent thêm Guide chuyên biệt theo nhiệm vụ. Đây là cách giữ tự do cho sản phẩm mà không biến hạ tầng thành chợ tự phát.
Với người mới, đừng mở đầu bằng platform khổng lồ. Bạn có thể bắt đầu theo lộ trình học và ứng dụng AI thực tế ở bài Học AI bắt đầu từ đâu, rồi chọn một Workflow hẹp để đo lỗi và thiết kế một feedback loop rõ ràng. Một Harness nhỏ nhưng đo được thường giá trị hơn sơ đồ kiến trúc có 20 box.
Harness sẽ đi về đâu?
Một hướng đáng theo dõi là Disposable Harnesses: khung điều phối dùng cho từng tác vụ cụ thể rồi bị loại bỏ. Thay vì buộc mọi nhiệm vụ đi qua một Agent cố định với hàng đống công cụ, hệ thống có thể tạo môi trường, toolset và quy tắc tối thiểu cho đúng một việc. Cách này hứa hẹn giảm Tool Overload và thu hẹp bề mặt rủi ro.
Hướng khác là Natural-Language Agent Harnesses, nơi các rule điều phối cấp cao có thể được mô tả bằng ngôn ngữ tự nhiên. Tôi tin cách này sẽ giúp nhiều người thiết kế Workflow hơn, nhưng không thay thế được tư duy kỹ thuật. Ngôn ngữ tự nhiên dễ diễn đạt ý định, còn quyền truy cập, sandbox, API contract và kiểm tra xác định vẫn cần được triển khai chặt chẽ.
Vai trò kỹ sư vì thế dịch chuyển dần. Giá trị không nằm riêng ở số dòng code một người gõ. Nó nằm ở năng lực đặt ranh giới, thiết kế Guides, chọn Sensors, định nghĩa điều kiện dừng và làm cho một hệ thống tự động vẫn có thể kiểm toán. Đây là công việc khó hơn viết prompt, nhưng cũng thực dụng hơn nhiều.
Câu hỏi thường gặp
Harness Engineering khác gì LangChain hoặc LlamaIndex?
LangChain và LlamaIndex là Framework, có thể hỗ trợ bạn xây một phần của hệ thống Agent. Harness Engineering là cách nhìn kiến trúc rộng hơn: nó bao gồm Guides, Sensors, tool governance, sandbox, memory, guardrails và feedback loops. Bạn có thể dùng Framework để xây Harness, nhưng cài Framework không đồng nghĩa đã có Harness tốt.
Doanh nghiệp nhỏ có cần xây Harness riêng không?
Có, nếu “xây riêng” được hiểu là xác định rõ tool, quyền, ngữ cảnh, kiểm tra và điểm phê duyệt cho Workflow của mình. Không cần khởi đầu bằng hạ tầng lớn. Hãy chọn một tác vụ lặp lại có rủi ro rõ ràng, thêm Guide cụ thể và một vài Sensor xác định. Khi đo được lỗi thực tế, bạn mới biết phần nào đáng đầu tư tiếp.
LLM mạnh hơn có khiến Harness Engineering hết cần thiết?
Không. Model mạnh hơn có thể suy luận tốt hơn, nhưng vẫn cần môi trường để truy cập công cụ, giữ trạng thái, bị giới hạn quyền và kiểm tra hành động. Model không tự tạo sandbox hay tự biết quy tắc nghiệp vụ của tổ chức. Dữ liệu từ OfficeQA Pro Agent Harness cũng cho thấy thay đổi Harness có thể cải thiện hiệu suất mà không cần tái huấn luyện model cơ sở.
Đo Harness Coverage bằng cách nào?
Đừng biến Harness Coverage thành một con số trang trí. Hãy xem mỗi nhóm rủi ro quan trọng đã có Guide, Sensor, quyền hạn phù hợp và điều kiện dừng hay chưa. Với từng Workflow, bạn cần trả lời: Agent được phép làm gì, bằng chứng nào xác minh kết quả, lỗi nào tự sửa được và lúc nào phải chuyển cho người dùng. Những vùng chưa trả lời được chính là vùng coverage còn thiếu.
Khi nào nên dùng Human-in-the-loop?
Dùng khi hành động khó đảo ngược, đụng dữ liệu nhạy cảm, ảnh hưởng hệ thống quan trọng hoặc khi Sensors không đưa ra đủ bằng chứng. Không nên đặt phê duyệt vào từng thao tác nhỏ. Mục tiêu là để con người xử lý phán đoán có giá trị cao, thay vì làm nút bấm xác nhận cho mọi bước máy đã có thể kiểm tra.
Nguồn tham khảo: Harness Engineering Là Gì? Nghệ Thuật Thiết Kế Khung Điều Phối LLM Chuẩn Production Cho Người Dùng AI Thực Tế
Bài viết là góc nhìn cá nhân của tác giả, mang tính tham khảo — không phải tin tức báo chí.
📬 Nhận bài viết mới — miễn phí
Đừng bỏ lỡ bài viết tiếp theo. Đăng ký để nhận trong inbox.

Tác giả
Cường Nguyễn — AI Thực Chiến
Tôi là Cường Nguyễn - Founder của AI Ops Solutions.
Tôi từng là Logistics Operations Manager và đồng sáng lập thương hiệu CATCA - #1 Shopee ngành Pet Care.
10 năm kinh nghiệm Logistics/E-commerce OperationsCo-founder CATCA - #1 Shopee ngành Pet CareMột trong 300+ n8n Verified Creator toàn cầuTư vấn Giải pháp chuyển đổi số bằng AI cho 3 SMEs/quý


