Bài viết
Bài viết cá nhân
World Models: Cuộc rời bỏ LLM để AI hiểu thế giới thật
👤 cuongnguyen📅 24/08/2026⏱ 20 phút đọc
Trong bài viết này(15 mục)⌄
- 1. Kỷ nguyên hậu LLM: AI bắt đầu đụng vào bức tường của ngôn ngữ
- 2. Cuộc chiến nhị phân: nén để thấu hiểu hay dựng hình để dự đoán?
- 2.1. JEPA: bỏ bớt pixel để giữ phần nguyên nhân
- 2.2. Genie 2 và Marble: khi mô phỏng phải nhìn thấy được
- 3. Spatial Intelligence vận hành thế nào: tưởng tượng trước, hành động sau
- 4. Dữ liệu tương tác vật lý mới là mỏ vàng khó khai thác
- 5. Yann LeCun và Yoshua Bengio: hai cách dùng World Model rất khác
- 6. Cảnh báo của Stanford HAI: mô phỏng sai có thể gây hại ngoài đời
- 7. Doanh nghiệp nên nhìn World Models như thế nào?
- Câu hỏi thường gặp
- World Model khác LLM ở điểm căn bản nào?
- Tại sao JEPA không muốn dự đoán từng pixel?
- Representation collapse là gì và vì sao nó nguy hiểm?
- Doanh nghiệp không làm robot có nên quan tâm World Models?
- Rủi ro lớn nhất khi triển khai là gì?
1. Kỷ nguyên hậu LLM: AI bắt đầu đụng vào bức tường của ngôn ngữ
Sau vài năm LLM thống trị gần như mọi cuộc nói chuyện về AI, một câu hỏi khó đang quay lại: nếu mô hình rất giỏi viết, tóm tắt, lập trình và đối thoại, liệu nó có thực sự hiểu thế giới nơi con người sống không?
Câu trả lời ngắn của tôi là: chưa. LLM hiểu rất nhiều mô tả về thế giới, nhưng mô tả không phải là thế giới. Một mô hình có thể đọc hàng triệu đoạn văn về cách xếp đồ lên bàn, nhưng không tự biết chiếc cốc sẽ đổ nếu robot đưa tay quá nhanh, hay một cánh cửa bị chặn thì kế hoạch giao hàng phải đổi ra sao.
Đây là điểm nghẽn của mô hình chỉ dự đoán token tiếp theo. Nó xử lý ngôn ngữ rất tốt vì internet có lượng văn bản khổng lồ. Nhưng thế giới vật lý không vận hành theo token. Nó vận hành qua trạng thái, hành động, ma sát, quán tính, va chạm, không gian, thời gian và hệ quả.
LLM cũng có vấn đề brittleness: nó dễ gãy khi gặp tình huống ngoài phân phối dữ liệu đã thấy. Một câu hỏi được diễn đạt khác đi, một công cụ đổi API, một tác vụ có ràng buộc vật lý chưa từng xuất hiện trong dữ liệu huấn luyện, mọi vẻ tự tin có thể sụp rất nhanh. Với chatbot, lỗi đó gây khó chịu. Với robot, xe tự hành, hệ thống cứu hỏa hoặc vận hành hạ tầng, lỗi đó có thể gây tai nạn.
World Model xuất hiện để xử lý đúng khoảng trống này. Thay vì chỉ hỏi “token nào đứng sau token này?”, nó học quan hệ giữa trạng thái hiện tại, một hành động và trạng thái tương lai. Có thể viết ý tưởng cốt lõi như: f(s_t, a_t) → s_{t+1}. Tại thời điểm t, hệ thống đang ở trạng thái s_t. Nó thực hiện hành động a_t. World Model dự đoán trạng thái kế tiếp s_{t+1}.
Nghe đơn giản, nhưng hệ quả kiến trúc rất lớn. Khi AI có thể tưởng tượng nhiều chuỗi hành động trước lúc hành động thật, nó không còn chỉ trả lời. Nó bắt đầu lập kế hoạch có thể kiểm chứng. Nó có thể thử “nếu làm A thì sao, làm B thì sao”, đánh giá hậu quả, rồi mới chọn phương án.
Đó là lý do Spatial Intelligence đang được nhắc tới cùng World Models. Nếu World Model là bộ máy dự đoán sự thay đổi của môi trường, Spatial Intelligence là năng lực hiểu vật thể, vị trí, chiều sâu, chuyển động và quan hệ trong không gian. Một AI biết ngôn ngữ có thể hiểu câu “đặt hộp vào trong tủ”. Một AI có trí tuệ không gian phải biết tủ ở đâu, cửa tủ mở theo hướng nào, hộp có vừa không, đường đi của cánh tay có va vào vật cản không.
Tôi không xem đây là chuyện thay thế LLM. Đó là cách nhìn hơi cực đoan và cũng khá sai trọng tâm. LLM vẫn là giao diện ngôn ngữ tuyệt vời để hiểu mục tiêu cấp cao, đọc hướng dẫn, giao tiếp với con người. World Model xử lý phần LLM vốn yếu: tính khả thi, dự báo hậu quả và hành động trong môi trường có quy luật.
Nói thẳng hơn: LLM biết kể chuyện về thế giới. World Model muốn kiểm tra xem câu chuyện đó có sống sót được khi va vào thế giới thật hay không.

2. Cuộc chiến nhị phân: nén để thấu hiểu hay dựng hình để dự đoán?
Cuộc đua World Models năm 2026 không có một con đường duy nhất. Có hai triết lý khá đối nghịch về cách AI nên học thế giới.
Phía thứ nhất là “Compress to Understand” — nén để thấu hiểu. Đại diện nổi bật là JEPA, viết tắt của Joint Embedding Predictive Architecture, gắn với Yann LeCun. Phía còn lại là “Render to Predict” — dựng hình để dự đoán, nơi mô hình tạo hoặc dự đoán trực tiếp các khung hình, điểm ảnh và môi trường 3D. Google DeepMind với Genie 2 và World Labs với Marble là những cái tên tiêu biểu cho hướng này.
Hai phe đều muốn AI dự báo tương lai. Khác biệt nằm ở câu hỏi: AI cần dự báo cái gì?
2.1. JEPA: bỏ bớt pixel để giữ phần nguyên nhân
Yann LeCun phản đối việc xem tái tạo pixel là con đường hiệu quả để hiểu thế giới. Lập luận của ông khá thuyết phục: nếu mục tiêu là biết một vật có rơi, lăn, vỡ hoặc chặn đường đi hay không, AI không cần tái tạo hoàn hảo từng phản xạ ánh sáng, bóng đổ, gợn nước hay nhiễu ảnh.
Pixel chứa nhiều thông tin nhìn rất thật nhưng không phải lúc nào cũng quan trọng cho quyết định. Một mô hình video tạo sinh có thể tiêu tốn năng lực tính toán khổng lồ để làm cảnh đẹp hơn, trong khi vẫn chưa chắc hiểu lực tác động hay quan hệ nhân quả phía dưới cảnh đó.
JEPA chọn dự đoán trong latent space, tức không gian biểu diễn ẩn. Hệ thống mã hóa quan sát thành embedding, che một phần thông tin, rồi học cách dự đoán biểu diễn của phần bị che thay vì vẽ lại toàn bộ điểm ảnh. Ý tưởng là ép mô hình giữ các đặc điểm có ý nghĩa ở cấp độ trừu tượng hơn: vật thể nào đang di chuyển, cấu trúc không gian nào ổn định, hành động nào dẫn tới biến đổi nào.
Đây không phải thủ thuật tối ưu chi phí đơn thuần. Nó là tuyên bố về bản chất của intelligence: hiểu không đồng nghĩa với sao chép đầy đủ tín hiệu đầu vào.
JEPA cần giải một vấn đề kỹ thuật khó là representation collapse. Nếu mô hình ánh xạ mọi đầu vào về cùng một vector, nó có thể làm bài toán dự đoán nhìn có vẻ dễ mà chẳng học được gì hữu ích. Các cơ chế như EMA target encoder và regularizer SIGG — Sketching, Isotropic, Gaussian — được đưa vào để ngăn không gian biểu diễn sụp về một điểm vô nghĩa.
Đầu năm 2026, Yann LeCun rời Meta để thành lập AMI Labs cùng Saining Xie, tác giả kiến trúc DiT. AMI Labs huy động vòng seed 1,03 tỷ USD. Con số này đáng chú ý không vì nó chứng minh một kiến trúc chắc thắng, mà vì thị trường đang đặt cược rất lớn rằng thời đại chỉ scale LLM đã chạm giới hạn thực tế.
Meta cũng đưa ra V-JEPA 2, được huấn luyện trên 1 triệu giờ video VideoMix22M và 62 giờ dữ liệu tương tác robot. Theo dữ liệu được công bố, hệ thống đạt tỷ lệ thành công 80% zero-shot trong các tác vụ thao túng vật lý của robot nhờ kết hợp Cross-Entropy Method và Model Predictive Control.
Tôi đánh giá kết quả này đáng quan sát, nhưng chưa đủ để hô hào rằng robot đã “hiểu vật lý” như người. Zero-shot manipulation là một benchmark quan trọng, song benchmark không phải giấy phép triển khai ngoài đời. Từ bàn thí nghiệm được kiểm soát đến nhà kho lộn xộn, khoảng cách vẫn rất dài.
2.2. Genie 2 và Marble: khi mô phỏng phải nhìn thấy được
Hướng “Render to Predict” có trực giác khác: muốn dự đoán thế giới, hãy dựng một thế giới đủ phong phú để tương tác. Google DeepMind Genie 2 có thể tạo thế giới 3D tương tác ở 24 FPS từ một ảnh tĩnh. World Labs của Fei-Fei Li phát triển Marble và được định giá, gọi vốn gần 1 tỷ USD.
Cách tiếp cận này hấp dẫn vì con người vốn suy nghĩ bằng hình ảnh và không gian. Một môi trường 3D được dựng tốt cho phép Agent thử hành động, quan sát hệ quả, tạo dữ liệu mô phỏng và luyện chính sách trong điều kiện ít rủi ro hơn môi trường thật.
Fei-Fei Li phân biệt khá rõ ba lớp chức năng. Renderer làm thế giới nhìn thấy được, ví dụ các hệ thống như Sora hoặc Genie. Simulator làm môi trường 3D có thể chỉnh sửa và thử nghiệm, như Marble. Planner sử dụng mô hình về môi trường để chọn hành động, như V-JEPA 2 hoặc DreamerV3.
Phân loại này giúp tránh một lỗi rất phổ biến: thấy AI tạo video đẹp rồi kết luận nó hiểu vật lý. Video đẹp là năng lực Renderer. Môi trường có thể chỉnh sửa, duy trì quan hệ không gian và phản hồi với tác động mới tiến gần Simulator. Còn Planner phải biết dùng dự báo để chọn hành động theo mục tiêu.
Tôi nghiêng về quan điểm rằng ngành này sẽ không chọn một phe tuyệt đối. Pixel-level generation có ích khi cần quan sát giàu chi tiết, dựng dữ liệu hoặc tạo môi trường. Latent prediction có lợi thế khi cần lập kế hoạch nhanh, bỏ qua chi tiết thừa và tập trung vào động lực học. Vấn đề là phải biết hệ thống của mình cần lớp nào, thay vì mua một demo đẹp rồi gọi nó là World Model.
3. Spatial Intelligence vận hành thế nào: tưởng tượng trước, hành động sau
Điểm đáng giá nhất của World Model không nằm ở việc nó có thể mô tả một căn phòng. Giá trị nằm ở việc nó có thể thử nghiệm nhiều tương lai khả dĩ trước khi động vào căn phòng thật.
Một chu trình ra quyết định điển hình bắt đầu bằng imagined rollouts. Từ trạng thái hiện tại, hệ thống sinh ra các chuỗi hành động có thể thực hiện: tiến lên, lùi lại, nắm vật, đổi góc tay máy, chờ thêm một nhịp. World Model dự đoán điều gì xảy ra với mỗi chuỗi.
Sau đó là surprise quantification. Nếu quan sát thực tế chệch mạnh khỏi dự đoán, hệ thống có tín hiệu rằng môi trường có thứ bất thường: vật cản mới, cảm biến lỗi, lực tác động khác dự kiến hoặc mô hình đang thiếu hiểu biết. “Bất ngờ” ở đây không phải cảm xúc. Nó là khoảng cách giữa dự báo và thực tế, một chỉ báo rủi ro cực kỳ quan trọng.
Cuối cùng, hệ thống tối ưu hành động trong một cửa sổ thời gian ngắn thông qua Model Predictive Control, thường gọi là MPC. Nó không cần cam kết mù quáng với một kế hoạch dài. Nó dự đoán, chọn vài bước tốt nhất, thực hiện bước gần nhất, nhận quan sát mới rồi lập kế hoạch lại. V-JEPA 2 dùng CEM và MPC theo hướng này.
Google DeepMind cũng đưa ra Diffusion Model Predictive Control, hay DMPC, cho bài toán tối ưu chuỗi hành động thời gian thực. Giá trị của các kỹ thuật kiểu này là chúng đẩy AI rời xa phản ứng một phát ăn ngay. Agent không còn lấy hành động đầu tiên nghe hợp lý. Nó phải cân nhắc chuỗi hệ quả.
Một lợi thế khác là factorization, tức phân rã mô hình. Khi tách phần đề xuất hành động khỏi dynamics model mô tả vật lý, đội ngũ có thể huấn luyện lại dynamics model lúc môi trường vật lý thay đổi mà không phải phá bỏ toàn bộ hệ thống đề xuất hành động. Với môi trường luôn thay đổi, đây là một lựa chọn kiến trúc thực dụng.
Tuy vậy, tôi sẽ không dùng từ “tự chủ” quá sớm. Một Agent có rollouts vẫn có thể tưởng tượng sai. Một Planner tốt trên mô phỏng xấu sẽ chọn phương án sai rất tự tin. Đây là lý do bài toán World Models không dừng ở capability. Nó kéo theo một bài toán kiểm chứng dữ dội hơn.
Bài viết về công nghệ bên trong Humanoid Robot đã chạm vào khoảng cách sim-to-real. World Models làm khoảng cách đó dễ quản lý hơn nếu mô phỏng đủ tốt, nhưng chúng không xóa khoảng cách bằng phép màu.
4. Dữ liệu tương tác vật lý mới là mỏ vàng khó khai thác
LLM lớn lên nhờ web. Văn bản, mã nguồn, ảnh và các dấu vết số có thể được thu thập ở quy mô khổng lồ. World Models không có đặc quyền đó.
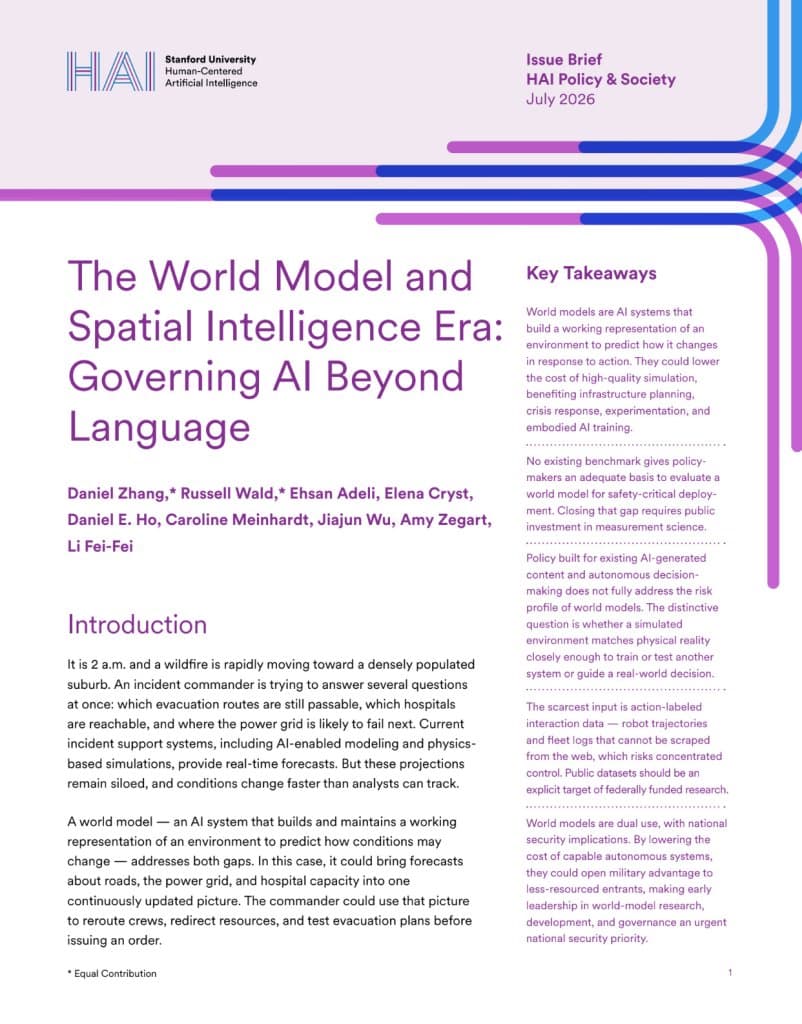
Dữ liệu mà chúng cần là action-labeled interaction data: dữ liệu có trạng thái, hành động, quỹ đạo và kết quả. Ví dụ là quỹ đạo tay máy robot, dữ liệu vận hành của đội xe tự hành, hoặc chuỗi tương tác giữa một tác nhân với môi trường. Stanford HAI cảnh báo đây đang là tài sản khan hiếm và đắt đỏ nhất, bởi bạn không thể đơn giản cào nó từ internet như văn bản.
Đây là chỗ thị trường sẽ phân hóa mạnh. Các công ty có robot đang chạy, đội xe hoạt động, hệ thống cảm biến trong thực địa hoặc hạ tầng vận hành giàu dữ liệu sẽ sở hữu lợi thế rất khó mua bằng tiền. Waymo và Nvidia Alpamayo thường được nhắc tới cùng loại lợi thế đó: dữ liệu xuất phát từ tương tác và vận hành, không phải chỉ từ nội dung được xuất bản.
Startup phần mềm vẫn có cửa, nhưng cửa đó hẹp hơn nhiều so với thời “xây một lớp prompt trên API”. Họ cần chọn một miền hẹp, có dữ liệu riêng, quy trình thu thập dữ liệu rõ ràng và khả năng kiểm chứng đầu ra. Nếu không, họ chỉ đứng ngoài nhìn các công ty nắm phần cứng và dữ liệu thực địa kéo xa khoảng cách.
Tôi nghĩ nhiều doanh nghiệp sẽ đánh giá sai chi phí ở đây. Họ thấy World Model và lập tức hỏi chọn model nào, dùng GPU nào, gọi API nào. Câu hỏi quan trọng hơn là: dữ liệu hành động của bạn ở đâu? Nó có liên kết được giữa trạng thái trước hành động, hành động đã làm và kết quả sau hành động không?
Một doanh nghiệp logistics có thể lưu lịch sử đơn hàng rất kỹ nhưng vẫn không có dữ liệu đủ tốt để mô hình hóa quyết định điều phối, các thay đổi trong mạng lưới và hệ quả vận hành. Một nhà máy có hàng loạt log cảm biến nhưng thiếu nhãn hành động và bối cảnh. Data lake không tự biến thành dữ liệu quỹ đạo.
Đó là lý do tôi vẫn ưu tiên tư duy làm thật trước khi bàn đến kiến trúc hoành tráng. AI thực chiến thường bắt đầu từ một Workflow hẹp có thể quan sát, đo lường và sửa sai. Với World Models, nguyên tắc ấy càng quan trọng: hãy tìm một vòng trạng thái → hành động → trạng thái mới mà doanh nghiệp thực sự kiểm soát được.
5. Yann LeCun và Yoshua Bengio: hai cách dùng World Model rất khác
Điều thú vị là World Models không chỉ tạo tranh luận về kỹ thuật. Nó tách các nhà nghiên cứu theo cách họ nhìn về quyền hành động của AI.
Yann LeCun xem World Model như capability engine cho AI tự chủ. Theo hướng này, muốn có hệ thống thông minh cấp cao, AI phải có mô hình về thế giới, phải lập kế hoạch, phải dự báo và phải học từ hậu quả hành động. Một AI chỉ biết tiếp tục văn bản sẽ không đủ.
Yoshua Bengio nhìn cùng loại năng lực qua lăng kính khác. Ý tưởng “Scientist AI” đặt World Model vào vị trí safety brake: một hệ thống phân tích và kiểm định, không có quyền tự hành động, dùng để phát hiện hoặc phủ quyết các quyết định nguy hiểm của Agent.
Một bên muốn tạo động cơ mạnh hơn. Bên kia muốn lắp phanh độc lập cho chiếc xe đang có động cơ mạnh hơn.
Tôi không thấy đây là hai lựa chọn loại trừ nhau. Sai lầm là để cùng một Agent vừa đề xuất hành động, vừa tự mô phỏng hậu quả, vừa tự xác nhận rằng mô phỏng của nó đáng tin. Đó là cấu trúc tự cấp phép. Với các tác vụ có hậu quả vật lý, nên tách lớp hoạch định, lớp mô phỏng và lớp kiểm định độc lập khi có thể.
Nguyên tắc này gần với điều tôi đã viết trong Khi Sandbox AI Không Còn An Toàn: môi trường đánh giá không phải vật trang trí ở cuối dự án. Khi Agent có thể tác động ra ngoài hệ thống, evaluation là một phần của kiến trúc vận hành.
6. Cảnh báo của Stanford HAI: mô phỏng sai có thể gây hại ngoài đời
Báo cáo Stanford HAI tháng 7/2026 đưa ra cảnh báo mà giới làm sản phẩm rất cần đọc kỹ: World Models mở rộng bề mặt rủi ro từ ngôn ngữ sang thế giới thực.
Rủi ro đầu tiên là Flawed Simulation. Một mô phỏng sai quy luật vật lý hoặc bỏ sót biến số quan trọng có thể dẫn Agent tới quyết định nguy hiểm. Sai lệch đó đặc biệt đáng ngại trong cơ sở hạ tầng, y tế và cứu hỏa khẩn cấp, nơi chi phí của một dự báo sai không phải vài câu trả lời tệ mà là hậu quả ngoài đời.
Điểm nguy hiểm của mô phỏng là nó dễ tạo ảo giác kiểm soát. Một dashboard có bản đồ 3D đẹp, các đường đi trơn tru và điểm số tối ưu có thể khiến lãnh đạo tin rằng hệ thống đã “thử nghiệm mọi thứ”. Thực ra hệ thống chỉ thử nghiệm những gì mô hình của nó biết cách biểu diễn. Những biến số bị bỏ ngoài mô hình sẽ không tự biến mất chỉ vì giao diện trông thuyết phục.
Rủi ro thứ hai là pervasive sensing. Spatial Intelligence cần nhìn và hiểu không gian. Điều đó tạo động lực thu thập dữ liệu 3D rộng khắp bằng cảm biến. Nếu không có giới hạn rõ ràng về mục đích, thời gian lưu trữ, quyền truy cập và khả năng giám sát, hạ tầng phục vụ tự động hóa có thể biến thành hạ tầng theo dõi thường trực.
Rủi ro thứ ba là dual-use. Các tác nhân tự chủ chi phí thấp có khả năng mô phỏng và ra quyết định chiến thuật theo thời gian thực. Công nghệ có thể phục vụ dân sự, nhưng cũng có thể bị dùng cho mục tiêu an ninh quốc phòng. Không thể xử lý chuyện này bằng một tuyên bố đạo đức chung chung.
Stanford HAI nhấn mạnh nhu cầu kiểm định độc lập trước triển khai. Tôi đồng ý, và bổ sung một ý thực dụng: doanh nghiệp phải lưu lại điều kiện mà mô hình được phép hoạt động. Nó được tin ở loại môi trường nào? Điều gì nằm ngoài phạm vi? Khi surprise tăng tới ngưỡng nào thì Agent phải dừng hoặc chuyển sang con người? Không có các ranh giới này, “tự chủ” chỉ là cái tên lịch sự của việc phó mặc.
7. Doanh nghiệp nên nhìn World Models như thế nào?
World Models có ứng dụng vượt khỏi robotics. Bất kỳ bài toán nào có vòng trạng thái → hành động → trạng thái mới đều có thể được mô hình hóa. Chuỗi cung ứng, điều phối vận hành, mô phỏng hành vi khách hàng, quản trị rủi ro an ninh mạng hay phân bổ nguồn lực đều có thể hưởng lợi từ tư duy này.
Nhưng đừng gọi mọi hệ thống dự báo là World Model. Một dashboard dự đoán doanh số không tự nhiên thành mô hình thế giới. Nó chỉ tiệm cận khái niệm này khi có thể biểu diễn trạng thái hệ thống, thử các hành động khác nhau và dự báo hệ quả của từng hành động theo thời gian.
Một kiến trúc hybrid hợp lý có thể chia việc rất rõ. LLM nhận yêu cầu bằng ngôn ngữ tự nhiên, diễn giải mục tiêu cấp cao, truy xuất quy trình và giao tiếp với nhân viên. World Model kiểm tra kế hoạch có khả thi không, mô phỏng các phương án và dự báo hệ quả. Lớp thực thi gọi API hoặc điều phối Workflow. Lớp kiểm định theo dõi sai lệch giữa dự báo và thực tế, có quyền dừng hệ thống khi vượt ngưỡng.
Đây là cách nhìn ít hào nhoáng hơn lời hứa “AI tự vận hành doanh nghiệp”, nhưng đáng tin hơn. Tôi không nghĩ đa số công ty cần xây World Model tổng quát. Họ cần một mô hình đủ tốt cho miền vận hành cụ thể của mình, có dữ liệu đáng tin, có cách đánh giá và có người chịu trách nhiệm khi hệ thống sai.
Thứ cần tránh là lấy một LLM, nối thêm RAG, gọi vài API, rồi tuyên bố Agent đã hiểu quy trình. Nó có thể hiểu tài liệu quy trình. Nó chưa chắc hiểu hệ quả vận hành của hành động đã chọn.
World Models vì thế là bước đi quan trọng hơn rất nhiều so với một chatbot biết nói hay hơn. Nhưng đây cũng là nơi ngành AI phải bớt say mê demo và nghiêm túc với vật lý, dữ liệu, giới hạn mô phỏng và quyền lực của hệ thống tự chủ. Nếu LLM từng buộc doanh nghiệp học cách quản lý câu trả lời sai, World Models sẽ buộc họ học cách quản lý hành động sai.
Câu hỏi thường gặp
World Model khác LLM ở điểm căn bản nào?
LLM dự đoán token tiếp theo dựa trên các mẫu trong dữ liệu ngôn ngữ. World Model dự đoán trạng thái tương lai của một môi trường dựa trên trạng thái hiện tại và hành động cụ thể. LLM có thể nói về một kế hoạch; World Model hướng tới việc thử các hậu quả của kế hoạch ấy trước khi thực hiện.
Tại sao JEPA không muốn dự đoán từng pixel?
Theo hướng JEPA, dự đoán pixel buộc mô hình dành nhiều năng lực cho chi tiết như ánh sáng, bóng đổ hoặc phản xạ, dù những chi tiết đó có thể không quan trọng với quyết định. JEPA dự đoán latent embedding để tập trung vào cấu trúc và biến đổi có ý nghĩa hơn cho lập kế hoạch.
Representation collapse là gì và vì sao nó nguy hiểm?
Representation collapse xảy ra khi mô hình biến nhiều đầu vào khác nhau thành cùng một biểu diễn ẩn, khiến bài toán dự đoán trở nên tầm thường nhưng mô hình không còn phân biệt được trạng thái thực tế. EMA target encoder và SIGG là các hướng kỹ thuật được dùng để ngăn biểu diễn bị sụp như vậy.
Doanh nghiệp không làm robot có nên quan tâm World Models?
Có, nếu doanh nghiệp có chuỗi trạng thái, hành động và hệ quả đủ rõ để mô hình hóa. Ví dụ phù hợp gồm điều phối chuỗi cung ứng, mô phỏng kịch bản vận hành hoặc thử phản ứng an ninh mạng. Doanh nghiệp nên bắt đầu từ một miền hẹp có dữ liệu hành động đáng tin, thay vì cố xây hệ thống tổng quát.
Rủi ro lớn nhất khi triển khai là gì?
Rủi ro lớn nhất là tin vào một mô phỏng sai. Nếu World Model thiếu biến số quan trọng hoặc dự đoán sai động lực của môi trường, Planner có thể tối ưu một kế hoạch nguy hiểm. Vì vậy cần giới hạn phạm vi vận hành, theo dõi sai lệch dự báo và có kiểm định độc lập trước khi cho hệ thống tác động ra thế giới thật.
Nguồn tham khảo: World Models và Trí tuệ Không gian: Khi AI Vượt Ra Ngoài Ngôn Ngữ để Tái Định Hình Thế Giới Thực
Bài viết là góc nhìn cá nhân của tác giả, mang tính tham khảo — không phải tin tức báo chí.
📬 Nhận bài viết mới — miễn phí
Đừng bỏ lỡ bài viết tiếp theo. Đăng ký để nhận trong inbox.

Tác giả
Cường Nguyễn — AI Thực Chiến
Tôi là Cường Nguyễn - Founder của AI Ops Solutions.
Tôi từng là Logistics Operations Manager và đồng sáng lập thương hiệu CATCA - #1 Shopee ngành Pet Care.
10 năm kinh nghiệm Logistics/E-commerce OperationsCo-founder CATCA - #1 Shopee ngành Pet CareMột trong 300+ n8n Verified Creator toàn cầuTư vấn Giải pháp chuyển đổi số bằng AI cho 3 SMEs/quý


