Bài viết
Bài viết cá nhân
AI App Chạy Được Nhưng Chưa Đáng Tin: Evaluation và Observability Là Hạ Tầng Bắt Buộc
👤 cuongnguyen📅 11/08/2026⏱ 18 phút đọc
Trong bài viết này(21 mục)⌄
- AI app chạy được chưa đồng nghĩa với đáng tin
- Vì sao demo đẹp nhưng production vẫn thất bại?
- Observability là nền móng để nhìn thấy hệ thống AI
- RAG trace cần thể hiện điều gì?
- Evaluation đo điều gì mà log thông thường không trả lời được?
- Offline evaluation và online evaluation bổ sung cho nhau
- RAGAS và bộ metric cho RAG đáng tin cậy hơn
- Đừng gộp retrieval quality và generation quality
- LLM-as-a-Judge: đòn bẩy mạnh nhưng không phải chân lý tuyệt đối
- Calibration là hàng rào chống cảm giác an toàn giả
- Từ observability đến CI gate và production alert
- Threshold không phải mục tiêu độc lập
- Kiến trúc evaluation cho RAG, agents và hội thoại nhiều lượt
- Multi-turn cần đánh giá sự nhất quán theo thời gian
- Thiết kế chiến lược triển khai theo ops mindset
- Câu hỏi thường gặp
- RAGAS có thay thế được Langfuse hoặc nền tảng observability không?
- LLM-as-a-Judge có thể đáng tin đến mức nào?
- Làm sao kiểm soát chi phí khi đánh giá production traffic?
- Khi nào một AI app nên bắt đầu triển khai evaluation pipeline?
- Vì sao chỉ chấm final answer là chưa đủ cho AI agent?
AI app chạy được chưa đồng nghĩa với đáng tin
Một ứng dụng AI trả được câu trả lời không chứng minh rằng nó đúng, an toàn hay ổn định khi gặp dữ liệu production. Demo thường diễn ra với prompt sạch, câu hỏi quen thuộc và ngữ cảnh được kiểm soát; còn môi trường thực tế có truy vấn mơ hồ, tài liệu thiếu, dữ liệu cũ, người dùng cố tình khai thác điểm yếu và các tình huống chưa từng xuất hiện trong quá trình phát triển. Khoảng cách giữa một sản phẩm functional và một hệ thống reliable nằm ở năng lực đo lường, điều tra và cải tiến chất lượng có hệ thống.
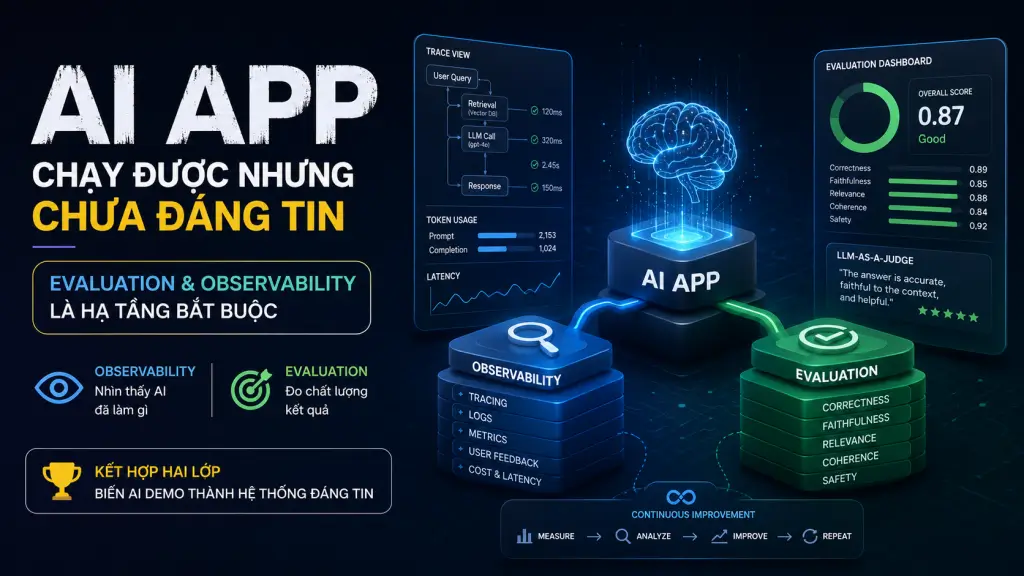
Observability và AI evaluation là hai lớp liên quan chặt chẽ nhưng không thể hoán đổi. Observability trả lời câu hỏi hệ thống đã làm gì: nhận input nào, gọi model nào, truy xuất tài liệu gì, dùng tool ra sao, mất bao lâu và tiêu tốn bao nhiêu token. Evaluation trả lời câu hỏi chất lượng của hành vi đó có đạt tiêu chuẩn hay không: câu trả lời có relevance, faithfulness, đúng định dạng, đúng chính sách và hữu ích với người dùng hay không.
- Functional success: Hệ thống tạo được một response hoặc hoàn tất một lời gọi tool.
- Quality reliability: Response đạt tiêu chí chất lượng đã định nghĩa, có thể kiểm thử lại và có cơ chế phát hiện regression.
- Operational reliability: Đội ngũ nhìn thấy failure mode, chi phí, latency và nguyên nhân của lỗi để hành động.
Một AI app “chạy được” chỉ chứng minh hệ thống có thể trả response; một AI app “đáng tin” phải chứng minh response đó được quan sát, đo lường, kiểm thử và cải tiến liên tục.
Vì sao demo đẹp nhưng production vẫn thất bại?
Trong một pipeline RAG, final answer tệ có thể bắt nguồn từ routing, query extraction, retrieval, reranking, context construction, summarization hoặc generation. Nếu đội ngũ chỉ nhìn câu trả lời cuối cùng, họ chỉ biết người dùng không hài lòng nhưng không biết nên sửa prompt, đổi embedding, điều chỉnh chunking hay cập nhật knowledge base. Đây là lý do một trace sâu có giá trị hơn một log văn bản rời rạc: trace giữ quan hệ nhân quả giữa từng bước và từng phiên bản cấu hình.
Với chatbot doanh nghiệp, kiến trúc retrieval tốt cần đi cùng một cơ chế chứng minh retrieval ấy hoạt động trong thực tế. Bài viết về kiến trúc RAG từ zero đến production là nền tảng hữu ích để hiểu các lớp dữ liệu, retrieval và vận hành; còn evaluation là lớp biến kiến trúc đó thành một hệ thống có thể kiểm soát chất lượng qua từng lần thay đổi.
Observability là nền móng để nhìn thấy hệ thống AI
Trace là đơn vị nền tảng để nối observability với evaluation. Một trace hữu ích cần lưu input, output, các bước trung gian, metadata, latency, token usage, cost, phiên bản model và phiên bản prompt. Trong RAG, những bước trung gian thường gồm query được chuẩn hóa, truy vấn vector database, danh sách chunk được retrieve, kết quả rerank, context đưa vào model và response cuối cùng. Không có chuỗi dữ liệu này, việc debug gần như dựa vào phỏng đoán.
Điểm quan trọng là trace không chỉ dành cho lỗi kỹ thuật như timeout hay HTTP failure. Nó là bằng chứng để phân tích lỗi chất lượng. Một response hallucination có thể xuất hiện dù model hoạt động bình thường, latency thấp và không có exception. Trace cho biết liệu model đã nhận context không liên quan, context thiếu hay một prompt version khiến model suy diễn vượt quá bằng chứng. Vì vậy, observability phải bao phủ cả hành vi semantic lẫn tín hiệu vận hành.
- Input và output: Lưu câu hỏi, response, định dạng đầu ra và dữ liệu tham chiếu cần thiết để đánh giá.
- Intermediate observations: Ghi retrieval, tool call, prompt rendering, reranking và các bước biến đổi quan trọng.
- Metadata phiên bản: Gắn model, prompt, embedding, index hoặc deployment version để khoanh vùng regression.
- Tín hiệu vận hành: Theo dõi latency, token và cost để chất lượng không được tối ưu bằng mọi giá.
RAG trace cần thể hiện điều gì?
Một trace RAG có giá trị điều tra phải làm rõ: người dùng hỏi gì; hệ thống có rewrite query hay không; retrieval lấy những chunk nào; chunk nào bị loại ở reranking; context cuối cùng gồm những gì; model trả lời ra sao. Khi answer relevance thấp, đội ngũ có thể kiểm tra retrieval relevance. Khi câu trả lời có vẻ hợp lý nhưng không được hỗ trợ bởi tài liệu, họ kiểm tra faithfulness và context completeness. Đây là cách tách lỗi retrieval khỏi lỗi generation thay vì sửa toàn bộ pipeline một cách mù quáng.

Evaluation đo điều gì mà log thông thường không trả lời được?
Log có thể nói model đã trả về 200 OK, nhưng không thể tự trả lời liệu nội dung có correctness, relevance, faithfulness hay safety hay không. Evaluation biến tiêu chuẩn sản phẩm thành phép đo. Tuy nhiên, không tồn tại một metric phổ quát cho mọi ứng dụng. Trợ lý pháp lý, chatbot hỗ trợ khách hàng, hệ thống trích xuất JSON và agent thực hiện nghiệp vụ cần những tiêu chí khác nhau, được ràng buộc bởi hậu quả thực tế của failure mode.
Đánh giá tốt bắt đầu từ việc mô tả rõ thế nào là “tốt” trong từng use case. Với hệ thống tạo cấu trúc dữ liệu, JSON parseability hoặc schema validation có thể quan trọng hơn văn phong. Với RAG, câu trả lời cần liên quan đến câu hỏi nhưng đồng thời phải trung thành với context. Với agent, final answer hay không đủ vì agent có thể dùng sai tool, truyền sai arguments hoặc đi qua một trajectory không an toàn trước khi tình cờ tạo kết quả đúng.
- Correctness: Kết quả phù hợp đáp án, business rule hoặc sự thật được cho phép dùng làm chuẩn.
- Faithfulness: Câu trả lời chỉ dựa trên bằng chứng trong context, không bịa thêm thông tin.
- Relevance: Nội dung giải quyết đúng ý định người dùng thay vì chỉ có vẻ liên quan.
- Safety: Response tôn trọng chính sách, giới hạn nghiệp vụ và yêu cầu bảo mật.
Offline evaluation và online evaluation bổ sung cho nhau
Offline evaluation chạy trên dataset trước khi release để so sánh prompt, model, chunking hoặc chiến lược retrieval trong điều kiện lặp lại được. Nó phù hợp để phát hiện regression trước khi thay đổi đến tay người dùng. Langfuse minh họa experiment với chunk size 128, 256, 512 kết hợp overlap 0, 64, 128 hoặc 256. Trong ví dụ chỉ gồm 2 dataset items, cấu hình chunk size 256 và overlap 0 có average relevance score cao nhất; đó chỉ là minh họa quy trình, không phải benchmark tổng quát.
Online evaluation chạy trên production traces để phát hiện model drift, input bất ngờ và failure mode mới. Offline dataset luôn có nguy cơ lạc hậu so với hành vi thật của người dùng; ngược lại, production chỉ cho biết hiện tượng đang diễn ra chứ không mặc định cho phép so sánh kiểm soát. Vòng lặp đúng là đưa những trace lỗi quan trọng từ production vào dataset, gắn nhãn, rồi dùng chúng làm regression test cho experiment kế tiếp.
Offline evaluation bảo vệ lần release tiếp theo; online evaluation phát hiện thực tế mà dataset cũ chưa từng đại diện.
RAGAS và bộ metric cho RAG đáng tin cậy hơn
RAGAS cung cấp các metric chuyên biệt cho RAG, nhưng không thay thế nền tảng observability. RAGAS giúp trả lời câu hỏi chất lượng retrieval và generation; observability giữ trace, context, phiên bản prompt/model, latency, cost và bằng chứng để điều tra tại sao điểm số thay đổi. Hai lớp kết hợp giúp đội ngũ không chỉ thấy điểm thấp mà còn truy ngược được cấu hình, dữ liệu và bước xử lý gây ra điểm thấp đó.
Nhóm metric RAGAS gồm Context Precision, Context Recall, Context Entities Recall, Noise Sensitivity, Response Relevancy và Faithfulness. Context Precision hỏi liệu các tài liệu retrieve có thực sự hữu ích hay không. Context Recall xem context có bao phủ bằng chứng cần để trả lời không. Response Relevancy đánh giá câu trả lời có bám sát câu hỏi không; Faithfulness đánh giá câu trả lời có được căn cứ trên context hay không. Việc tách những dimensions này tránh kết luận sai rằng “model tệ” khi vấn đề thực ra là retrieval.
- Context Precision: Đo mức hữu ích và liên quan của context được đưa vào pipeline.
- Context Recall: Kiểm tra evidence cần thiết có được retrieval mang về hay không.
- Noise Sensitivity: Phát hiện mức độ câu trả lời bị ảnh hưởng bởi context nhiễu.
- Faithfulness: Kiểm tra response có vượt ra ngoài các tài liệu được cung cấp không.
Đừng gộp retrieval quality và generation quality
Một answer sai có thể do tài liệu đúng không được retrieve, do context đúng nhưng bị cắt mất, hoặc do model bỏ qua context. Nếu chỉ dùng một điểm cuối cùng, đội ngũ không biết nên sửa chunk strategy, reranker hay prompt. Thay vào đó, hãy gắn metric vào failure mode: retrieval relevance cho chunk; context completeness cho evidence; faithfulness cho grounding; answer relevance cho mức độ giải quyết câu hỏi. Cấu trúc này giúp mỗi metric dẫn đến một hành động kỹ thuật cụ thể.
Với agent và tool-use, đánh giá cần vượt ra ngoài RAG. RAGAS liệt kê Topic Adherence, Tool Call Accuracy, Tool Call F1 và Agent Goal Accuracy. Một agent có thể trả lời nghe thuyết phục nhưng thực hiện sai workflow, chọn công cụ không phù hợp hoặc truyền arguments gây hậu quả nghiệp vụ. Đó là lý do các đội xây dựng agent, bao gồm kiến trúc multi-agent và MCP, nên xem evaluation trajectory là phần của thiết kế chứ không phải lớp kiểm tra thêm sau cùng.
LLM-as-a-Judge: đòn bẩy mạnh nhưng không phải chân lý tuyệt đối
Code evaluator phù hợp với tiêu chí có thể xác định bằng logic: JSON parseability, schema validation, regex, exact match, tool-call assertion và business rules. Theo thông tin Langfuse cập nhật tháng 7/2026, code evaluator chạy trong môi trường không có network access và phải hoàn tất trong 2 giây. Đây là lựa chọn đáng ưu tiên khi tiêu chuẩn có thể diễn đạt một cách deterministic vì chi phí, tốc độ và khả năng giải thích thường tốt hơn semantic judge.
LLM-as-a-Judge phù hợp với những thuộc tính khó quy thành luật cứng như helpfulness, faithfulness, relevance hoặc toxicity. Judge có thể chấm từng retrieved chunk theo mức liên quan rồi tính average relevance score. Song judge không phải thước đo khách quan tuyệt đối: prompt judge mơ hồ, rubric thiếu ranh giới, context quá dài hay thay model judge đều có thể làm kết quả biến động. Mọi điểm số semantic đều cần được đọc trong bối cảnh rubric, sample và calibration.
- Ưu tiên code evaluator: Khi có schema, exact match, regex, assertion hoặc business rule rõ ràng.
- Dùng LLM-as-a-Judge: Khi cần đánh giá ngữ nghĩa, tính hữu ích, độ liên quan hoặc mức độ bám chứng cứ.
- Yêu cầu structured output: Judge nên trả score, lý do và nhãn theo cấu trúc để có thể audit.
- Calibration: So sánh judge với các mẫu được human reviewer đánh giá trước khi dùng làm gate.
Calibration là hàng rào chống cảm giác an toàn giả
Langfuse cho biết các judge mạnh có thể đạt 80–90% agreement với human reviewers trên nhiều tiêu chí. Đây là thông tin do chính Langfuse cung cấp, không phải lời bảo đảm cho mọi domain. Một judge được calibration tốt trên FAQ bán lẻ vẫn có thể đánh giá kém trong hồ sơ y tế, quy trình tài chính hay chính sách nội bộ có ngoại lệ dày đặc. Đội ngũ cần lấy mẫu human annotation, so sánh bất đồng, tinh chỉnh rubric và theo dõi judge drift khi đổi model hoặc thay đổi dữ liệu.
Chi phí là phần thường bị bỏ quên. Langfuse ước tính một lần đánh giá bằng LLM-as-a-Judge thường tốn 0,01–0,10 USD, phụ thuộc model judge và kích thước input. Judge call còn phát sinh token và latency. Ba đòn bẩy quan trọng là sampling, chỉ chấm observation cần thiết thay vì toàn bộ trace, và dùng model rẻ hơn cho tiêu chí đơn giản. Ví dụ, đánh giá bất đồng bộ trên 5% observations phù hợp có thể tạo tín hiệu đủ hữu ích trong khi kiểm soát ngân sách tốt hơn chấm toàn bộ traffic.

Từ observability đến CI gate và production alert
Quy trình trưởng thành không bắt đầu bằng hàng chục dashboard. Nó bắt đầu bằng error analysis: đọc trace lỗi, phân loại failure mode và chọn metric có khả năng dẫn đến hành động. Nếu nhiều câu hỏi thất bại vì tài liệu không được retrieve, ưu tiên Context Recall hoặc retrieval relevance. Nếu output sai schema, dùng deterministic validation. Nếu câu trả lời đúng kiến thức nhưng không giải quyết nhu cầu, đánh giá answer relevance hoặc helpfulness bằng rubric đã calibration.
Mỗi trace lỗi có giá trị nên được biến thành một test case. Từ đó hình thành golden dataset gồm các tình huống đại diện và khó; sau đó có thể mở rộng bằng synthetic dataset, nhưng không nên để dữ liệu tổng hợp thay thế hoàn toàn lỗi thực tế. Dataset cần phiên bản hóa và phải phản ánh production. Dataset lỗi thời có thể tạo offline score đẹp trong khi người dùng vẫn gặp các failure mode mới.
- Release gate: Đặt threshold cho metric quan trọng trước khi prompt, model hoặc retrieval configuration được phát hành.
- Experiment: So sánh biến thể trong cùng dataset để tìm trade-off giữa chất lượng, latency và cost.
- Production alert: Cảnh báo khi metric chất lượng, latency hoặc cost thay đổi vượt ngưỡng vận hành đã chọn.
- Feedback loop: Biến failure production thành item được gắn nhãn và kiểm thử lại ở release sau.
Không nên chặn release bằng một điểm số đơn lẻ chưa được calibration; release gate cần gắn với failure mode có hậu quả rõ ràng và bằng chứng trace có thể kiểm tra.
Threshold không phải mục tiêu độc lập
Một threshold chỉ hữu ích nếu nó liên hệ với rủi ro sản phẩm. Chẳng hạn, một điểm faithfulness giảm có thể nghiêm trọng hơn một thay đổi nhỏ về văn phong trong chatbot dùng knowledge base nội bộ. Ngược lại, với workflow tạo JSON cho hệ thống downstream, schema validity có thể là điều kiện bắt buộc. Hãy kết hợp hard gate cho lỗi deterministic và safety-critical với trend monitoring cho metric semantic có tính biến động.
Kiến trúc evaluation cho RAG, agents và hội thoại nhiều lượt
Với RAG, kiến trúc evaluation nên tách ít nhất hai lớp: retrieval quality và generation quality. Retrieval được chấm theo relevance, precision, recall hoặc completeness của context. Generation được chấm theo faithfulness, answer relevance và các yêu cầu domain-specific. Trace phải giữ mapping giữa câu hỏi, chunks, context cuối và response để mọi điểm thấp đều có đường điều tra. Không có intermediate inputs/outputs, việc chấm điểm và debug mất phần lớn giá trị.
Với agents, đối tượng đánh giá là trajectory, không chỉ final answer. Agent có chọn đúng tool không, arguments có đúng không, thứ tự tool call có hợp lý không, có dừng đúng lúc không và task có hoàn thành không? Một agent có thể vô tình cho final answer đúng trong một phiên nhưng trajectory sai vẫn là rủi ro khi workflow chạm vào dữ liệu, giao dịch hoặc hành động bên ngoài. Bài phân tích AI Agents, multi-agent orchestration và MCP cung cấp thêm bối cảnh để đặt tool-call observability vào kiến trúc agent thực tế.
- RAG: Chấm query, retrieved chunks, context completeness, faithfulness và final answer relevance.
- Agent: Chấm tool choice, arguments, tool-call accuracy, trajectory và agent goal accuracy.
- Multi-turn: Chấm coherence, memory, bám ngữ cảnh và khả năng đi đến resolution thay vì chỉ một lượt trả lời.
- Workflow nghiệp vụ: Gắn evaluator với business rules để phát hiện hành vi đúng ngôn ngữ nhưng sai quy trình.
Multi-turn cần đánh giá sự nhất quán theo thời gian
Hội thoại nhiều lượt đặt ra câu hỏi khác với single-turn: agent có nhớ đúng thông tin người dùng đã cung cấp không, có mâu thuẫn với câu trả lời trước không, có bám chủ đề không và có tiến tới resolution không? Một final answer riêng lẻ có thể tốt, nhưng toàn bộ phiên vẫn thất bại nếu hệ thống quên ràng buộc quan trọng hoặc lặp lại câu hỏi đã được trả lời. Do đó trace cần có session context, turn sequence và metadata đủ để evaluator xem xét hành vi xuyên suốt hội thoại.
Thiết kế chiến lược triển khai theo ops mindset
Lộ trình thực tế là bắt đầu từ observability, phân tích lỗi, thiết lập automated evaluators, xây testing foundation, mở rộng synthetic datasets, chạy experiments rồi monitor production qua dashboard và alert. Không cần mở đầu bằng mọi metric có thể có. Hãy chọn 3–5 metric quan trọng nhất, liên kết trực tiếp với failure mode phổ biến và có owner chịu trách nhiệm. Một dashboard nhiều điểm số nhưng không ai biết phải sửa gì sẽ trở thành chi phí thay vì năng lực vận hành.
Nên phân tầng evaluator. Tầng đầu là deterministic checks cho schema, policy, exact match và business rule. Tầng tiếp theo là semantic metrics hoặc LLM-as-a-Judge cho relevance, faithfulness và helpfulness. Tầng cuối là human review theo sampling hoặc với các case có rủi ro cao. Cách này tối ưu chi phí, giảm phụ thuộc vào judge và làm rõ tiêu chí nào là bắt buộc tuyệt đối, tiêu chí nào cần diễn giải theo ngữ cảnh.
- Chọn metric có hành động: Mỗi metric phải liên hệ với một owner, một quyết định hoặc một hướng cải tiến cụ thể.
- Quản trị dữ liệu: Xác định dữ liệu nào được đưa vào trace, retention bao lâu và ai có quyền truy cập.
- Kiểm soát chi phí: Sampling evaluation, chọn observation đúng và dùng model judge phù hợp độ phức tạp.
- Quản trị thay đổi: Gắn prompt, model, dataset và evaluator version vào experiment để kết quả có thể tái lập.
Cuối cùng, AI evaluation và observability không phải phụ kiện LLMOps chỉ dành cho đội lớn. Chúng là cơ chế biến sự không chắc chắn của hệ thống sinh ngôn ngữ thành rủi ro có thể quan sát và quản trị. Khi trace đủ sâu, metric gắn đúng failure mode, judge được calibration, release có gate và production có alert, đội ngũ mới có thể cải tiến dựa trên bằng chứng thay vì dựa trên cảm giác từ vài cuộc demo thành công.
Câu hỏi thường gặp
RAGAS có thay thế được Langfuse hoặc nền tảng observability không?
Không. RAGAS cung cấp metric chuyên biệt như Context Precision, Context Recall, Noise Sensitivity, Response Relevancy và Faithfulness để đo chất lượng RAG. Một nền tảng observability giữ trace, context, prompt/model version, latency, token, cost và liên kết giữa các bước xử lý. RAGAS giúp biết điểm chất lượng; observability giúp biết điểm đó được tạo ra từ pipeline nào, dữ liệu nào và thay đổi nào.
LLM-as-a-Judge có thể đáng tin đến mức nào?
Judge hữu ích khi rubric rõ, output có cấu trúc và được calibration bằng mẫu human annotation. Langfuse cho biết judge mạnh có thể đạt 80–90% agreement với human reviewers trên nhiều tiêu chí, nhưng con số này không tự động áp dụng cho mọi domain. Đội ngũ cần đo disagreement trong domain của mình, kiểm tra các case rủi ro cao và theo dõi tác động khi đổi model judge, prompt judge hoặc dữ liệu đầu vào.
Làm sao kiểm soát chi phí khi đánh giá production traffic?
Không nhất thiết phải chấm toàn bộ traffic. Ba đòn bẩy chính là sampling, chỉ đánh giá observation quan trọng thay vì toàn bộ trace, và dùng model rẻ hơn cho tiêu chí đơn giản. Langfuse ước tính một LLM-as-a-Judge evaluation thường tốn 0,01–0,10 USD; vì vậy hãy chạy deterministic evaluator trước, dùng judge bất đồng bộ khi phù hợp và lấy mẫu như 5% observations nếu mức phủ đó đủ tạo tín hiệu vận hành.
Khi nào một AI app nên bắt đầu triển khai evaluation pipeline?
Nên bắt đầu ngay khi ứng dụng có use case thực, dù dataset ban đầu còn nhỏ. Bước đầu không phải xây hệ thống phức tạp mà là ghi trace đầy đủ, xác định 3–5 failure mode gây hậu quả lớn, tạo một golden dataset nhỏ và tự động hóa các kiểm tra deterministic. Đợi đến khi production có nhiều lỗi mới triển khai evaluation thường khiến đội ngũ mất lịch sử trace cần thiết để hiểu và tái tạo vấn đề.
Vì sao chỉ chấm final answer là chưa đủ cho AI agent?
Final answer không phản ánh toàn bộ hành vi. Agent có thể chọn sai tool, truyền sai arguments, gọi công cụ theo thứ tự không hợp lý hoặc vi phạm business rule nhưng vẫn tình cờ tạo ra câu trả lời nghe hợp lý. Với agent, cần đánh giá trajectory bằng Tool Call Accuracy, Tool Call F1, Topic Adherence và Agent Goal Accuracy, đồng thời lưu trace đầy đủ để kiểm tra từng quyết định trong workflow.
Nguồn tham khảo: AI App Chạy Được Nhưng Không Đáng Tin: Vì Sao Evaluation Và Observability Là Hạ Tầng Bắt Buộc?
Bài viết là góc nhìn cá nhân của tác giả, mang tính tham khảo — không phải tin tức báo chí.
📬 Nhận bài viết mới — miễn phí
Đừng bỏ lỡ bài viết tiếp theo. Đăng ký để nhận trong inbox.

Tác giả
Cường Nguyễn — AI Thực Chiến
Tôi là Cường Nguyễn - Founder của AI Ops Solutions.
Tôi từng là Logistics Operations Manager và đồng sáng lập thương hiệu CATCA - #1 Shopee ngành Pet Care.
10 năm kinh nghiệm Logistics/E-commerce OperationsCo-founder CATCA - #1 Shopee ngành Pet CareMột trong 300+ n8n Verified Creator toàn cầuTư vấn Giải pháp chuyển đổi số bằng AI cho 3 SMEs/quý


