Bài viết
Bài viết cá nhân
Chatbot đã chết, AI Agent lên ngôi: 3 quy trình SME nên giao cho agent
👤 cuongnguyen📅 09/10/2026⏱ 23 phút đọc
Trong bài viết này(33 mục)⌄
- Chatbot và AI Agent khác nhau ở đâu: không phải tên gọi mà là vòng lặp hành động
- Chatbot trả lời một lượt, Agent chạy vòng lặp plan-act-observe
- Workflow và Agent theo cách gọi của Anthropic: ai điều khiển đường đi
- Vì sao một câu hỏi “đặt lịch giúp tôi” lộ rõ khoảng cách
- Vì sao phần lớn “AI agent” của SME thực ra vẫn là chatbot có vỏ bọc
- Con số 71%, 9% và 10%: khoảng trống giữa tên gọi và thực tế
- Vấn đề là triển khai, không phải nền tảng
- Workflow 1: Lọc lead và phân loại email — việc nhàm chán nhưng có giá trị
- Kiến trúc: nhận email, chấm điểm, định tuyến, ghi CRM
- Ranh giới: agent đề xuất, rule quyết định, người duyệt khi tiền hoặc rủi ro lớn
- Workflow 2: Chăm sóc khách 24/7 — nơi ROI rõ nhất và rủi ro cao nhất
- Tra cứu đơn hàng và trạng thái: agent tự xử lý được
- Hoàn tiền và khiếu nại: ngưỡng tự động và điểm chuyển giao cho người
- Workflow 3: Tổng hợp báo cáo tự động — điểm khởi đầu ít rủi ro nhất
- Chế độ chỉ đọc (read-only) trong 2–4 tuần đầu
- Kiểm chứng số liệu: mỗi con số phải truy được về nguồn
- Khi nào agent thật sự hơn, và khi nào nó vẫn là đồ chơi
- Bốn điều kiện để agent đáng giá hơn workflow cố định
- Dấu hiệu cảnh báo: đồ chơi trá hình dưới nhãn agent
- Kiến trúc tối thiểu và lộ trình 90 ngày cho SME
- Tool-RAG, MCP và guardrail: max iterations, budget token, nhật ký audit
- Lộ trình 4 pha: đánh giá quy trình, prototype chỉ đọc, bật ghi có duyệt, mở rộng
- Chi phí thật: token chỉ là một phần của tổng chi phí sở hữu
- Công thức tổng chi phí: API, xây dựng, giám sát, bảo trì, chi phí lỗi
- Ví dụ tính toán với 1.500 lead mỗi tháng và giả định đơn giá minh họa
- Cách đo ROI trung thực: đối chứng thay vì cảm giác
- Baseline và nhóm đối chứng: đo trước khi bật agent
- Chỉ số nên theo dõi và cảnh báo khi đọc số liệu của vendor
- Câu hỏi thường gặp
- Khi nào SME nên dùng AI agent thay vì chatbot?
- Vì sao agent đốt tiền bất ngờ và cách chặn?
- Có nên cho agent quyền gửi email hoặc hoàn tiền cho khách không?
- Multi-agent có cần thiết cho SME không?
Tóm tắt cốt lõi: AI agent so với chatbot không phải cuộc đua đặt tên mà là khác biệt về cấu trúc: chatbot trả lời một lượt, agent tự điều khiển vòng lặp gọi tool đến khi nhiệm vụ hoàn thành. Khảo sát enterprise 2026 cho thấy 71% doanh nghiệp chỉ có 1–25% agent làm được việc nhiều bước thật — vấn đề nằm ở triển khai, không phải nền tảng. Bài viết chỉ ra 3 quy trình SME nên giao cho agent (lọc lead, chăm sóc khách có ngưỡng hoàn tiền, báo cáo read-only), kèm kiến trúc guardrail, bài toán tổng chi phí sở hữu và lộ trình 90 ngày đo bằng nhóm đối chứng.
Năm 2026, gần như mọi nhà cung cấp đều gắn nhãn AI agent lên sản phẩm của mình. Nhưng phần lớn cái được bán vẫn là chatbot trả lời theo kịch bản, khoác áo giao diện mới. Sự dịch chuyển thật — từ hệ thống trả lời sang hệ thống hành động — đang diễn ra ở tầng kiến trúc và quy trình vận hành, không phải ở nhãn dán trên hộp. Với SME, câu hỏi đúng không phải là “mua agent hay mua chatbot”, mà là: quy trình nào trong doanh nghiệp tôi có đủ tool rõ ràng, tiêu chí thành công đo được và điểm dừng an toàn để giao cho một vòng lặp tự chủ? Bài viết này trả lời bằng ba quy trình cụ thể, một bảng so sánh chi phí thẳng thắn và lộ trình 90 ngày.
Chatbot và AI Agent khác nhau ở đâu: không phải tên gọi mà là vòng lặp hành động
Chatbot trả lời một lượt, Agent chạy vòng lặp plan-act-observe
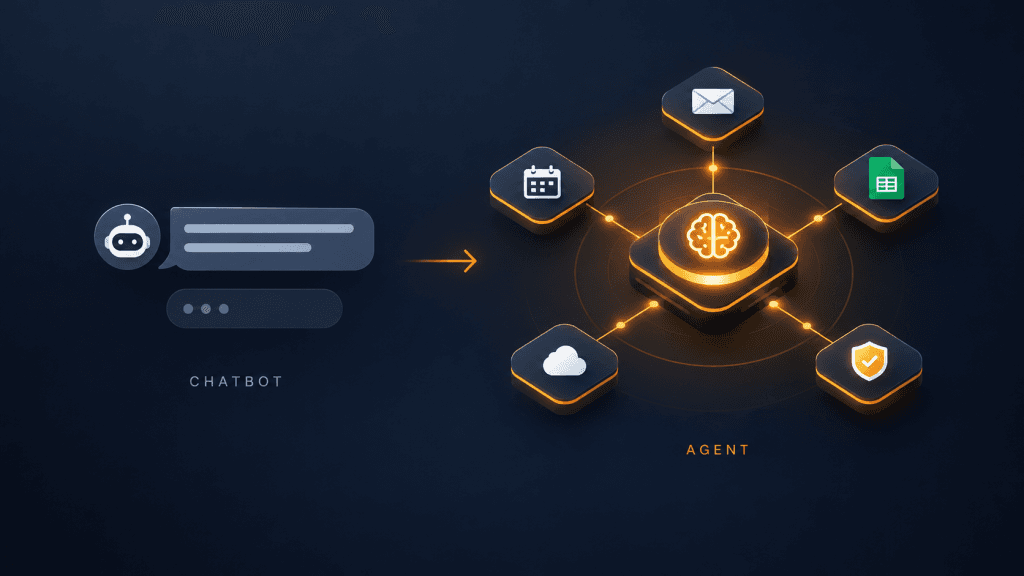
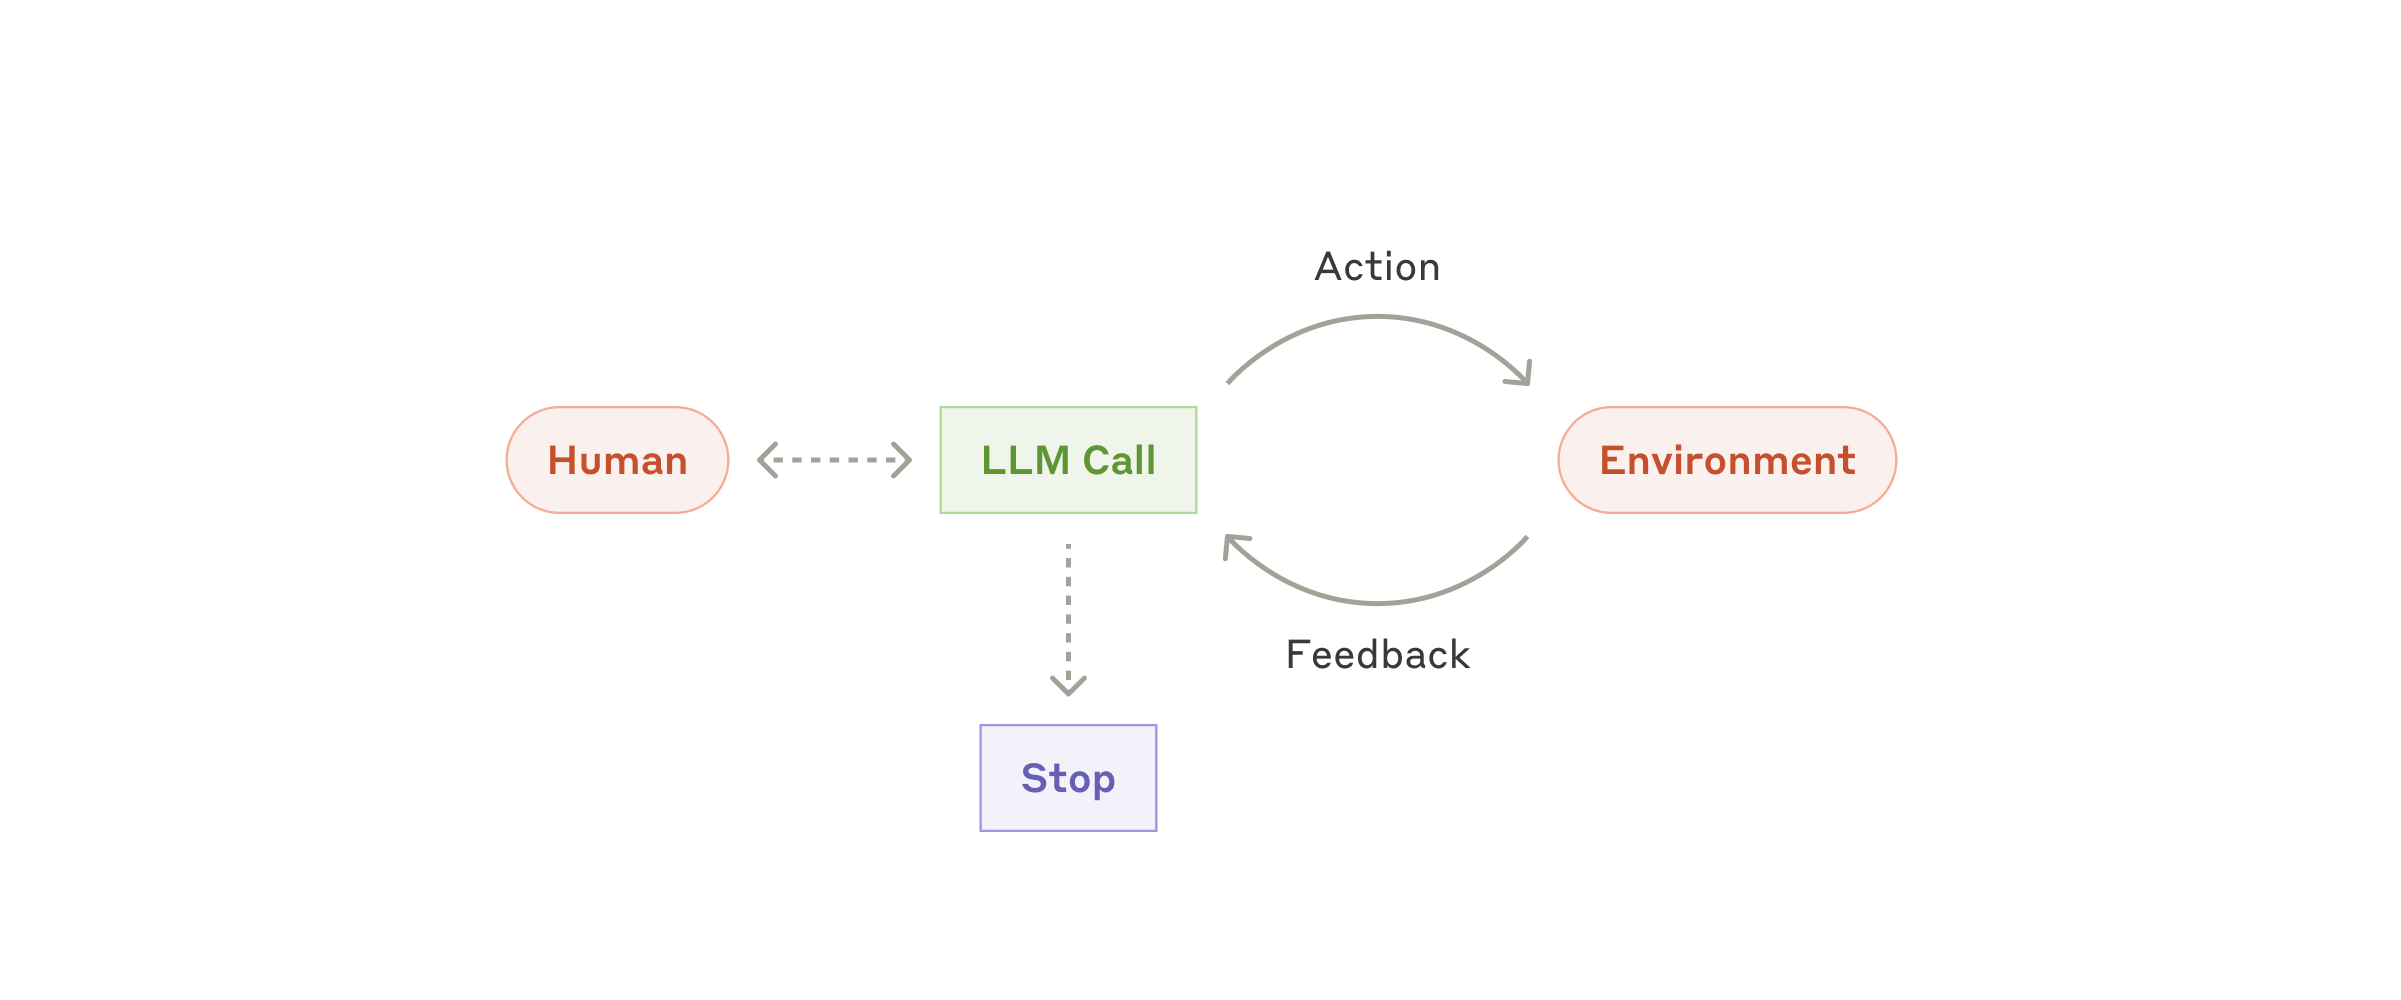
Chatbot truyền thống chạy một lượt: nhận câu hỏi, truy hồi tài liệu (nếu có RAG), sinh câu trả lời, kết thúc. Không trạng thái, không hành động trên hệ thống thật, không hậu quả phải chịu trách nhiệm — mọi việc sau câu trả lời vẫn nằm ở con người. AI agent khác ở cấu trúc: nó chạy vòng lặp plan–act–observe — lập kế hoạch, chọn tool, gọi API thật (tra cứu đơn hàng, ghi CRM, đặt lịch), quan sát kết quả từ môi trường, rồi quyết định bước tiếp theo, lặp lại cho đến khi nhiệm vụ hoàn thành hoặc chạm giới hạn. Nói cho gọn: agent là LLM dùng tool dựa trên phản hồi môi trường trong một vòng lặp. Đơn vị đo của hai thứ cũng khác nhau: chatbot đo bằng độ chính xác câu trả lời, agent đo bằng tỷ lệ nhiệm vụ hoàn thành không cần người.
Workflow và Agent theo cách gọi của Anthropic: ai điều khiển đường đi
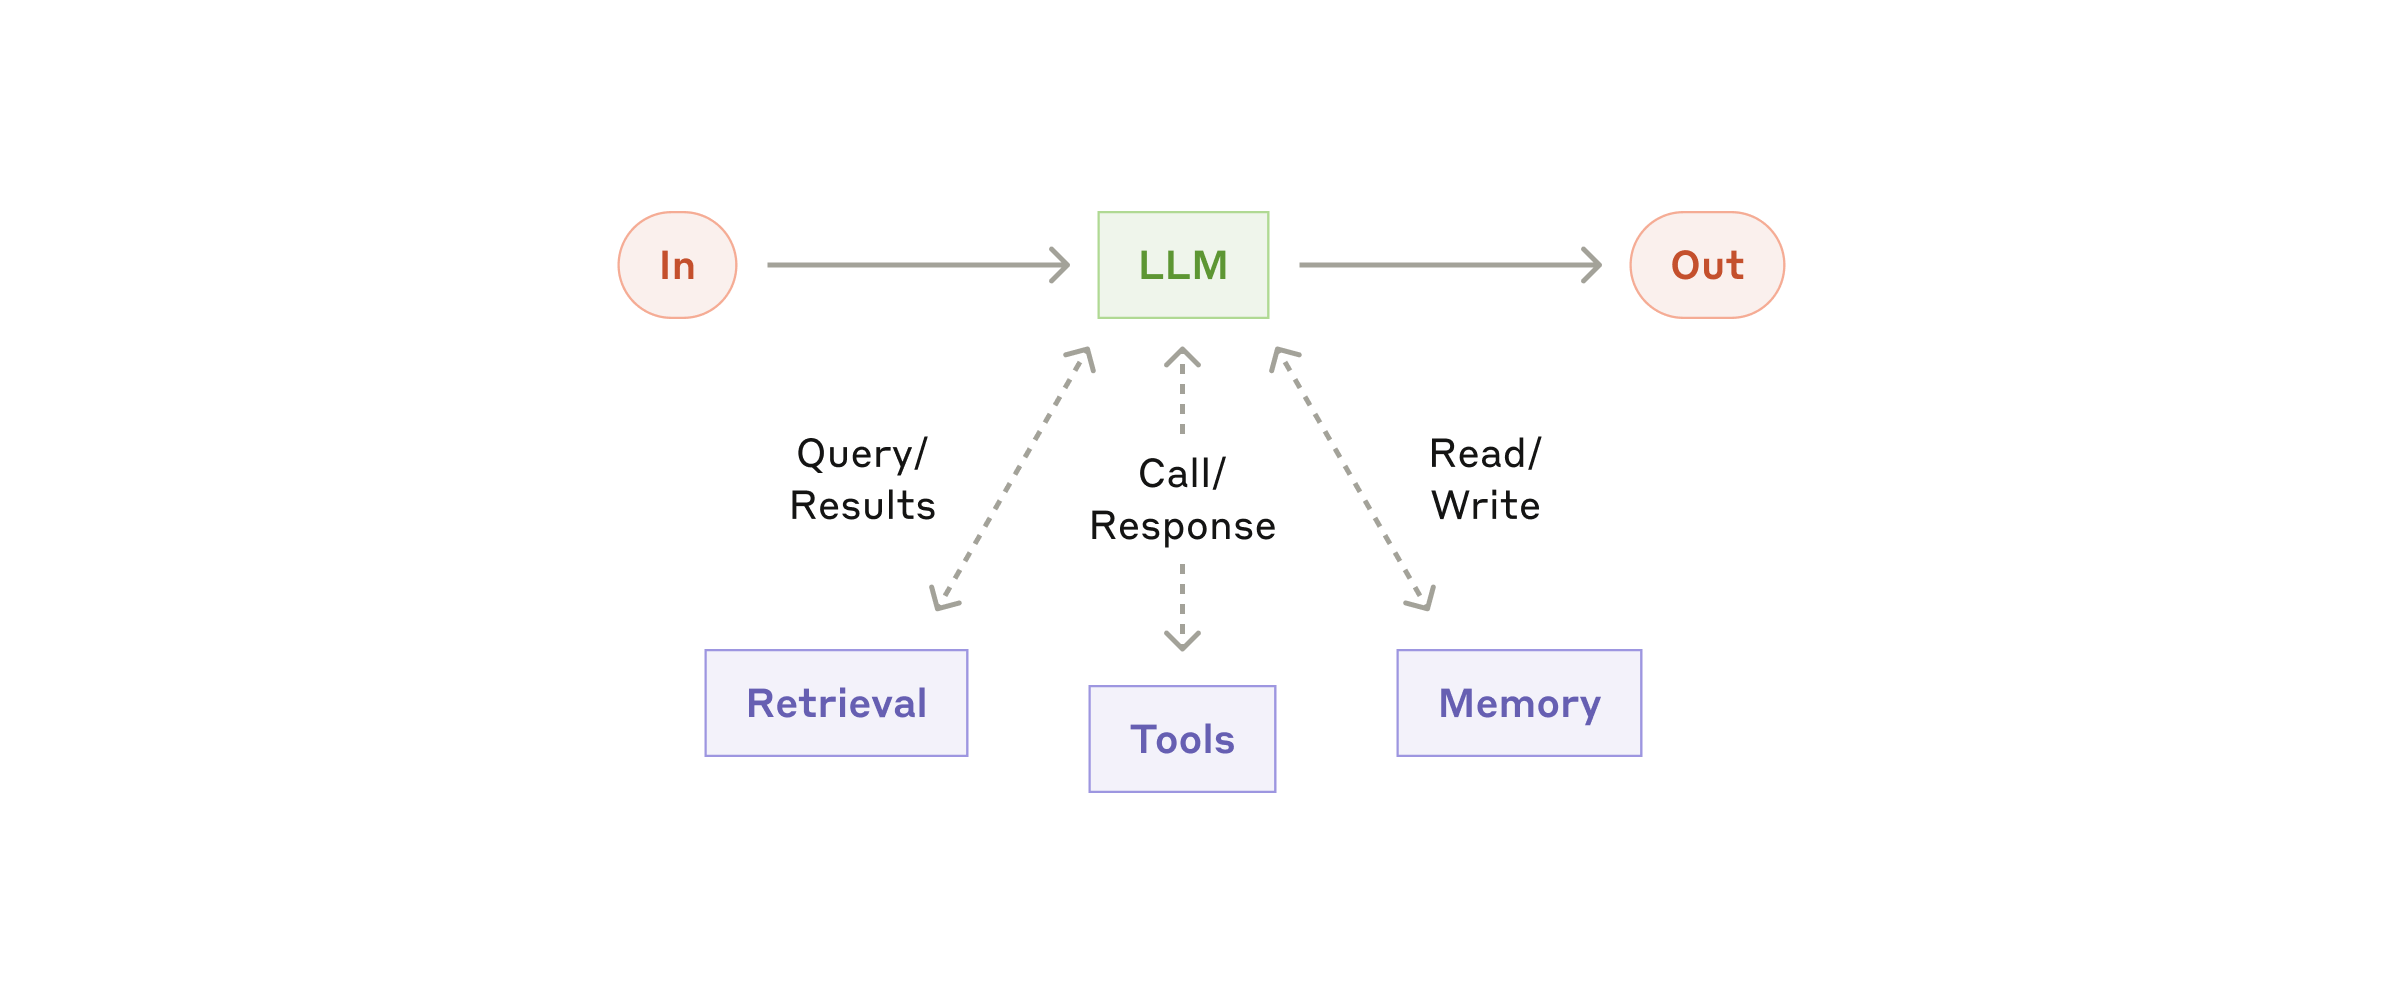
Tài liệu Building Effective Agents của Anthropic đưa ra ranh giới kỹ thuật rõ nhất tôi từng đọc: workflow là hệ thống LLM và tool được điều phối qua code path định sẵn; agent là hệ thống mà LLM tự điều khiển quy trình và cách dùng tool, giữ quyền kiểm soát cách hoàn thành nhiệm vụ. Điểm đáng chú ý nhất của tài liệu này là sự tiết chế: Anthropic khuyến nghị bắt đầu với thứ đơn giản nhất và chỉ tăng độ phức tạp khi nó demonstrably improves outcomes — cải thiện kết quả đo được. Agent đánh đổi độ trễ và chi phí lấy hiệu năng tác vụ, và rủi ro lớn nhất là lỗi cộng dồn: một bước sai làm đầu vào của bước sau sai theo.
Nguyên tắc tôi áp dụng cho mọi dự án agent: nếu một chuỗi bước cố định giải được bài toán, đừng thêm vòng lặp tự chủ. Tự chủ là chi phí, không phải phần thưởng.
Giữa hai thái cực đó là các pattern trung gian: prompt chaining (chuỗi bước nối tiếp), routing (định tuyến câu đơn giản sang model rẻ, câu khó sang model mạnh), parallelization (chạy song song), orchestrator-workers và evaluator-optimizer (một LLM làm, một LLM kiểm). SME nên đi qua các pattern này theo thứ tự trước khi nghĩ đến agent tự chủ hoàn toàn.
Vì sao một câu hỏi “đặt lịch giúp tôi” lộ rõ khoảng cách
Lấy ví dụ khách gửi email: “Đặt lịch giúp tôi cuộc gọi demo vào tuần sau.” Chatbot trả lời: “Anh vui lòng đặt lịch tại đường link này” — nhiệm vụ được chuyển lại cho khách. Agent nối với hệ thống thật sẽ: đọc email, gọi API lịch trống, xử lý xung đột múi giờ, đặt slot, gửi xác nhận, ghi sự kiện vào CRM, rồi báo sales. Cùng một câu hỏi, hai mức giá trị hoàn toàn khác nhau. Khoảng cách này không nằm ở model ngôn ngữ — mà nằm ở việc ai hoàn thiện công việc: con người, hay hệ thống.
Vì sao phần lớn “AI agent” của SME thực ra vẫn là chatbot có vỏ bọc
Con số 71%, 9% và 10%: khoảng trống giữa tên gọi và thực tế
Khi so sánh AI agent so với chatbot trên thị trường, dữ liệu cho thấy khoảng trống giữa tên gọi và thực tế lớn đến bất ngờ. Theo bản phân tích của Webie Vietnam trích khảo sát enterprise agentic AI 2026 (VentureBeat dẫn): 71% doanh nghiệp cho biết chỉ 1–25% số “agent” đang triển khai thực hiện được công việc nhiều bước thật sự; 9% thừa nhận chúng chỉ là chatbot bọc vỏ; chỉ 10% đã vượt nửa đường tới độ phức tạp của agent thật. Nguy hiểm hơn về mặt vận hành: 27% tổ chức không thể dừng agent đang chạy sai theo thời gian thực, và 35% lo ngại bị khóa nhà cung cấp.
Vấn đề là triển khai, không phải nền tảng
Khoảng 81% triển khai nằm trên nền tảng của ba nhà cung cấp lớn — Anthropic (40%), Microsoft (18%), OpenAI (13%) — tức là gần như ai cũng dùng nền tảng tốt. Nếu nền tảng không phải vấn đề, thì cái gì mới là? Câu trả lời nằm ở lớp triển khai: agent không tự sinh ra từ việc mua nền tảng đắt tiền. Một agent làm được việc nhiều bước thật cần đủ ba thứ mà khảo sát cho thấy phần lớn doanh nghiệp còn thiếu:
- Kết nối hệ thống thật: agent phải gọi được CRM, API đơn hàng, lịch — không phải chỉ “nói về” việc sẽ làm.
- Guardrail chi phí và hành động: spending limit, giới hạn số vòng lặp, bước phê duyệt người.
- Giám sát từ ngày đầu: trace từng lượt gọi, alert khi chạy sai, công cụ tắt khẩn cấp.
Khuyến nghị của Webie khớp với thực tế SME: bắt đầu bằng một workflow giá trị cao, có spending limit, approval step và handover cho người khi agent không chắc chắn — và cải thiện có thể thấy trong vài tuần nếu agent được nối với hệ thống thật, giám sát từ ngày đầu.
Workflow 1: Lọc lead và phân loại email — việc nhàm chán nhưng có giá trị
Kiến trúc: nhận email, chấm điểm, định tuyến, ghi CRM
Đây là workflow tôi luôn đề xuất làm đầu tiên vì rủi ro thấp, volume cao, đo được. Kiến trúc gồm 4 tầng:
- Tầng nhận: email vào hộp chung (sales@, info@) được parse — người gửi, chủ đề, nội dung, tệp đính kèm.
- Tầng agent: LLM phân loại ý định (báo giá, đặt lịch, khiếu nại, spam) và chấm điểm lead theo rubric cố định. Dùng pattern routing: email đơn giản cho model rẻ, email phức tạp cho model mạnh — giảm chi phí token nền đáng kể.
- Tầng rule: quy tắc quyết định đường đi — lead nóng chuyển sales trong 15 phút, yêu cầu đặt lịch kích hoạt tool calendar, newsletter đi thẳng archive.
- Tầng ghi: ghi CRM kèm lý do chấm điểm để truy vết, alert Slack cho lead nóng.
Với bài toán 1.500 lead/tháng mà nhân viên mất khoảng 3 phút/lead, tổng gánh nặng là 75 giờ/tháng. Agent giảm khoảng 70% thời gian này — phần còn lại là thời gian con người duyệt những trường hợp agent không chắc chắn.
Ranh giới: agent đề xuất, rule quyết định, người duyệt khi tiền hoặc rủi ro lớn
Nguyên tắc thiết kế quan trọng nhất của workflow này: agent đề xuất, rule quyết định. Agent chấm điểm 0–100 và gắn nhãn, nhưng đường định tuyến nằm ở tầng rule để luôn kiểm soát được. Lead có giá trị dự kiến vượt ngưỡng (ví dụ trên X triệu đồng tiềm năng hợp đồng) bắt buộc qua người duyệt trước khi gửi báo giá. Và hãy chạy song song có kiểm soát 2 tuần đầu: agent chỉ chấm điểm để đối chiếu với chấm điểm của nhân viên, đo độ lệch trước khi tin và cho hành động.
Workflow 2: Chăm sóc khách 24/7 — nơi ROI rõ nhất và rủi ro cao nhất
Trả lời nhanh: Agent an toàn khi được quyền gửi email hoặc hoàn tiền nếu bạn phân tầng quyền: tra cứu read-only chạy tự động 100%; hoàn tiền tự động chỉ dưới ngưỡng cố định (tham chiếu 250 EUR), trên ngưỡng bắt buộc người duyệt; email gửi khách dùng template khóa sẵn. Kèm max iterations = 5, budget token, nhật ký audit bất biến và công khai nội dung do AI tạo theo EU AI Act Article 50.
Tra cứu đơn hàng và trạng thái: agent tự xử lý được
Chăm sóc khách là ứng dụng mà chính Anthropic nêu là phù hợp với agent vì hội đủ điều kiện: có tool tra cứu đơn hàng, hoàn tiền, cập nhật ticket — và kết quả đo được. Câu hỏi “đơn của tôi đâu?” chiếm tỷ trọng lớn trong ticket CSKH và có đường giải thuần túy máy móc: nhận mã đơn → gọi API → trả trạng thái kèm link theo dõi. Không tìm thấy đơn hoặc dữ liệu mâu thuẫn → chuyển người kèm ngữ cảnh. Một số công ty lớn đã tính phí dịch vụ agent theo resolution thành công — thị trường sẵn sàng trả tiền cho kết quả, không cho cuộc hội thoại.
Với SME Việt Nam, đây là workflow tôi đã phân tích chi tiết về chi phí, ngưỡng hòa vốn và Resolution Rate trong bài AI cho CSKH/Sale SME: chatbot, voice agent và cách tính ROI — điểm khác biệt then chốt là agent làm được cả hành động ghi (tạo ticket, đổi trạng thái, hoàn tiền), không chỉ trả lời.
Hoàn tiền và khiếu nại: ngưỡng tự động và điểm chuyển giao cho người
Đây là ranh giới phải vẽ trước khi bật, không phải sau khi sự cố xảy ra:
- Hoàn tiền dưới ngưỡng: tự động hoàn tất trong giới hạn ví dụ 250 EUR (tham chiếu từ Pragma-Code — tuyên bố vendor, cần kiểm chứng trên quy trình của bạn) khi mọi điều kiện validate khớp: đơn hợp lệ, lý do thuộc danh mục cho phép, trong thời hạn.
- Trên ngưỡng hoặc lỗi validate: tạo ticket khẩn cấp, gắn flag, đưa vào hàng phê duyệt của quản lý.
- Khiếu nại nhạy cảm: khách giận dữ, đe dọa pháp lý — chuyển người ngay; agent chỉ soạn bản tóm tắt ngữ cảnh để nhân viên đỡ mất 10 phút đọc lịch sử.
- PII redaction: số giấy tờ, thông tin thẻ, dữ liệu nhạy cảm được che trước khi đi vào context của model.
Workflow 3: Tổng hợp báo cáo tự động — điểm khởi đầu ít rủi ro nhất
Chế độ chỉ đọc (read-only) trong 2–4 tuần đầu
Nếu bạn còn e dè agent, đây là nơi bắt đầu. Agent được quyền đọc CRM, nền tảng quảng cáo, Google Analytics — nhưng không gửi gì đi đâu cả. Nó soạn draft báo cáo tuần: doanh thu theo kênh, chi phí trên lead, tỷ lệ chuyển đổi, các điểm bất thường. Con người duyệt, chỉnh, rồi mới gửi nội bộ. Sau 2–4 tuần khi chất lượng draft ổn định, mới bật gửi tự động cho nội bộ — và chỉ sau đó mới cân nhắc gửi cho khách.
Kiểm chứng số liệu: mỗi con số phải truy được về nguồn
Quy tắc bất di bất dịch: mỗi số liệu trong báo cáo phải truy được về nguồn — truy vấn nào, từ hệ thống nào, timestamp nào. Pattern evaluator-optimizer khớp hoàn hảo ở đây: một LLM viết báo cáo, một LLM thứ hai đối chiếu từng số với dữ liệu gốc và gắn cờ “chưa xác thực” thay vì để nó bịa phần lấp đầy. LLM có xu hướng điền con số “hợp lý” khi thiếu dữ liệu — và trong báo cáo quản trị, con số hợp lý nhưng sai còn nguy hiểm hơn việc trả lời thẳng “không có dữ liệu”.
Khi nào agent thật sự hơn, và khi nào nó vẫn là đồ chơi
Trả lời nhanh: SME nên dùng AI agent thay chatbot khi nhiệm vụ thỏa đồng thời 4 điều kiện: (1) có tool/API rõ ràng để hành động; (2) tiêu chí thành công đo được như resolution rate hoặc thời gian xử lý; (3) có điểm dừng chuyển người khi agent không chắc chắn; (4) chi phí lỗi chặn được bằng ngưỡng giá trị và bước phê duyệt. Nếu chỉ cần trả lời câu hỏi — chatbot FAQ vẫn là lựa chọn rẻ và đủ.
Bốn điều kiện để agent đáng giá hơn workflow cố định
- Tool rõ ràng và ổn định: hành động cần làm phải có API/tool tương ứng, hành vi ổn định. Agent không tạo ra năng lực hệ thống — nó chỉ vận hành năng lực đã có.
- Tiêu chí thành công đo được: phải định nghĩa được “xong” nghĩa là gì — đơn được tra, ticket được đóng, báo cáo được duyệt — để đo tỷ lệ hoàn thành.
- Điểm dừng cho người: agent phải nhận ra lúc nó không chắc chắn và chuyển giao kèm ngữ cảnh, thay vì lao tiếp.
- Chi phí lỗi chặn được: spending limit, ngưỡng giá trị, approval step — để một lượt chạy sai không thành tổn thất tiền mặt.
Dấu hiệu cảnh báo: đồ chơi trá hình dưới nhãn agent
- Không giữ ngữ cảnh giữa các bước hoặc giữa các phiên: mỗi lượt trả lời như bắt đầu lại từ đầu.
- Chỉ “nói về” hành động, không gọi hệ thống thật: không có kết nối CRM/order API thì không phải agent, dù tên gọi là gì.
- Không đo được resolution rate: chỉ có demo kịch bản đẹp, không có tập test đại diện.
- Không có công cụ dừng khẩn cấp: đây chính là lý do 27% doanh nghiệp trong khảo sát không thể tắt agent đang chạy sai.
Trước khi vào kiến trúc, bảng dưới đây gộp toàn bộ đánh đổi thành một trang quyết định (số liệu minh họa theo giả định — hãy thay bằng đo lường thực tế của bạn):
Bảng so sánh năng lực và chi phí: Chatbot FAQ, AI Agent đơn, Multi-Agent (số liệu minh họa theo giả định, cần thay bằng đo lường thực tế):
| Tiêu Chí / Khía Cạnh | Chatbot FAQ truyền thống | AI Agent đơn có tool | Hệ thống Multi-Agent (supervisor) | Khuyến Nghị Thực Chiếm |
|---|---|---|---|---|
| Cơ chế hoạt động | Tra cứu và trả lời một lượt theo kịch bản hoặc RAG | Vòng lặp: LLM chọn tool, nhận kết quả từ môi trường, tiếp tục đến khi xong | Supervisor phân việc cho nhiều worker agent rồi tổng hợp | Bắt đầu bằng agent đơn; chỉ tách multi-agent khi có nhánh song song rõ |
| Số bước tự thực hiện | 1 bước (chỉ trả lời) | Trung bình 3–8 bước có gọi API trong một phiên | Nhiều nhánh song song, thường 10+ bước tổng cộng | Mục tiêu 3–5 bước có kiểm soát cho giai đoạn đầu |
| Chất lượng khi có ghi dữ liệu | Không ghi, chỉ chuyển người | Ghi CRM, tạo đơn, hoàn tiền dưới ngưỡng nếu có guardrail | Ghi nhiều hệ thống, rủi ro lan truyền lỗi cao hơn | Chỉ bật ghi sau 2–4 tuần chạy chế độ chỉ đọc |
| Chi phí token mỗi lượt (ước tính minh họa) | Gần 0 nếu dùng kịch bản; có RAG thì thấp | Tăng khoảng 3–10 lần lượt gọi model so với chatbot | Có thể 10–20 lần lượt gọi, cần cache và định tuyến model rẻ | Đặt budget token và max iterations = 5 trên mỗi giao dịch |
| Tỷ lệ hoàn tất không cần người (kỳ vọng thận trọng) | Thường thấp với câu hỏi ngoài kịch bản | Có thể đạt 40–70% với tác vụ có tool rõ ràng, cần kiểm chứng trên dữ liệu của bạn | Cải thiện trên tác vụ phức tạp nhưng khó đo độc lập | Đo bằng tỷ lệ resolution trên tập test đại diện, không đo bằng demo |
| Chi phí bảo trì và giám sát | Thấp: cập nhật FAQ | Trung bình: giám sát trace, cập nhật tool khi API đổi | Cao: nhiều prompt, nhiều điểm lỗi, cần observability đầy đủ | Trích ngân sách bảo trì khoảng 15–25% chi phí xây dựng mỗi năm (giả định) |
Kiến trúc tối thiểu và lộ trình 90 ngày cho SME
Tool-RAG, MCP và guardrail: max iterations, budget token, nhật ký audit
Kiến trúc tối thiểu cho SME không cần đồ đạc phức tạp — cần đúng các lớp sau:
- Tool-RAG: chỉ nạp 3–5 tool schema liên quan vào context thay vì toàn bộ danh mục — Pragma-Code báo cáo giảm token đầu vào tới 85% (tuyên bố vendor, nhưng hướng làm thì đúng và dễ kiểm chứng ngay trên hệ thống của bạn).
- MCP làm lớp kết nối tool: chuẩn hóa cách agent gọi tool, đỡ viết glue code cho từng tích hợp. Tôi phân tích sâu hướng chuẩn hóa này trong bài Agent2Agent về chung mái nhà với MCP.
- Guardrail bắt buộc: Max-Iterations = 5 trên mỗi giao dịch; budget token cho mỗi giao dịch để chặn vòng lặp tự sửa lỗi; nhật ký audit bất biến; PII redaction; công khai nội dung do AI tạo cho khách theo EU AI Act Article 50.
- Orchestration: với SME, n8n cộng MCP đủ cho đa số bài toán; LangGraph với checkpoint PostgreSQL là lựa chọn khi cần đồ thị trạng thái phức tạp — đừng bắt đầu từ đó.
Lộ trình 4 pha: đánh giá quy trình, prototype chỉ đọc, bật ghi có duyệt, mở rộng
- Pha 1 — Tuần 1–2, đánh giá quy trình: chọn một workflow hội tụ 4 điều kiện ở trên; đo baseline (thời gian xử lý, tỷ lệ lỗi, chi phí/đơn vị công việc).
- Pha 2 — Tuần 3–6, prototype chỉ đọc: agent chạy song song nhân viên, chỉ đọc và đề xuất, không hành động. Đo độ lệch so với con người.
- Pha 3 — Tuần 7–10, bật ghi có duyệt: mở quyền ghi nhưng mọi hành động có giá trị qua approval step; đặt spending limit và max iterations.
- Pha 4 — Tuần 11–13, mở rộng: hạ dần ngưỡng phê duyệt khi tỷ lệ lỗi đo được thấp; chỉ cân nhắc multi-agent nếu xuất hiện nhánh song song thật.
Chi phí thật: token chỉ là một phần của tổng chi phí sở hữu
Trả lời nhanh: Với bài toán minh họa 1.500 lead/tháng, 4 lần gọi model mỗi lead, 2.500 token vào + 500 token ra mỗi lần, chi phí API khoảng 90 USD/tháng theo đơn giá giả định 3 USD/1M token vào và 15 USD/1M token ra. Nhưng tổng chi phí sở hữu cao hơn đáng kể vì công xây dựng, giám sát và bảo trì — hãy trích ngân sách bảo trì khoảng 15–25% chi phí xây dựng mỗi năm và đo ROI bằng nhóm đối chứng, không bằng cảm giác.
Công thức tổng chi phí: API, xây dựng, giám sát, bảo trì, chi phí lỗi
Đây là lỗi đánh giá phổ biến nhất tôi gặp: tính chi phí agent bằng hóa đơn API. Công thức đầy đủ là:
Tổng chi phí sở hữu = chi phí token API + chi phí xây dựng workflow (thiết kế, nối tool) + chi phí giám sát (trace, alert, người trực) + chi phí bảo trì (API bên thứ ba đổi giao diện, tool hỏng, prompt phải chỉnh) + chi phí lỗi (gửi sai email, hoàn tiền sai, dữ liệu sai ghi vào CRM).
Phần lớn doanh nghiệp đánh giá thấp đúng hai hạng mục cuối — bảo trì và chi phí lỗi — vì chúng không hiện trên hóa đơn nào cho đến khi sự cố xảy ra.
Ví dụ tính toán với 1.500 lead mỗi tháng và giả định đơn giá minh họa
Bài toán minh họa (không phải báo giá — thay bằng bảng giá thực tại thời điểm triển khai): 1.500 lead/tháng × 4 lần gọi model/lead × (2.500 token vào + 500 token ra) = khoảng 15 triệu token vào và 3 triệu token ra mỗi tháng. Với đơn giá giả định 3 USD/1M token vào và 15 USD/1M token ra: 45 USD + 45 USD = ~90 USD/tháng chi phí API. Về phía tiết kiệm: 75 giờ nhân sự/tháng giảm 70% giải phóng khoảng 52 giờ. Hai vế chỉ cân khi bạn cộng đủ các hạng mục ngoài API — và khi vòng lặp lỗi không được phép đốt tiền: một vòng lặp vô hạn có thể đốt tiền theo giờ, đó là lý do budget token và max iterations là guardrail bắt buộc, không phải tùy chọn. Pattern routing về model rẻ cho bước đơn giản là đòn bẩy giảm chi phí thứ hai tôi luôn áp dụng.
Cách đo ROI trung thực: đối chứng thay vì cảm giác
Baseline và nhóm đối chứng: đo trước khi bật agent
Không đo baseline trước khi bật thì sau này mọi con số đều là cảm giác. Trước pha 3, ghi lại trong 2–4 tuần: thời gian xử lý trung bình mỗi lead/ticket, tỷ lệ lỗi, chi phí trên đơn vị công việc, thời gian phản hồi. Khi bật, giữ nhóm đối chứng 20–30% traffic hoặc A/B theo tuần — so sánh trước/sau thuần túy dễ nhiễm yếu tố mùa vụ và thay đổi nhân sự.
Chỉ số nên theo dõi và cảnh báo khi đọc số liệu của vendor
- Tỷ lệ hoàn tất không cần người (resolution/containment rate) — đo trên tập test đại diện, không đo bằng demo.
- Cost per resolution — không phải cost per message; hội thoại rẻ chưa chắc là nhiệm vụ hoàn thành.
- Thời gian phản hồi P50/P95 — con số trung bình đẹp thường giấu cái đuôi chậm.
- Tỷ lệ escalation và chất lượng handover — chuyển người nhiều chưa chắc xấu; chuyển người mà mất ngữ cảnh chắc chắn xấu.
- Chi phí token/giao dịch và số lần vượt budget — chỉ báo sớm của vòng lặp lỗi.
Về số liệu vendor: Pragma-Code tuyên bố SME giảm 42–68% chi phí vận hành, tăng thông lượng trên 80%, xử lý hóa đơn từ 4–6 ngày xuống dưới 10 phút, sàng lọc RFP trong 30 phút. Hãy coi đây là tuyên bố tiếp thị chưa được kiểm chứng độc lập — dùng làm điểm tham chiếu, không dùng làm cam kết.
Con số của vendor là điểm xuất phát của câu hỏi, không phải điểm kết thúc của cuộc thảo luận. Câu trả lời duy nhất có giá trị là con số đo được trên dữ liệu và traffic của chính bạn.
Câu hỏi thường gặp
Khi nào SME nên dùng AI agent thay vì chatbot?
Khi nhiệm vụ hội tụ đủ bốn điều kiện: có tool/API rõ ràng để hành động (tra cứu, ghi CRM, tạo ticket), tiêu chí thành công đo được (resolution rate, thời gian xử lý), có điểm dừng chuyển giao cho người khi agent không chắc chắn, và chi phí lỗi chặn được bằng ngưỡng giá trị kèm bước phê duyệt. Nếu nhu cầu chỉ là trả lời câu hỏi lặp lại theo kịch bản, chatbot FAQ vẫn là lựa chọn rẻ hơn và dễ bảo trì hơn. Lối vào khuyến nghị: một agent đơn với 3–5 bước có kiểm soát, chạy chế độ chỉ đọc 2–4 tuần trước khi mở quyền ghi — không phải multi-agent ngay từ đầu.
Vì sao agent đốt tiền bất ngờ và cách chặn?
Vì mỗi vòng của loop là một lượt gọi model tính tiền cả đầu vào lẫn đầu ra, và context phình to theo mỗi vòng — lỗi cộng dồn khiến một giao dịch “kẹt” tốn gấp nhiều lần giao dịch bình thường. Trường hợp xấu nhất là vòng lặp tự sửa lỗi vô hạn, có thể đốt tiền theo giờ nếu không ai để ý. Chặn bằng bốn lớp: Max-Iterations = 5 trên mỗi giao dịch; budget token cứng cho mỗi giao dịch; alert khi vượt ngưỡng chi phí; và Tool-RAG chỉ nạp 3–5 tool schema liên quan để cắt token đầu vào. Thêm pattern routing về model rẻ cho các bước đơn giản để hạ chi phí nền.
Có nên cho agent quyền gửi email hoặc hoàn tiền cho khách không?
Nên — nhưng theo tầng, không phải bật/tắt. Tra cứu read-only: tự động 100%. Hoàn tiền: tự động dưới ngưỡng cố định (tham chiếu 250 EUR) khi mọi điều kiện validate khớp; trên ngưỡng hoặc có lỗi validate thì bắt buộc người duyệt. Email gửi khách: template khóa sẵn, biến điền vào được validate, không cho agent tự do soạn nội dung mở. Kèm bộ guardrail bắt buộc: nhật ký audit bất biến, PII redaction, và công khai với khách rằng nội dung do AI tạo theo EU AI Act Article 50. Bắt đầu với 100% hành động ghi có duyệt, hạ ngưỡng dần khi tỷ lệ lỗi đo được trên nhóm đối chứng thấp và ổn định.
Multi-agent có cần thiết cho SME không?
Ở giai đoạn đầu, hầu như luôn là không. Multi-agent (supervisor điều phối nhiều worker) chỉ đáng giá khi bài toán có nhiều tác vụ con song song thật sự và bạn đã đo được hiệu năng của single agent làm từng phần — tách nhiều agent trước khi đo là tự nhân đôi điểm lỗi và chi phí giám sát. Điểm ngặt của multi-agent là observability: nhiều prompt, nhiều điểm lỗi lan truyền, khó quy trách nhiệm khi tổng hợp sai. Lộ trình hợp lý cho SME: agent đơn → pattern orchestrator-workers cho một nhánh bài toán cụ thể → hệ nhiều agent chỉ khi số liệu buộc phải tách. Tôi phân tích chi tiết ngưỡng này trong bài AI Agents 2026: Khi nào cần Multi-Agent và cách điều phối đúng.
Nếu chỉ nhớ một điều từ bài này: “chatbot đã chết” là khẩu hiệu tiếp thị, nhưng việc giao hành động cho vòng lặp có guardrail là xu hướng kỹ thuật thật. Chatbot FAQ vẫn hợp lý làm lớp đầu tiếp khách; agent đáng giá nhất ở những việc có tool rõ ràng, tiêu chí thành công đo được và điểm dừng cho người. Hãy chọn một quy trình trong ba workflow trên, đo baseline ngay tuần này — và để số liệu đối chứng, không phải demo, quyết định việc mở rộng.
Tác giả: Cường Nguyễn — Founder AI Ops Solutions | Verified n8n Creator. Kết nối: Facebook · LinkedIn · YouTube · TikTok
Bài viết là góc nhìn cá nhân của tác giả, mang tính tham khảo — không phải tin tức báo chí.
📬 Nhận bài viết mới — miễn phí
Đừng bỏ lỡ bài viết tiếp theo. Đăng ký để nhận trong inbox.
Tác giả
Cường Nguyễn — AI Thực Chiến
Tôi là Cường Nguyễn - Founder của AI Ops Solutions.
Tôi từng là Logistics Operations Manager và đồng sáng lập thương hiệu CATCA - #1 Shopee ngành Pet Care.
10 năm kinh nghiệm Logistics/E-commerce OperationsCo-founder CATCA - #1 Shopee ngành Pet CareMột trong 300+ n8n Verified Creator toàn cầuTư vấn Giải pháp chuyển đổi số bằng AI cho 3 SMEs/quý


