Bài viết
Bài viết cá nhân
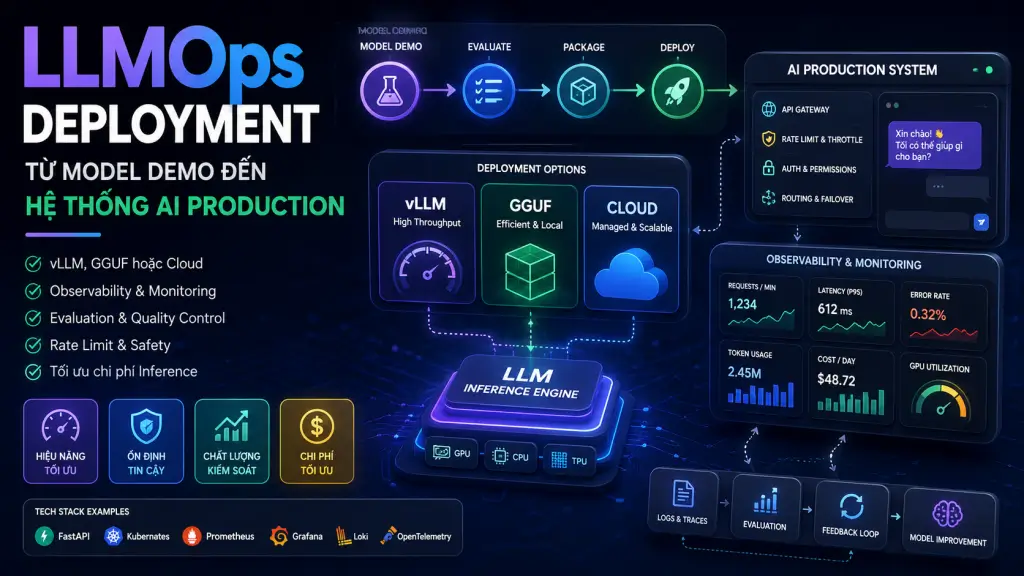
LLMOps Deployment: Từ Model Demo đến Hệ thống AI Production
👤 cuongnguyen📅 11/08/2026⏱ 24 phút đọc
Trong bài viết này(29 mục)⌄
- LLMOps deployment là gì và vì sao prototype không đủ để chạy production?
- Từ gọi API thành một hệ thống có SLO, reliability và trách nhiệm vận hành
- Prompt, model và retrieval phải được quản lý như các thành phần có version
- Thiết kế kiến trúc LLMOps trước khi deploy
- Chọn API cloud, self-hosted hay hybrid routing theo workload
- Định nghĩa SLO: latency, throughput, quality, availability và cost per request
- Chọn runtime: vLLM, GGUF/llama.cpp và cloud inference
- vLLM, PagedAttention và continuous batching cho GPU serving
- GGUF/llama.cpp cho local, edge, private inference và CPU-GPU hybrid
- Quy trình LLMOps deployment từ model artifact đến endpoint
- Đóng gói model, tokenizer, prompt template và cấu hình runtime
- Benchmark trước production: TTFT, inter-token latency, throughput và concurrency
- Health check, canary release, rollback và kiểm soát thay đổi model
- Monitoring LLM production: nhìn thấy cả latency lẫn chất lượng
- Thiết kế trace và span cho gateway, retrieval, generation và tool call
- Token usage, GPU utilization, KV cache và economic observability
- Đánh giá online: hallucination, relevance, faithfulness và drift
- Tối ưu chi phí inference mà không hy sinh chất lượng
- Model routing, model nhỏ chuyên biệt và knowledge distillation
- Quantization, GGUF và cách kiểm tra trade-off giữa VRAM, latency và quality
- Caching, batching, prompt compression và tối ưu token budget
- Rate limit và reliability: bảo vệ hệ thống khỏi traffic burst
- Queue, timeout, retry exponential backoff và circuit breaker
- Khung quyết định triển khai LLMOps cho doanh nghiệp
- Câu hỏi thường gặp
- Khi nào người mới nên chọn vLLM thay vì GGUF/llama.cpp?
- Quantization có luôn làm giảm chất lượng model không và cần Eval thế nào?
- Làm sao biết self-hosting rẻ hơn API cloud trong workload thực tế?
- Monitoring truyền thống có đủ cho ứng dụng LLM không?
LLMOps deployment là gì và vì sao prototype không đủ để chạy production?
LLMOps deployment là tập hợp thực hành để xây dựng, triển khai, quan sát và duy trì hệ thống LLM trong môi trường production. Nó kết hợp tư duy DevOps, MLOps, bảo mật, quản trị dữ liệu, evaluation và tối ưu hạ tầng inference. Nếu một ứng dụng truyền thống chủ yếu cần kiểm tra endpoint có phản hồi hay không, ứng dụng LLM phải trả lời thêm các câu hỏi khó hơn: câu trả lời có đúng ngữ cảnh không, có bịa dữ kiện không, có để lộ dữ liệu nhạy cảm không, có vượt ngân sách token không và có duy trì trải nghiệm khi lượng truy cập tăng đột biến không.
Khoảng cách giữa prototype và production nằm ở chỗ một request trả về HTTP 200 chưa chứng minh hệ thống hoạt động tốt. Một chatbot có thể phản hồi thành công nhưng vẫn tạo hallucination, trả lời lạc đề, vi phạm định dạng JSON, gọi tool sai tham số hoặc dùng quá nhiều token. Với LLM có tính xác suất, cùng một prompt có thể tạo đầu ra khác nhau theo model version, temperature, context được truy xuất, tool state và cấu hình serving. Vì vậy, production không thể chỉ dựa vào dashboard CPU, RAM hay tỷ lệ lỗi HTTP.
- Reliability: Hệ thống cần xử lý timeout, retry, queue, fallback và tình trạng một upstream model hoặc tool bị lỗi.
- Quality: Cần đo relevance, faithfulness, hallucination, toxicity, JSON compliance và mức độ hoàn thành tác vụ.
- Economics: Cần biết token, GPU, cache, retrieval hay agent loop nào làm tăng cost per request.
- Governance: Prompt, model, knowledge base và policy phải có version, quyền truy cập, audit trail và phương án rollback.
Trong LLMOps, “đang chạy” không đồng nghĩa với “đáng tin”: một endpoint khỏe mạnh vẫn có thể tạo ra câu trả lời sai, tốn kém hoặc không an toàn.
Từ gọi API thành một hệ thống có SLO, reliability và trách nhiệm vận hành
Một demo thường chỉ gồm UI, prompt và lời gọi API. Một hệ thống LLMOps production cần chuyển thành chuỗi thành phần có trách nhiệm rõ ràng: gateway xác thực người dùng, lớp rate limit, router chọn model, retrieval cho dữ liệu doanh nghiệp, model server, tool executor, lớp guardrail, telemetry và evaluation. Mỗi lớp phải có SLO riêng: độ sẵn sàng, latency, tỷ lệ thành công, chất lượng ngữ nghĩa và chi phí. Điều này đặc biệt quan trọng với agent, nơi một câu hỏi có thể kích hoạt nhiều lượt retrieval, nhiều tool call và nhiều model khác nhau.
Với chatbot RAG, vận hành tốt không chỉ là đặt vector database phía sau model. Đội ngũ cần biết retrieval có lấy đúng tài liệu không, chunk có quá lớn hay quá nhỏ không, reranker có làm latency tăng bất hợp lý không và model có tổng hợp trung thực từ context không. Bài viết RAG từ Zero đến Production cung cấp góc nhìn nền tảng về chunking, hybrid retrieval, reranking và governance; trong LLMOps, các quyết định đó phải được đưa vào pipeline đo lường liên tục thay vì chỉ thiết kế một lần.
Prompt, model và retrieval phải được quản lý như các thành phần có version
Prompt phải được coi là code vì nó thay đổi trực tiếp hành vi của model. Mỗi thay đổi system prompt, few-shot example, schema output, temperature, context window hoặc routing rule đều có thể làm giảm chất lượng ở một nhóm tình huống mà smoke test không phát hiện. Do đó, doanh nghiệp cần version control, regression test, review, staged rollout, canary release và rollback cho prompt cũng như model artifact. Một phiên bản prompt không nên được phát hành chỉ vì nó tạo ấn tượng tốt trên vài ví dụ thủ công.
- Model registry: Lưu model identifier, checkpoint, tokenizer, quantization, runtime và evaluation baseline.
- Prompt registry: Lưu template, biến inject, policy, output schema, người phê duyệt và thời điểm phát hành.
- Retrieval version: Theo dõi embedding model, chiến lược chunking, index, metadata filter và reranker.
- Evaluation set: Duy trì tập tình huống đại diện cho người dùng, tác vụ, ngôn ngữ, edge case và rủi ro.
Thiết kế kiến trúc LLMOps trước khi deploy
Một kiến trúc bền vững cần tách control plane khỏi data plane. Data plane xử lý request thời gian thực: authentication, quota, routing, retrieval, generation, tool call và streaming. Control plane quản lý model registry, prompt registry, evaluation dataset, experiment tracking, release policy, secrets, dashboard và audit. Sự phân tách này giúp đội ngũ thay đổi model hoặc prompt có kiểm soát mà không biến toàn bộ logic ứng dụng thành một khối khó kiểm thử.
Luồng request nên bắt đầu từ API gateway, nơi xác định tenant, quyền truy cập, quota và ngân sách token. Sau đó router quyết định gửi request tới cloud API, cụm GPU tự host hoặc model nhỏ hơn. Nếu là RAG, retrieval service tạo embedding, tìm kiếm, rerank và đưa context có kiểm soát vào prompt. Model server sinh kết quả, tool layer thực thi hành động nếu cần, còn observability ghi trace xuyên suốt. Các lớp này nên tránh chia sẻ trực tiếp secrets hoặc raw sensitive data không cần thiết.
- Gateway: Xác thực API key, rate limit theo tenant, giới hạn request body và kiểm soát abuse.
- Router: Chọn model theo độ phức tạp, privacy, cost budget, SLA và khả năng sẵn sàng.
- Retrieval: Tách metric chất lượng truy xuất khỏi metric chất lượng tổng hợp câu trả lời.
- Serving: Quản lý batching, KV cache, streaming, autoscaling, health check và capacity.
- Telemetry: Thu thập trace, span, token, latency, cost, outcome evaluation và feedback người dùng.
Chọn API cloud, self-hosted hay hybrid routing theo workload
Cloud API phù hợp khi doanh nghiệp cần triển khai nhanh, cần frontier reasoning, chưa có năng lực vận hành GPU hoặc traffic chưa đủ ổn định để tận dụng hạ tầng riêng. Đổi lại, chi phí biến thiên theo token, kiểm soát latency hạn chế hơn và yêu cầu data residency có thể trở thành rào cản. Self-hosting phù hợp khi volume query lớn, dữ liệu cần nằm trong môi trường riêng, doanh nghiệp cần kiểm soát runtime hoặc muốn dự báo chi phí dựa trên GPU utilization thay vì giá token niêm yết.
Hybrid routing thường thực tế hơn lựa chọn “hoặc cái này hoặc cái kia”. Các tác vụ có khối lượng lớn, cấu trúc rõ, ít cần reasoning sâu có thể chạy trên model tự host hoặc model đã quantize. Các request phức tạp, hiếm gặp, cần năng lực suy luận mạnh hoặc có độ bất định cao có thể được chuyển lên API cloud. Router không nên chỉ nhìn vào độ dài prompt; nó cần xem xét rủi ro, độ phức tạp ngữ nghĩa, yêu cầu chất lượng, tenant policy và ngân sách còn lại.
Định nghĩa SLO: latency, throughput, quality, availability và cost per request
SLO của LLM không nên gộp vào một chỉ số “response time”. Cần phân biệt time-to-first-token để đo cảm nhận ban đầu khi streaming, inter-token latency để đo tốc độ sinh nội dung, end-to-end latency để đo toàn bộ trải nghiệm và latency từng thành phần như retrieval, reranking, model queue hoặc tool call. Một nhận định từ round table được ZenML dẫn lại cho thấy latency production thường có thể lên tới vài giây, còn chuỗi nhiều model có thể vượt 15 giây.
“The current state of latency in production workflows can often reach several seconds, with multi-model chains extending to 15+ seconds.”
Chất lượng cũng phải là SLO có thể hành động. Ví dụ, RAG cần theo dõi context precision và context recall để xác định retriever có vấn đề hay không; sau đó mới đo answer relevance, faithfulness và mức độ hoàn thành nhiệm vụ của generator. Availability cần được hiểu là khả năng hoàn thành tác vụ trong điều kiện chấp nhận được, không chỉ là model endpoint trả HTTP 200. Cuối cùng, cost per successful task thường hữu ích hơn cost per request vì một request rẻ nhưng trả lời sai sẽ tạo chi phí vận hành và chi phí nghiệp vụ lớn hơn.
Chọn runtime: vLLM, GGUF/llama.cpp và cloud inference
Runtime inference là quyết định ảnh hưởng trực tiếp tới throughput, latency, mật độ GPU, chi phí và khả năng triển khai. Không có runtime nào tối ưu cho mọi workload. vLLM thường là lựa chọn mạnh cho GPU serving đồng thời cao; GGUF/llama.cpp linh hoạt cho local, edge và private inference trên nhiều loại phần cứng; còn cloud inference giảm gánh nặng vận hành khi yêu cầu năng lực model hoặc tốc độ ra mắt quan trọng hơn quyền kiểm soát hạ tầng.
vLLM, PagedAttention và continuous batching cho GPU serving
Điểm đáng chú ý của vLLM là PagedAttention. Thay vì cấp phát KV cache dựa trên sequence length tối đa cho mỗi request, runtime chia cache thành các block cố định và cấp phát động khi sequence tăng. Vì phần lớn request thực tế ngắn hơn context tối đa, cách tiếp cận này giảm lãng phí bộ nhớ và giúp phục vụ nhiều request đồng thời hơn. Nó đặc biệt phù hợp với môi trường nhiều phiên có độ dài đầu vào, đầu ra khác nhau.
vLLM cũng tận dụng continuous batching: scheduler đưa request mới vào batch khi request cũ hoàn tất hoặc giải phóng tài nguyên, thay vì chờ tất cả request trong batch kết thúc cùng lúc. Theo mô tả của Comet, continuous batching có thể cải thiện throughput khoảng 2 đến 4 lần trong điều kiện phù hợp. Đây không phải cam kết chung cho mọi hệ thống: kết quả phụ thuộc model, context length, concurrency, GPU, sampling parameters, tỷ lệ streaming và đặc tính traffic. Production phải benchmark bằng workload thật trước khi biến con số này thành kế hoạch capacity.
GGUF/llama.cpp cho local, edge, private inference và CPU-GPU hybrid
llama.cpp là hướng phù hợp khi ưu tiên tính di động, đơn giản triển khai, local inference hoặc môi trường self-hosted cần giảm phụ thuộc vào cloud. Dự án hỗ trợ định dạng GGUF, inference LLM/VLM bằng C/C++, nhiều backend như CPU, CUDA, HIP, Metal, Vulkan và SYCL. Khả năng chạy CPU+GPU hybrid giúp triển khai model lớn hơn tổng VRAM sẵn có, dù hiệu năng cần được đo cẩn thận theo phần model offload và tốc độ memory bandwidth.
llama.cpp hỗ trợ quantization từ 1.5-bit, 2-bit, 3-bit, 4-bit, 5-bit, 6-bit đến 8-bit. Điều này mở ra khả năng đưa model vào máy trạm, server CPU, thiết bị edge hoặc môi trường private với yêu cầu bộ nhớ thấp hơn. Repository cũng cung cấp công cụ chạy model qua llama cli và mở endpoint tương thích OpenAI qua llama serve. Tuy nhiên, quantization chỉ là tối ưu tài nguyên; chất lượng, độ ổn định JSON, năng lực đa ngôn ngữ và độ trung thực phải được đánh giá bằng bộ Eval của chính sản phẩm.
- Chọn vLLM: Khi cần GPU serving, concurrency lớn, batching hiệu quả và khả năng khai thác KV cache tốt.
- Chọn GGUF/llama.cpp: Khi cần local, edge, offline, data residency, phần cứng đa dạng hoặc footprint bộ nhớ thấp.
- Chọn cloud inference: Khi cần triển khai nhanh, model frontier, vận hành đơn giản hoặc traffic chưa đủ ổn định.
- Chọn hybrid: Khi muốn cân bằng privacy, chất lượng, cost predictability và workload phân tầng.
Quy trình LLMOps deployment từ model artifact đến endpoint
Triển khai production bắt đầu từ một artifact bất biến, không chỉ là tên model. Artifact cần mô tả model checkpoint, tokenizer, chat template, quantization, runtime version, cấu hình context window, sampling defaults, safety policy, prompt template và dependency. Nếu thiếu thông tin này, đội ngũ sẽ không tái tạo được kết quả khi quality giảm sau một bản cập nhật. Với RAG, artifact release còn nên tham chiếu embedding model, corpus snapshot, index version và reranker.
Đóng gói model, tokenizer, prompt template và cấu hình runtime
Một release manifest cần liên kết model version với prompt version và evaluation report. Đây là nền tảng để trả lời câu hỏi “tại sao output hôm nay khác tuần trước?”. Container hóa runtime giúp môi trường nhất quán, nhưng container không tự giải quyết vấn đề model loading, cold start hay data locality. ZenML nêu trường hợp Replit tối ưu model loading bằng container image và local SSD để giảm startup time, từ đó tận dụng preemptible GPU hiệu quả hơn.
Hệ thống cần tách secret khỏi prompt và log. API key, dữ liệu định danh cá nhân, tài liệu nội bộ, token truy cập tool hoặc thông tin thanh toán không nên xuất hiện nguyên trạng trong telemetry. Thực hành tốt gồm log redaction, mã hóa dữ liệu, phân quyền theo tenant, retention policy, audit trail và kiểm tra prompt injection đối với các luồng có tool hoặc retrieval từ nguồn không tin cậy.
Benchmark trước production: TTFT, inter-token latency, throughput và concurrency
Benchmark đáng tin không dùng một prompt ngắn duy nhất. Bộ test cần phản ánh phân phối thực tế về độ dài input, output, context RAG, tỷ lệ tool call, streaming, concurrency và loại tác vụ. Đo TTFT, inter-token latency, end-to-end latency, throughput, error rate, queue time, token throughput và GPU utilization. Với model tự host, cần kiểm tra hành vi khi KV cache gần đầy, khi request dài xuất hiện giữa nhiều request ngắn và khi autoscaling hoặc cold start diễn ra.
Fuzzy Labs được ZenML dẫn như một ví dụ về giá trị của tối ưu serving: sau khi dùng vLLM với paged attention trên GPU, baseline khoảng 11 giây latency và 7–8 request/phút được cải thiện xuống khoảng 3 giây latency cùng throughput cao hơn 10 lần. Đây là case study chứ không phải định luật. Giá trị thực của ví dụ là nhắc đội ngũ phải đo baseline, thay đổi một biến tại một thời điểm và đánh giá cả chất lượng lẫn hiệu năng.
Health check, canary release, rollback và kiểm soát thay đổi model
Health check nên có nhiều tầng: process còn sống, GPU/runtime sẵn sàng, model có thể sinh token, retrieval có thể truy cập index và tool dependency có phản hồi. Khi phát hành model hoặc prompt mới, dùng canary release để đưa một tỷ lệ traffic nhỏ qua phiên bản mới, so sánh quality, latency, cost và tỷ lệ lỗi với baseline. Nếu metric vượt guardrail, rollback phải là thao tác nhanh, đã được diễn tập và không phụ thuộc vào việc chỉnh sửa thủ công trong lúc sự cố.
- Offline gate: Chỉ phát hành khi regression suite đạt ngưỡng quality và safety đã định.
- Online gate: Theo dõi latency, token, error, feedback và quality sampling sau canary.
- Rollback target: Luôn giữ model, prompt, index và cấu hình runtime đã biết là ổn định.
- Change log: Ghi rõ lý do thay đổi, người phê duyệt, kết quả Eval và tác động dự kiến.
Monitoring LLM production: nhìn thấy cả latency lẫn chất lượng
Monitoring truyền thống giỏi phát hiện CPU cao, pod restart hoặc error rate tăng, nhưng không đủ để lý giải tại sao chatbot trả lời sai. LLM observability cần trace theo request, liên kết toàn bộ gateway, retrieval, generation, tool và evaluator. Cách tiếp cận này bổ sung cho evaluation và observability như hạ tầng bắt buộc: observability cho biết hệ thống đã làm gì, còn evaluation đánh giá kết quả đó có đạt mục tiêu hay không.
Thiết kế trace và span cho gateway, retrieval, generation và tool call
Mỗi request nên tạo một root span lưu query hoặc phiên bản đã redaction, tenant, route, end-to-end latency và outcome. Retrieval span ghi latency embedding, số chunk, filter, similarity score, reranker và context được chọn. Generation span ghi prompt thực tế sau inject biến, model version, input/output tokens, latency, sampling configuration và cost. Tool span ghi input do model tạo, output tool, lỗi và thời gian thực thi. Nhờ vậy, đội ngũ có thể phân biệt lỗi model với lỗi tool, lỗi retriever hoặc lỗi prompt assembly.
Với chatbot nhiều lượt, cần thêm thread-level visibility. Một câu trả lời riêng lẻ có thể hợp lý, nhưng toàn bộ hội thoại vẫn thất bại vì context drift, memory corruption, lịch sử hội thoại bị cắt sai hoặc agent lặp vô ích. Trace cấp thread giúp phát hiện các pattern này, đồng thời cho phép phân tích số lượt, tổng token, tool sequence và điểm mà người dùng bỏ cuộc.
- Root trace: Đo trải nghiệm đầu-cuối, route và outcome của một yêu cầu người dùng.
- Retrieval span: Phân tích chất lượng context, số chunk, độ trễ embedding và reranking.
- Generation span: Quan sát prompt cuối, tokens, TTFT, tốc độ sinh và chi phí.
- Tool span: Kiểm tra input model tạo ra, policy enforcement, output và failure mode.
Token usage, GPU utilization, KV cache và economic observability
Economic observability phân bổ chi phí xuống span, trace, project, feature, agent hoặc tenant. Đây là khác biệt quan trọng vì chi phí LLM phụ thuộc đồng thời vào traffic và độ phức tạp ngữ nghĩa. Một agent loop, output quá dài, prompt dư thừa hoặc retry không kiểm soát có thể làm token tăng mạnh dù số request gần như không đổi. Với self-hosting, theo dõi GPU utilization, queue depth, KV cache pressure, batch efficiency và token throughput để biết cụm GPU đang quá tải hay bị lãng phí.
Case study Pattern AI sử dụng Opik để benchmark performance-per-dollar giữa các model và xác nhận một model rẻ hơn vẫn đạt ngưỡng chất lượng, giúp tiết kiệm khoảng 60.000 USD mỗi năm mà không làm giảm chất lượng đầu ra. Bài học không phải là luôn chọn model rẻ nhất, mà là cần có ngưỡng chất lượng rõ ràng và so sánh theo tác vụ thật. Giá token hoặc giá GPU chỉ là một phần của tổng chi phí sở hữu.

Đánh giá online: hallucination, relevance, faithfulness và drift
Evaluation production nên kết hợp heuristic, model-based metric và human review. Heuristic metrics phù hợp cho JSON compliance, regex, schema, độ dài hoặc policy đơn giản. Model-based metrics hỗ trợ đánh giá hallucination, relevance, toxicity và faithfulness ở quy mô lớn, nhưng cũng cần calibration vì evaluator có thể sai. Các lĩnh vực healthcare, legal hoặc workflow rủi ro cao vẫn cần human-in-the-loop cho những quyết định có hậu quả đáng kể.
Drift không chỉ là model đổi phiên bản. Dữ liệu người dùng, tài liệu nội bộ, hành vi truy vấn, tool output và phân phối ngôn ngữ cũng có thể thay đổi. Vì vậy, hãy lấy mẫu production có kiểm soát, so sánh với baseline, thu thập feedback có cấu trúc và chuyển lỗi quan trọng vào regression set. Hệ thống tốt là hệ thống ngày càng khó lặp lại lỗi đã biết.
Tối ưu chi phí inference mà không hy sinh chất lượng
Tối ưu chi phí không nên bắt đầu bằng việc giảm chất lượng model một cách mù quáng. Thứ tự đúng là xác định tác vụ nào thật sự cần model mạnh, phần nào có thể cache, prompt nào dư thừa, request nào có thể batch và lỗi nào đang gây retry. Mục tiêu là giảm cost per successful task trong khi vẫn bảo vệ quality floor. Nếu một model rẻ hơn làm tăng tỷ lệ escalation hoặc tạo câu trả lời thiếu tin cậy, chi phí thật có thể tăng.
Model routing, model nhỏ chuyên biệt và knowledge distillation
Model routing phân tầng workload theo độ khó và rủi ro. Các tác vụ như phân loại, trích xuất thuộc tính, chuẩn hóa cấu trúc hoặc tóm tắt theo template có thể không cần frontier model. ZenML ghi nhận Mercari giảm 95% kích thước model và đạt chi phí thấp hơn 14 lần so với GPT-3.5-turbo cho dynamic attribute extraction nhờ quantization. LinkedIn đạt giảm 80% kích thước model qua knowledge distillation. Các ví dụ này nhấn mạnh giá trị của việc tối ưu theo nhiệm vụ, không phải chạy một model lớn cho mọi request.
Deepgram cho thấy một model chuyên biệt khoảng 500 triệu tham số, fine-tune trên transcript call center, có thể vượt model general-purpose lớn hơn trong conversation continuation và summarization. Khi domain ổn định, model nhỏ được fine-tune hoặc distill có thể cải thiện đồng thời privacy, latency và cost. Ngược lại, tác vụ suy luận mở, long-tail knowledge hoặc xử lý ngoại lệ phức tạp có thể cần route lên model mạnh hơn.
Quantization, GGUF và cách kiểm tra trade-off giữa VRAM, latency và quality
Quantization giảm footprint bộ nhớ và có thể giúp triển khai model trên phần cứng rẻ hơn, nhưng không có mức bit nào “an toàn” cho mọi use case. Đánh giá phải so sánh bản gốc với từng bản quantized trên cùng prompt set, cùng temperature và cùng output constraints. Theo dõi accuracy tác vụ, faithfulness, multilingual behavior, format compliance, lỗi tool calling và latency. Nếu sản phẩm yêu cầu JSON chặt chẽ, chỉ đánh giá fluency là không đủ.
Databricks được ZenML dẫn lại như ví dụ tối ưu model cho GPU A10, đạt giảm khoảng 10 lần chi phí inference trong hệ thống tạo tài liệu. Điều cần rút ra là tối ưu phải xét toàn bộ tổ hợp model, hardware, runtime, batch profile và workload. Một cấu hình tốt trên A10 không mặc nhiên tốt trên GPU khác, CPU hay môi trường có yêu cầu latency streaming nghiêm ngặt.
Caching, batching, prompt compression và tối ưu token budget
Caching nhiều tầng là một trong các đòn bẩy thực dụng nhất. Dropbox dùng caching cho embeddings, intermediate results và final outputs; Bito dùng caching trong orchestration multi-LLM để quản lý API rate limit và giảm latency. Semantic cache phù hợp với câu hỏi gần tương đương, nhưng cần ngưỡng similarity, TTL, tenant isolation và cơ chế tránh trả lời cũ khi dữ liệu nguồn đã thay đổi. Cache không nên trở thành nguyên nhân làm người dùng nhận thông tin lỗi thời.
- Embedding cache: Tránh tạo lại vector cho dữ liệu hoặc query lặp lại.
- Intermediate cache: Lưu retrieval, reranking hoặc tool result có tính tái sử dụng an toàn.
- Final-output cache: Phù hợp FAQ hoặc tác vụ xác định rõ, cần kiểm soát freshness và phân quyền.
- Batching: Tốt cho embedding và inference quy mô lớn nhưng có thể tăng latency của request đơn lẻ.
- Prompt budget: Loại context không liên quan, nén instruction và giới hạn output theo mục tiêu tác vụ.
Rate limit và reliability: bảo vệ hệ thống khỏi traffic burst
LLM service dễ bị ảnh hưởng bởi traffic burst vì mỗi request có chi phí biến thiên theo token và thời gian sinh. Một request dài có thể chiếm KV cache, GPU time hoặc quota đáng kể hơn nhiều request ngắn. Vì vậy, rate limit nên áp dụng theo API key, tenant, model route, request count và token budget, thay vì chỉ giới hạn số request mỗi phút. Tenant trả phí cao, workload nội bộ quan trọng và luồng background batch có thể cần chính sách khác nhau.
Queue, timeout, retry exponential backoff và circuit breaker
Queue giúp hấp thụ burst nhưng không phải nơi để che giấu thiếu capacity. Hệ thống cần giới hạn queue depth, thời gian chờ và ưu tiên request. Timeout phải phù hợp từng tầng: retrieval, generation, tool call và toàn bộ workflow. Retry cần exponential backoff, jitter và điều kiện rõ ràng; retry một lỗi do prompt quá dài hoặc quota cạn sẽ chỉ làm sự cố nặng hơn. Circuit breaker nên ngắt tạm thời upstream đang lỗi để tránh lan truyền failure vào toàn bộ agent chain.
Graceful degradation là một phần của UX. Khi model mạnh quá tải, router có thể chuyển sang model fallback cho tác vụ đơn giản, giảm max output token, tắt tool không thiết yếu, trả về kết quả cached được gắn trạng thái phù hợp hoặc yêu cầu người dùng thử lại. Tuy nhiên, với quyết định rủi ro cao, “trả lời đơn giản hơn” có thể không an toàn; chính sách fallback phải được thiết kế theo mức độ hậu quả chứ không chỉ theo mục tiêu availability.
- Admission control: Từ chối hoặc xếp hàng request vượt quota trước khi chúng làm cạn tài nguyên chung.
- Priority queue: Bảo vệ luồng quan trọng trước batch job hoặc tenant gây tải lớn.
- Circuit breaker: Ngắt dependency lỗi liên tục, trả fallback có kiểm soát và cảnh báo vận hành.
- Fallback model: Chỉ dùng khi đã Eval rõ phạm vi tác vụ model thay thế có thể xử lý an toàn.
Hệ thống LLM đáng tin không cố trả lời mọi thứ bằng mọi giá; nó biết giới hạn, biết giảm cấp có kiểm soát và biết khi nào cần dừng.
Khung quyết định triển khai LLMOps cho doanh nghiệp
Quyết định giữa API cloud, vLLM hoặc GGUF không nên được đưa ra từ một benchmark công khai hay giá GPU trong một thời điểm. Hãy bắt đầu bằng workload: số request đồng thời, phân phối token, yêu cầu streaming, data residency, mức độ nhạy cảm dữ liệu, SLO latency, nhu cầu model frontier, đội ngũ vận hành và ngân sách. Sau đó xây dựng một benchmark đại diện, thiết lập quality floor, đo cost per successful task và thử nghiệm canary. Đây là con đường thực tế để biến lựa chọn hạ tầng thành quyết định kinh doanh có dữ liệu.
BenchSci kết hợp knowledge base biomedical với Med-PaLM, tăng 40% năng suất nhà khoa học và rút ngắn xử lý từ vài tháng xuống vài ngày. Giá trị của ví dụ không nằm ở việc sao chép stack công nghệ, mà ở cách liên kết model với dữ liệu chuyên ngành, workflow cụ thể và metric nghiệp vụ. Một LLMOps trưởng thành phải đo được không chỉ latency hay token, mà cả kết quả cuối cùng mà người dùng và doanh nghiệp nhận được.
- Bước 1: Xác định tác vụ, rủi ro, dữ liệu, SLO và quality floor trước khi chọn runtime.
- Bước 2: Version hóa model, prompt, retrieval và policy; gắn chúng với evaluation report.
- Bước 3: Benchmark API, self-hosted và hybrid trên workload đại diện thay vì demo ngắn.
- Bước 4: Triển khai observability theo trace/span và economic attribution ngay từ phiên bản đầu.
- Bước 5: Phát hành canary, đo online, đưa lỗi thực tế vào regression set và tối ưu lặp lại.
Câu hỏi thường gặp
Khi nào người mới nên chọn vLLM thay vì GGUF/llama.cpp?
Nên ưu tiên vLLM khi mục tiêu chính là serving trên GPU với nhiều request đồng thời, cần batching hiệu quả và muốn tận dụng PagedAttention để quản lý KV cache. Nên ưu tiên GGUF/llama.cpp khi cần local inference, edge deployment, private environment, phần cứng đa dạng hoặc muốn tận dụng CPU+GPU hybrid. Người mới không nên chọn chỉ vì runtime “nhanh hơn” trên mạng; hãy chạy benchmark với context length, concurrency, streaming và output format gần với sản phẩm thật.
Quantization có luôn làm giảm chất lượng model không và cần Eval thế nào?
Quantization tạo trade-off giữa footprint bộ nhớ, latency và chất lượng, nhưng mức ảnh hưởng phụ thuộc model, mức bit và tác vụ. Một bản 4-bit có thể đủ tốt cho tác vụ này nhưng không đạt yêu cầu cho tool calling, tiếng Việt chuyên ngành hoặc output JSON chặt chẽ. Eval nên có golden set đại diện, đo accuracy nhiệm vụ, faithfulness, hallucination, format compliance, latency và token throughput; sau đó so sánh từng bản quantized với baseline bằng cùng cấu hình inference.
Làm sao biết self-hosting rẻ hơn API cloud trong workload thực tế?
Không so sánh đơn thuần giá GPU với giá token. Hãy tính tổng chi phí sở hữu: GPU, hạ tầng, storage, networking, engineering, observability, on-call, autoscaling, capacity nhàn rỗi, model loading, downtime và chi phí chất lượng thấp. Đối chiếu con số đó với chi phí API dựa trên phân phối input/output tokens, retry, cache hit rate và tăng trưởng traffic. Metric tốt là cost per successful task, kết hợp với SLO latency, availability và quality floor.
Monitoring truyền thống có đủ cho ứng dụng LLM không?
Không đủ. Monitoring truyền thống vẫn cần để theo dõi CPU, GPU, memory, network, pod health và error rate, nhưng không lý giải được hallucination hoặc context sai. LLMOps cần trace theo root request, retrieval span, generation span và tool span; đồng thời gắn telemetry với evaluation cho relevance, faithfulness, toxicity và compliance. Khi chất lượng giảm, đội ngũ phải truy ra nguyên nhân thuộc prompt, retriever, model, tool hay routing thay vì chỉ biết latency tăng.
Nguồn tham khảo: LLMOps Deployment cho người mới: Từ Model đến Production với vLLM, GGUF, Monitoring và tối ưu chi phí
Bài viết là góc nhìn cá nhân của tác giả, mang tính tham khảo — không phải tin tức báo chí.
📬 Nhận bài viết mới — miễn phí
Đừng bỏ lỡ bài viết tiếp theo. Đăng ký để nhận trong inbox.

Tác giả
Cường Nguyễn — AI Thực Chiến
Tôi là Cường Nguyễn - Founder của AI Ops Solutions.
Tôi từng là Logistics Operations Manager và đồng sáng lập thương hiệu CATCA - #1 Shopee ngành Pet Care.
10 năm kinh nghiệm Logistics/E-commerce OperationsCo-founder CATCA - #1 Shopee ngành Pet CareMột trong 300+ n8n Verified Creator toàn cầuTư vấn Giải pháp chuyển đổi số bằng AI cho 3 SMEs/quý


